<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title><![CDATA[SatanWoo]]></title>
  
  <link href="/atom.xml" rel="self"/>
  <link href="http://satanwoo.github.io/"/>
  <updated>2020-08-29T08:30:46.128Z</updated>
  <id>http://satanwoo.github.io/</id>
  
  <author>
    <name><![CDATA[SatanWoo]]></name>
    
  </author>
  
  <generator uri="http://hexo.io/">Hexo</generator>
  
  <entry>
    <title><![CDATA[Pybind11 理解]]></title>
    <link href="http://satanwoo.github.io/2020/08/29/Pybind11/"/>
    <id>http://satanwoo.github.io/2020/08/29/Pybind11/</id>
    <published>2020-08-29T08:11:40.000Z</published>
    <updated>2020-08-29T08:30:46.128Z</updated>
    <content type="html"><![CDATA[<h2 id="Pybind11_源码分析">Pybind11 源码分析</h2><p>MNN 社区上提供了通过 Python 使用 MNN 的方式，具体可以见：</p>
<p><a href="https://github.com/alibaba/MNN/tree/master/pymnn/src" target="_blank" rel="external">https://github.com/alibaba/MNN/tree/master/pymnn/src</a></p>
<p>我们通过 Pybind11 来提供比较优雅的桥接方式。由于 Pybind 11 是一层抽象 C++ 到 Python 桥接的库，上层封装了很多难以理解的细节和流程，本文就带大家抽丝剥茧一下。</p>
<p>关于 Python 桥接，如果你不是很了解，那么在阅读本文之前，请记住如下两句话：</p>
<ul>
<li><p>代码必须要以传统的 module 添加类的方式来进行，相关代码是：</p>
<ul>
<li>PyInitModule    </li>
<li>PyModule_AddObject(xxx)</li>
</ul>
</li>
<li><p><strong>Python 没办法直接编写 C++ Extension，都是通过再包一层 C 方法 （Python 自身的 C 接口）的方式来进行。</strong></p>
</li>
</ul>
<p><b style="color:red">换句话说，不管什么，都需要以一个 module 为载体，且需要name</b></p>
<h4 id="创建模块方法">创建模块方法</h4><p>因此我们的入口就在 <code>PYBIND11_MODULE(name, variable)</code></p>
<p>全部的宏就是：</p>
<p><code>#define PYBIND11_MODULE(name, variable)                                        \
    【1】static void PYBIND11_CONCAT(pybind11_init_, name)(pybind11::module &amp;);     \
    【2】PYBIND11_PLUGIN_IMPL(name) {                                               \
    【3】PYBIND11_CHECK_PYTHON_VERSION                                          \
        auto m = pybind11::module(PYBIND11_TOSTRING(name));                    \
        try {                                                                  \
            PYBIND11_CONCAT(pybind11_init_, name)(m);                          \
            return m.ptr();                                                    \
        } PYBIND11_CATCH_INIT_EXCEPTIONS                                       \
    }                                                                          \
    void PYBIND11_CONCAT(pybind11_init_, name)(pybind11::module &amp;variable)</code></p>
<p>比较晦涩，我们以 <code>mnn</code> 来举例，帮宏全部展开来探索下。</p>
<ul>
<li><p>首先声明一个函数 <code>static void pybind11_init_mnn(pybind11::module &amp;);</code>，在宏的最后会有实现。</p>
</li>
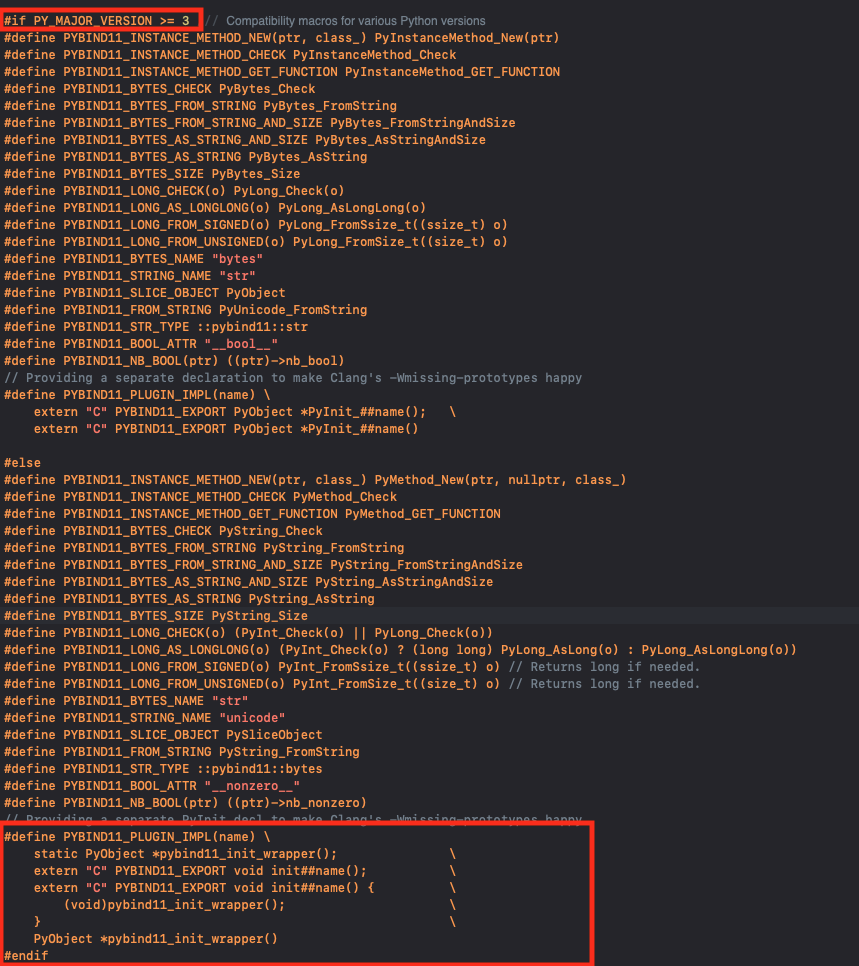
<li><p><code>PYBIND11_PLUGIN_IMPL(mnn)</code>这一步是<b style="color:red">必要的一步</b>，所有 Python 的扩展模块都需要声明对应的初始化方法，用于注册被调用。</p>
<p>   <code>import mnn</code> 就会调用 <code>init_mnn</code> 这样的方法。</p>
<p>   <img src="https://i.loli.net/2020/08/29/6UwCRG35BAa1FJg.png" alt="截屏2020-07-27 下午5.33.02.png"></p>
</li>
<li><p><code>initmnn</code> 里面定义了 <code>pybind11_init_wrapper</code> 这是真正的初始化实现。(注意 static 声明)</p>
</li>
<li><p><code>pybind11_init_wrapper</code> 里面真正的实现分为几步：</p>
<ul>
<li><p>构造一个 <code>module</code> 对象（class module），<code>auto m = pybind11::module(PYBIND11_TOSTRING(name));</code></p>
</li>
<li><p>调用之前声明的 <code>pybind11_init_mnn</code> 函数，传入module对象，仿造 Python C Extension 的方式来添加方法、定义、变量等。 <code>pybind11_init_mnn(m)</code></p>
</li>
<li><p>实现 <code>pybind11_init_mnn {xxx}</code></p>
</li>
</ul>
</li>
</ul>
<ul>
<li><p>所以一切核心的关键就是在 <code>class module</code>，抛开繁杂的东西：</p>
<ul>
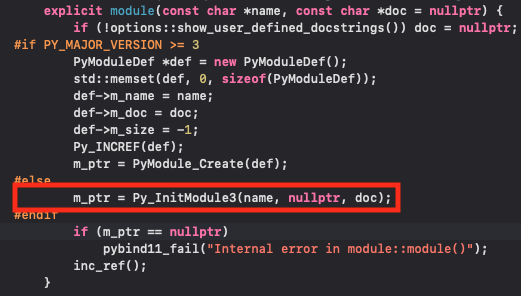
<li><p>第一步，创建一个 CPython 中的 module object，见：</p>
<p>  <img src="https://i.loli.net/2020/08/29/LAt85S1sGN2lbwa.png" alt="截屏2020-07-27 下午6.14.57.png"></p>
<blockquote>
<p>所以，本质上无论 Pybind11 在干什么，都是利用 CPython 底层的技术在那里操作。</p>
</blockquote>
</li>
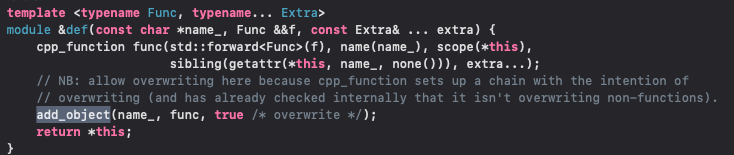
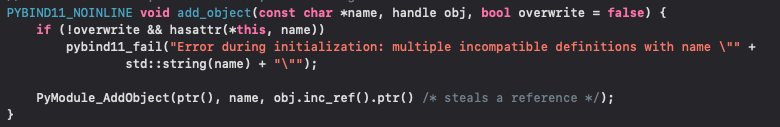
<li><p>把对应的方法加入到这个 CPython Module 中，如下：</p>
<p> <img src="https://i.loli.net/2020/08/29/Ra9f4AQZFyUBGLK.png" alt="截屏2020-07-27 下午6.17.23.png"></p>
<p><img src="https://i.loli.net/2020/08/29/esALNBJvlYZTrI9.png" alt="截屏2020-07-27 下午6.17.30.png"></p>
</li>
</ul>
</li>
</ul>
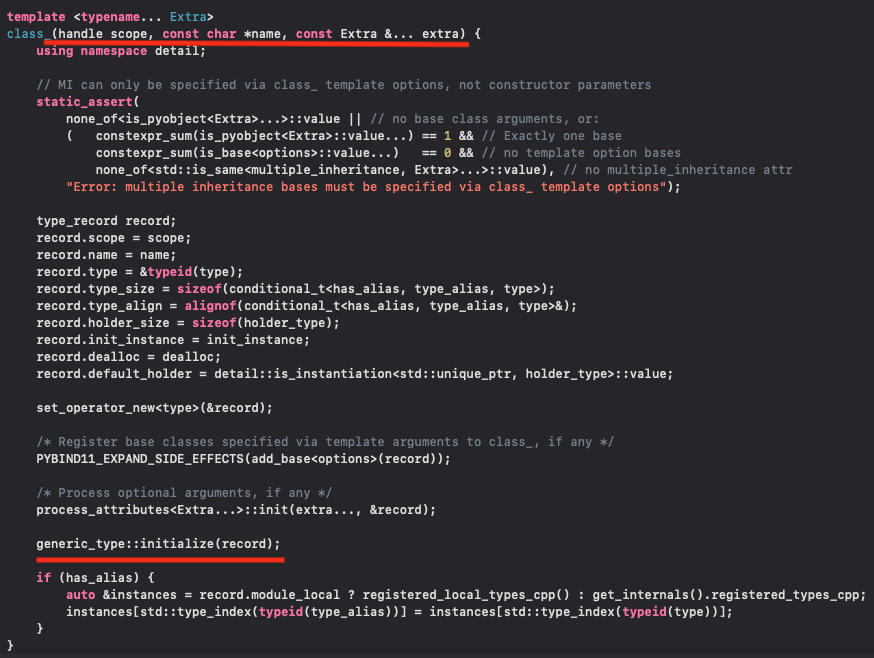
<h4 id="创建类">创建类</h4><p>创建类的方法相对难一点，但是也不难理解，我们还是找到根源 <code>class class_</code>（其实一切只要理解 Pybind11 是用 C++ 去模拟 CPython 的流程就行了）</p>
<p>找到对应的构造函数，首先从函数签名上我们就能窥探一些东西：</p>
<p><img src="https://i.loli.net/2020/08/29/7aI8ueLdsU4TSQF.png" alt="截屏2020-07-27 下午6.38.07.png"></p>
<ul>
<li><code>scope</code> 对应类所属的模块。</li>
<li><code>name</code> 就是类名。</li>
<li><code>Extra</code> 就是 C++ 模版机制对应的真正类。</li>
</ul>
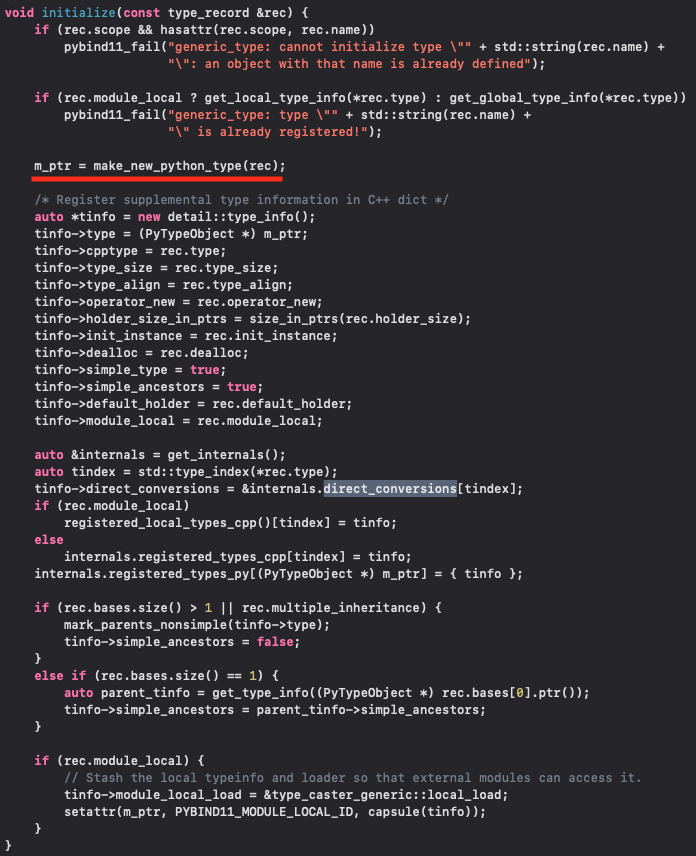
<p>看起来上面和对应的 Python 类型初始化没关系，来看看是不是 <code>generic_type::initialize</code> 造成的。</p>
<p><img src="https://i.loli.net/2020/08/29/EUHGocJPgsIrtK3.png" alt="截屏2020-07-27 下午6.44.13.png"></p>
<ul>
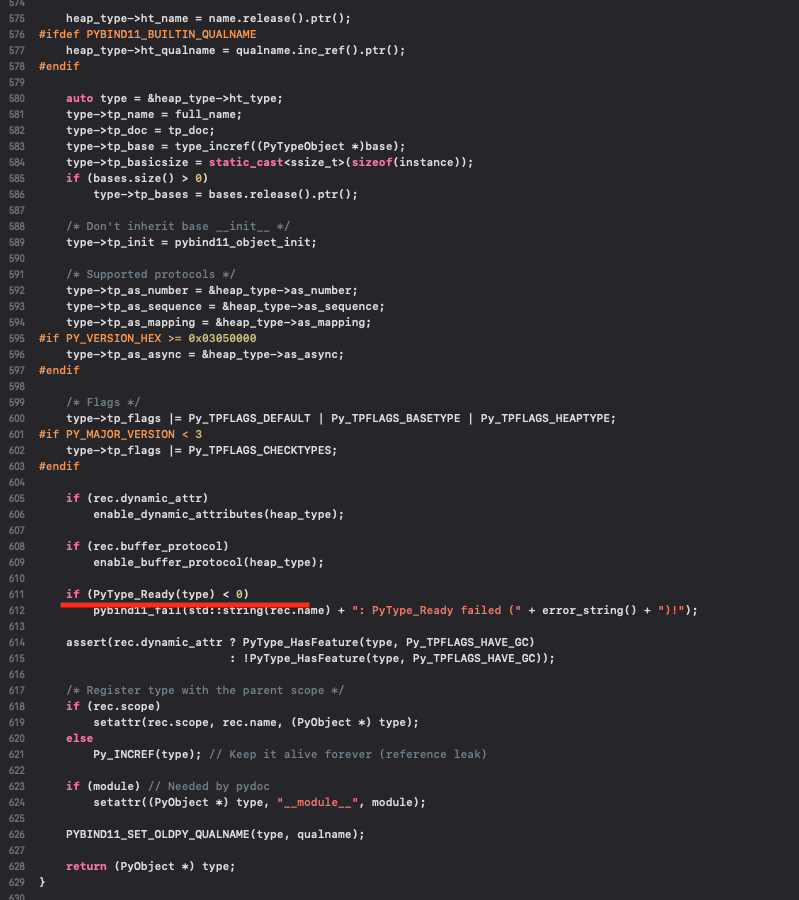
<li><code>make_new_python_type</code> 这名字一看就很符合，哈哈，点进去一看，果然是类型初始化流程。</li>
</ul>
<p><img src="https://i.loli.net/2020/08/29/boCLRWI8y4QTlxE.png" alt="截屏2020-07-27 下午6.46.15.png"></p>
<h3 id="结论：">结论：</h3><p>简要概括下添加方法的实现。</p>
<ul>
<li><p>生成模版化的初始化模块方法，即 Wrapper 方法。</p>
</li>
<li><p>提供一个仿造 <code>Python Module</code> 对象（便于 <code>C++</code> 编写 / 使用智能指针管理引用计数），在对应的自定义函数里面添加对应 <code>Module</code> 的实现。</p>
</li>
</ul>
]]></content>
    <summary type="html">
    <![CDATA[<h2 id="Pybind11_源码分析">Pybind11 源码分析</h2><p>MNN 社区上提供了通过 Python 使用 MNN 的方式，具体可以见：</p>
<p><a href="https://github.com/alibaba/MNN/tree/master]]>
    </summary>
    
      <category term="Python" scheme="http://satanwoo.github.io/tags/Python/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[TrampolineHook - 解决栈污染问题支持变参 Hook]]></title>
    <link href="http://satanwoo.github.io/2020/05/18/TrampolineHookStack/"/>
    <id>http://satanwoo.github.io/2020/05/18/TrampolineHookStack/</id>
    <published>2020-05-17T17:27:45.000Z</published>
    <updated>2020-05-24T11:27:58.096Z</updated>
    <content type="html"><![CDATA[<p>在之前的文章<a href="http://satanwoo.github.io/2020/04/26/TrampolineHookOpenSource/">《基于桥的全量方法 Hook 方案（3）- TrampolineHook》</a> 的文末，我说如果对汇编熟悉的同学可能会发现我之前实现的一个错误 - <b style="color:red">关于上下文污染</b></p>
<p>一提到到上下文污染，可能我们绝大多数人想到的都是<b style="color:red">寄存器污染</b>，但是实际上还有一个不容我们忽视的上下文资源：<strong>栈</strong>，过去可能大家常见的 Hook 代码关注比较少，正好这次在借助 TrampolineHook 修复这个方面的问题，我们来一起探讨下。</p>
<h3 id="先看一个例子">先看一个例子</h3><p>假设有这样一个类 <code>TestObject</code>和 不定参函数 <code>method</code>，定义如下：</p>
<pre><code>@interface <span class="type">TestObject</span> : <span class="type">NSObject</span>
@<span class="keyword">end</span>

@implementation <span class="type">TestObject</span>

- (void)<span class="keyword">method</span>:(<span class="built_in">int</span> *)<span class="keyword">value</span>,...
{
     va_list <span class="built_in">list</span>;
    va_start(<span class="built_in">list</span>, <span class="keyword">value</span>);

    <span class="keyword">while</span> (<span class="keyword">value</span>) {
        <span class="type">NSLog</span>(@<span class="string">"orig value is %d"</span>, *<span class="keyword">value</span>);
        <span class="keyword">value</span> = va_arg(<span class="built_in">list</span>, <span class="built_in">int</span> *);
    }
    va_end(<span class="built_in">list</span>);
}

@<span class="keyword">end</span>
</code></pre><p>如果要使用 <code>TrampolineHook</code> 来拦截 <code>method</code> 的调用，也非常简单。如下所示：</p>
<pre><code><span class="type">THInterceptor</span> *sharedInterceptor = [<span class="type">THInterceptor</span> sharedInterceptorWithFunction:(<span class="type">IMP</span>)wzq_check_variadic];

<span class="type">Method</span> m = class_getInstanceMethod([<span class="type">TestObject</span> class], @selector(<span class="keyword">method</span>:));
<span class="type">IMP</span> imp = method_getImplementation(m);

<span class="type">THInterceptorResult</span> *<span class="literal">result</span> = [sharedInterceptor interceptFunction:(<span class="type">IMP</span>)imp];
<span class="keyword">if</span> (<span class="literal">result</span>.state == <span class="type">THInterceptStateSuccess</span>) {
    method_setImplementation(m, (<span class="type">IMP</span>)<span class="literal">result</span>.replacedAddress);
}

// 拦截函数
<span class="type">void</span> wzq_check_variadic(id a, <span class="type">char</span> * methodName, <span class="type">int</span> *v, ...)
{
        <span class="type">NSLog</span>(@<span class="string">"haha checked %@ %s"</span>, a, methodName);
}
</code></pre><p>当我们使用如下方式调用 <code>-[TestObject method:]</code> 的时候，<b style="color:red">你会发现一切正常，毫无问题。</b></p>
<pre><code><span class="type">TestObject</span> *obj = [[<span class="type">TestObject</span> alloc] init];
<span class="type">int</span> a = <span class="number">0</span>;
<span class="type">int</span> b = <span class="number">1</span>;
<span class="type">int</span> c = <span class="number">2</span>;
<span class="type">int</span> d = <span class="number">3</span>;
<span class="type">int</span> e = <span class="number">4</span>;
<span class="type">int</span> f = <span class="number">5</span>;
<span class="type">int</span> g = <span class="number">6</span>;
<span class="type">int</span> h = <span class="number">7</span>;
<span class="type">int</span> i = <span class="number">8</span>;
[obj <span class="keyword">method</span>:&amp;a, &amp;b, &amp;c, &amp;d, &amp;e, &amp;f, &amp;g, &amp;h, &amp;i, <span class="keyword">nil</span>];
</code></pre><p>但是如果你将拦截函数中添加打印参数的语句后，如下所示：</p>
<pre><code><span class="keyword">void</span> wzq_check_variadic(<span class="keyword">id</span> a, <span class="keyword">char</span> * methodName, <span class="keyword">int</span> *v, ...)
{
    <span class="built_in">NSLog</span>(<span class="string">@"haha checked %@ %s"</span>, a, methodName);
    va_list args;
    va_start(args, v);
    <span class="keyword">while</span> (v != <span class="literal">NULL</span>) { 
        <span class="built_in">NSLog</span>(<span class="string">@"v is %d"</span>, *v);
        v = va_arg(args, <span class="keyword">int</span> *); <span class="comment">// crash </span>
    }
    va_end(args);
}
</code></pre><p><b style="color:red">你会发现出现了必现的崩溃情形，而且是必定崩溃在第二次读取变参列表中的参数的时候。</b><br>为什么添加了读取参数的代码就导致运行崩溃了？有点意思。</p>
<h3 id="了解变参的传递过程。">了解变参的传递过程。</h3><blockquote>
<p>为了避免优化的干扰，如下汇编生成的优化选项为 <code>-O0</code></p>
</blockquote>
<p>为了看运行时的栈结构是如何生成的，我们通过汇编结合图的形式来一探究竟没 Hook 的时候的调用情况。</p>
<p>首先先看 Caller 函数，即 <code>[obj method:&amp;a, &amp;b, &amp;c, &amp;d, &amp;e, &amp;f, &amp;g, &amp;h, &amp;i, nil];</code> 这段代码所处的函数，汇编如下：</p>
<pre><code> <span class="comment">// prologue</span>
<span class="number">0x1009dc428</span> &lt;+<span class="number">0</span>&gt;:   sub    sp, sp, <span class="preprocessor">#<span class="number">0xb0</span>             ; =<span class="number">0xb0</span> </span>
<span class="number">0x1009dc42c</span> &lt;+<span class="number">4</span>&gt;:   stp    x29, x30, [sp, <span class="preprocessor">#<span class="number">0xa0</span>]</span>
<span class="number">0x1009dc430</span> &lt;+<span class="number">8</span>&gt;:   add    x29, sp, <span class="preprocessor">#<span class="number">0xa0</span>            ; =<span class="number">0xa0</span> </span>

<span class="comment">// 构造 int 变量 0 - 8</span>
<span class="number">0x1009dc498</span> &lt;+<span class="number">112</span>&gt;: stur   wzr, [x29, <span class="preprocessor">#-<span class="number">0x2c</span>]</span>
<span class="number">0x1009dc49c</span> &lt;+<span class="number">116</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x1</span></span>
<span class="number">0x1009dc4a0</span> &lt;+<span class="number">120</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x30</span>]</span>
<span class="number">0x1009dc4a4</span> &lt;+<span class="number">124</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x2</span></span>
<span class="number">0x1009dc4a8</span> &lt;+<span class="number">128</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x34</span>]</span>
<span class="number">0x1009dc4ac</span> &lt;+<span class="number">132</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x3</span></span>
<span class="number">0x1009dc4b0</span> &lt;+<span class="number">136</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x38</span>]</span>
<span class="number">0x1009dc4b4</span> &lt;+<span class="number">140</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x4</span></span>
<span class="number">0x1009dc4b8</span> &lt;+<span class="number">144</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x3c</span>]</span>
<span class="number">0x1009dc4bc</span> &lt;+<span class="number">148</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x5</span></span>
<span class="number">0x1009dc4c0</span> &lt;+<span class="number">152</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x40</span>]</span>
<span class="number">0x1009dc4c4</span> &lt;+<span class="number">156</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x6</span></span>
<span class="number">0x1009dc4c8</span> &lt;+<span class="number">160</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x44</span>]</span>
<span class="number">0x1009dc4cc</span> &lt;+<span class="number">164</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x7</span></span>
<span class="number">0x1009dc4d0</span> &lt;+<span class="number">168</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x48</span>]</span>
<span class="number">0x1009dc4d4</span> &lt;+<span class="number">172</span>&gt;: mov    w11, <span class="preprocessor">#<span class="number">0x8</span></span>
<span class="number">0x1009dc4d8</span> &lt;+<span class="number">176</span>&gt;: stur   w11, [x29, <span class="preprocessor">#-<span class="number">0x4c</span>]</span>
<span class="number">0x1009dc4dc</span> &lt;+<span class="number">180</span>&gt;: ldur   x9, [x29, <span class="preprocessor">#-<span class="number">0x28</span>]</span>
<span class="number">0x1009dc4e0</span> &lt;+<span class="number">184</span>&gt;: ldr    x1, [x8]
<span class="number">0x1009dc4e4</span> &lt;+<span class="number">188</span>&gt;: mov    x8, sp
<span class="number">0x1009dc4e8</span> &lt;+<span class="number">192</span>&gt;: mov    x10, <span class="preprocessor">#<span class="number">0x0</span></span>

<span class="comment">// 把对应 int 变量的地址存入栈中 </span>
<span class="number">0x1009dc4ec</span> &lt;+<span class="number">196</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x40</span>]</span>
<span class="number">0x1009dc4f0</span> &lt;+<span class="number">200</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x4c</span>           ; =<span class="number">0x4c</span> </span>
<span class="number">0x1009dc4f4</span> &lt;+<span class="number">204</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x38</span>]</span>
<span class="number">0x1009dc4f8</span> &lt;+<span class="number">208</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x48</span>           ; =<span class="number">0x48</span> </span>
<span class="number">0x1009dc4fc</span> &lt;+<span class="number">212</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x30</span>]</span>
<span class="number">0x1009dc500</span> &lt;+<span class="number">216</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x44</span>           ; =<span class="number">0x44</span> </span>
<span class="number">0x1009dc504</span> &lt;+<span class="number">220</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x28</span>]</span>
<span class="number">0x1009dc508</span> &lt;+<span class="number">224</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x40</span>           ; =<span class="number">0x40</span> </span>
<span class="number">0x1009dc50c</span> &lt;+<span class="number">228</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x20</span>]</span>
<span class="number">0x1009dc510</span> &lt;+<span class="number">232</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x3c</span>           ; =<span class="number">0x3c</span> </span>
<span class="number">0x1009dc514</span> &lt;+<span class="number">236</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x18</span>]</span>
<span class="number">0x1009dc518</span> &lt;+<span class="number">240</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x38</span>           ; =<span class="number">0x38</span> </span>
<span class="number">0x1009dc51c</span> &lt;+<span class="number">244</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x10</span>]</span>
<span class="number">0x1009dc520</span> &lt;+<span class="number">248</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x34</span>           ; =<span class="number">0x34</span> </span>
<span class="number">0x1009dc524</span> &lt;+<span class="number">252</span>&gt;: str    x10, [x8, <span class="preprocessor">#<span class="number">0x8</span>]</span>
<span class="number">0x1009dc528</span> &lt;+<span class="number">256</span>&gt;: sub    x10, x29, <span class="preprocessor">#<span class="number">0x30</span>           ; =<span class="number">0x30</span> </span>
<span class="number">0x1009dc52c</span> &lt;+<span class="number">260</span>&gt;: str    x10, [x8]

 <span class="comment">// 其余参数 x0, x1, x2</span>
<span class="number">0x1009dc530</span> &lt;+<span class="number">264</span>&gt;: sub    x2, x29, <span class="preprocessor">#<span class="number">0x2c</span>            ; =<span class="number">0x2c</span> </span>
<span class="number">0x1009dc534</span> &lt;+<span class="number">268</span>&gt;: mov    x0, x9

<span class="comment">// 调用 method 函数</span>
<span class="number">0x1009dc538</span> &lt;+<span class="number">272</span>&gt;: bl     <span class="number">0x1009e8d9c</span>               ; symbol stub <span class="keyword">for</span>: objc_msgSend
</code></pre><p>上述这段函数，简要而言，就是干了四件事：</p>
<ul>
<li><p>分配 176 byte 的栈内存</p>
</li>
<li><p>在栈上分配 a = 0, b = 1 等等 9 个变量</p>
</li>
<li><p>把 &amp;b, &amp;c 等 8个 int 变量的地址压栈。</p>
</li>
<li><p>x0 (obj), x1 (method), x2(&amp;a) </p>
</li>
</ul>
<p><b style="color:red">特别注意，变参列表的第一个参数也是通过寄存器来传递。</b></p>
<ul>
<li>调用 method 函数</li>
</ul>
<p>如果不理解, 可以参考这张图：</p>
<p><img src="https://upload-images.jianshu.io/upload_images/4292627-35ce3b243cc8e2bf.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p>而当进入 <code>method:</code> 函数时，汇编如下：</p>
<p><img src="https://upload-images.jianshu.io/upload_images/4292627-6420b181488d73f5.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p><b style="color:red">重点看两行蓝色汇编断点的地方，其实是在暗示一种循环，也从底层实现上对应上了我们不断循环获取变参列表的逻辑。</b></p>
<p>简要来说，就是从变参列表的第一参数（寄存器中的值代表地址），开始读取，循环遍历。这里的循环利用了栈空间在函数调用间的连续性，不断将偏移地址从原来 caller 函数的 sp 回溯，读取处于高地址的 caller 栈空间中的 int 变量地址。</p>
<p><img src="https://upload-images.jianshu.io/upload_images/4292627-78690d2c7c2ef001.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p>看到这，我想大家也知道了<b style="color:red">为什么是必定崩溃在第二次读取变参的时候。</b></p>
<ul>
<li><p>x0, x1 不用说，是寄存器参数。和变参不变参函数无关，这也能解释为什么只读取 id obj 和 SEL selector 不会崩溃。</p>
</li>
<li><p>x2，即变参函数列表的第一个参数，我这里把他称为变参的<b style="color:red">锚点参数</b>，它也是通过寄存器传递，所以读取的时候没问题。</p>
</li>
<li><p>变参列表的后续参数都是分配在调用函数（caller）中，而 TrampolineHook 在调用 interceptor 之前利用了栈（操作 SP）来保存上下文，如下所示，<b style="color:red">因此破坏了栈资源上下文，导致循环从栈地址获取参数的时候崩溃</b></p>
<pre><code><span class="label">stp</span> <span class="literal">q0</span>,  <span class="literal">q1</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">q2</span>,  <span class="literal">q3</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">q4</span>,  <span class="literal">q5</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">q6</span>,  <span class="literal">q7</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">lr</span>,  x10,  [<span class="literal">sp</span>, #-<span class="number">16</span>]!
<span class="label">stp</span> x0,  x1,   [<span class="literal">sp</span>, #-<span class="number">16</span>]!
</code></pre></li>
<li><p>而调用原函数的时候，<b style="color:red">由于栈已经复原了，所以就不会出现崩溃了。</b></p>
</li>
</ul>
<h3 id="解决方案">解决方案</h3><p>了解了问题出现的原因，解决办法就很简单了，我们要让调用 inteceptor 时候的上下文和调用原函数一样。</p>
<ul>
<li><p>还是构造一堆的动态 trampoline ，让原函数替换到 trampoline，同时保存原函数的 IMP。</p>
</li>
<li><p>依然保存原先需要的上下文，比如通用寄存器、浮点寄存器，<strong>但是不能使用栈了。</strong></p>
</li>
<li><p>调用 interceptor。</p>
</li>
<li><p>恢复上下文，调用到原函数。</p>
</li>
</ul>
<p>其实整个步骤和原先基本一样，唯一需要考虑的就是<b style="color:red">如何在一点也不用</b>栈的资源的前提下保存寄存器上下文？</p>
<p><b style="color:red">堆上。</b><br><b style="color:red">堆上。</b><br><b style="color:red">堆上。</b>  </p>
<p>简单而言，我们把上下文一股脑都保存到堆上就行。需要保存的上下文大致类似于一个结构体：</p>
<pre><code><span class="keyword">typedef</span> <span class="keyword">struct</span> _THPageVariadicContext {
    <span class="keyword">int64_t</span> gR[<span class="number">10</span>];              <span class="comment">// general registers x0-x8 + x13</span>
    <span class="keyword">int64_t</span> vR[<span class="number">16</span>];              <span class="comment">// float   registers q0-q7</span>
    <span class="keyword">int64_t</span> linkRegister;        <span class="comment">// lr</span>
    <span class="keyword">int64_t</span> originIMPRegister;   <span class="comment">// origin</span>
} THPageVariadicContext;
</code></pre><p><b style="color:red"> 当然，这里的结构体只是形象化表示内存中的数据顺序和含义，真正使用汇编操作内存的时候，没有结构体。</b></p>
<p>保存上下文解决了我们不污染栈的诉求，但是同时也引出了一个新的问题，堆分配的地址我们保存在哪？跨函数调用后恢复上下文必须要让我们分配出的堆地址得到“持久化”存储啊。</p>
<ul>
<li><p>保存到栈上？这肯定不可能，自己打自己脸嘛。</p>
</li>
<li><p>保存到寄存器上？如果是 <code>caller-saved</code> 寄存器，那不能保证跨函数调用完后，寄存器里面的内容还是我们原先设定的那样；而如果是 <code>callee-saved</code> 寄存器，确实可以解决跨函数调用后数据还原成我们保存的那样。但是同样的，我们自身也是其他 <code>caller</code> 函数的 <code>callee</code>，我们侵占了一个寄存器，怎么在返回到 <code>caller</code> 函数之前复原这个 <code>callee-saved</code> 寄存器呢？</p>
</li>
</ul>
<blockquote>
<p>上面这段话有点绕。</p>
</blockquote>
<p><b style="color:red">所以，我们在分配堆内存的时候，要多分配一个 8 byte 的空间，把侵占的 <code>callee-saved register</code> 的值保存到堆内存中，然后再继续存我们原先要保留的上下文。</b></p>
<p>关键代码简要概括如下：</p>
<ul>
<li><p>第一步，在拦截到函数调用后，先进入我们的 <code>pre</code> 操作，这里是在堆上对应上下文空间大小的地方。需要注意的是，调用分配内存的函数是使用 <code>malloc</code>，我们并不知道 <code>malloc</code> 究竟会破坏哪些寄存器，因为也需要作一次额外的寄存器上下文保存，不过这个保存时短暂的，分配结束后就恢复。然后将这些上下文都保存到堆上。</p>
<p>  <strong>attribute</strong>((<strong>naked</strong>))<br>  void THPageVariadicContextPre(void)<br>  {</p>
<pre><code><span class="comment">// 先保存，避免调用 malloc 破坏寄存器</span>
saveRegs();

<span class="comment">// 分配堆上内存 extra 16 byte + sizeof(THPageVariadicContext)</span>
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"mov x0, #0xF0"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"bl _malloc"</span>)</span></span>;

<span class="comment">// 返回的分配内存地址保存起来 callee-saved</span>
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"str x19, [x0]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"mov x19, x0"</span>)</span></span>;

<span class="comment">// 恢复堆栈，避免影响变参所处在的堆栈</span>
restoreRegs();

<span class="comment">// 用堆上空间保存数据</span>
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp x0, x1,  [x19, #(16 + 0 * 16)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp x2, x3,  [x19, #(16 + 1 * 16)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp x4, x5,  [x19, #(16 + 2 * 16)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp x6, x7,  [x19, #(16 + 3 * 16)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp x8, x13, [x19, #(16 + 4 * 16)]"</span>)</span></span>;

__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp q0, q1,  [x19, #(16 + 5 * 16 + 0 * 32)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp q2, q3,  [x19, #(16 + 5 * 16 + 1 * 32)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp q4, q5,  [x19, #(16 + 5 * 16 + 2 * 32)]"</span>)</span></span>;
__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp q6, q7,  [x19, #(16 + 5 * 16 + 3 * 32)]"</span>)</span></span>;

__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"stp lr, x10, [x19, #(16 + 5 * 16 + 4 * 32)]"</span>)</span></span>;

__<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ret"</span>)</span></span>;
</code></pre><p>  }</p>
</li>
<li><p>调用完拦截函数，我们需要销毁堆空间，由于我们之前使用的是 <code>callee-saved</code> 的寄存器，我们能确保寄存器的值还是调用之前的。所以我们放心的将其中的值取出来，然后销毁对应的占空间，然后恢复寄存器即可。</p>
<pre><code>__attribute__((__naked__))
<span class="function"><span class="keyword">void</span> <span class="title">THPageVariadicContextPost</span><span class="params">(<span class="keyword">void</span>)</span>
</span>{
    <span class="comment">// x19 肯定是正确的地址，使用x19恢复对应的数据</span>
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp lr, x10, [x19, #(16 + 5 * 16 + 4 * 32)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp q6, q7,  [x19, #(16 + 5 * 16 + 3 * 32)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp q4, q5,  [x19, #(16 + 5 * 16 + 2 * 32)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp q2, q3,  [x19, #(16 + 5 * 16 + 1 * 32)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp q0, q1,  [x19, #(16 + 5 * 16 + 0 * 32)]"</span>)</span></span>;

    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp x8, x13, [x19, #(16 + 4 * 16)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp x6, x7,  [x19, #(16 + 3 * 16)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp x4, x5,  [x19, #(16 + 2 * 16)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp x2, x3,  [x19, #(16 + 1 * 16)]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldp x0, x1,  [x19, #(16 + 0 * 16)]"</span>)</span></span>;

    <span class="comment">// 保存一下，避免 free 的影响。</span>
    saveRegs();

    <span class="comment">// 恢复原先的 x19, 调用free</span>
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"mov x0, x19"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"ldr x19, [x19]"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"bl _free"</span>)</span></span>;

    <span class="comment">// 恢复堆栈</span>
    restoreRegs();

    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"mov lr, x13"</span>)</span></span>;
    __<span class="function"><span class="keyword">asm</span> <span class="title">volatile</span> <span class="params">(<span class="string">"br x10"</span>)</span></span>;
}
</code></pre></li>
<li><p>需要注意的是，我们这里用了<code>__attribute__((__naked__))</code>，这个作用是为了让我们的函数不会额外的生成函数 <code>prologue/epilogue</code> 中的压栈消栈操作。</p>
</li>
</ul>
<p>至此，变参 <code>Hook</code> 就完成了，大家可以前往 <code>Github</code> 查看最新的 <code>THVaradicInterceptor</code> 来使用。</p>
<h3 id="后记">后记</h3><p>有的朋友会问，为什么很多网上常见的 Hook 方案，都不要这么复杂的上下文保存流程？</p>
<p><b style="color:red">其实道理很简单，保存什么上下文取决你的拦截或者 <code>Hook</code> 函数的目的以及使用方式。</b></p>
<p>举个非常常见的统计函数调用耗时的例子，在这个情形中，一般只用关注 <code>x0</code>，<code>x1</code> 两个参数 来记录是什么类什么函数的调用。这种情况下，你的上下文保存可以极简，甚至只要保存 <code>x0</code>, <code>x1</code> 即可。</p>
<p>而 <code>TrampolineHook</code> 想要提供的拦截器，是一个<strong>通用</strong>的拦截器，<b style="color:red">我不能保证其内部的实现，因为我需要保留的上下文就必须很完整。</b></p>
<p>后续 <code>TrampolineHook</code> 除了完善对 <code>x86_64</code> 的支持外，还有两个比较大的技术目标，也会慢慢完善。如果有什么使用中遇到的问题或者 <code>Bug</code> 也欢迎提交代码。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p>在之前的文章<a href="http://satanwoo.github.io/2020/04/26/TrampolineHookOpenSource/">《基于桥的全量方法 Hook 方案（3）- TrampolineHook》</a> 的文末，我说如果对汇编熟悉的同学]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
      <category term="汇编" scheme="http://satanwoo.github.io/tags/%E6%B1%87%E7%BC%96/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[基于桥的全量方法 Hook 方案（3）- TrampolineHook]]></title>
    <link href="http://satanwoo.github.io/2020/04/26/TrampolineHookOpenSource/"/>
    <id>http://satanwoo.github.io/2020/04/26/TrampolineHookOpenSource/</id>
    <published>2020-04-25T16:28:53.000Z</published>
    <updated>2020-04-26T14:48:53.632Z</updated>
    <content type="html"><![CDATA[<blockquote>
<p>本来以为是双休日，结果五一调休本周末只休一天，懵逼。不过还算完成了承诺，赶了出来。</p>
</blockquote>
<p>开源地址：<a href="https://github.com/SatanWoo/TrampolineHook" target="_blank" rel="external">https://github.com/SatanWoo/TrampolineHook</a>  </p>
<h3 id="TrampolineHook_是什么">TrampolineHook 是什么</h3><p>之前<strong>杨萧玉</strong>在看到我<a href="http://satanwoo.github.io/2020/04/22/NewBridgeHook/">《基于桥的全量方法 Hook 方案（2） - 全新升级》</a> 后就问我这个和直接用 <code>method_exchangeImplementation</code> 之类的 <code>runtime</code> 方法交换 <code>IMP</code> 性能对比咋样？</p>
<p>所以这篇文章开头先占用大家宝贵的两分钟，简要说明下。</p>
<p><code>TrampolineHook</code> 本质上不是用来 <code>Swizzling</code> 的框架，取 <code>Hook</code> 这个名字只是为了读起来顺口。<b style="color:red">它实际上是一个中心重定向框架。</b> 换句话说，你可以认为它是为了通过<strong>一个函数替换/拦截所有你想要函数的框架。</strong></p>
<p>其实这个中心重定向的思想并不新潮，很多人（包括我自己）在内就曾经利用重载 <code>objc_msgForward</code> 干过这样的事。</p>
<p>但是这个方式我在之前的文章里也提到过对应的缺点，比如：</p>
<ul>
<li>性能慢</li>
<li>不能替换/拦截同一个继承链上的多个类。</li>
</ul>
<p>所以可以认为 <code>TrampolineHook</code> 是一个让你<strong>不用关注底层架构Calling Convention（因为涉及到汇编），不用关心上下文信息保存、恢复，不用担心引入传统 Swizzle 方案在大型项目中有奇奇怪怪 Crash 问题的中心重定向框架。</strong></p>
<h3 id="TrampolineHook_技术原理">TrampolineHook 技术原理</h3><p>整个技术原理其实可以分为三部分：</p>
<ul>
<li><p><code>vm_remap</code> 技术。</p>
</li>
<li><p>流程设计。</p>
</li>
<li><p>汇编实现。</p>
</li>
</ul>
<h4 id="vm_remap_的价值">vm_remap 的价值</h4><p>通俗意义上，我们访问的内存都是按照页来组织。而在程序加载后分配的页之中，会对应有不同的权限，比如代码占用的页，就是可读且可执行，但是一般不具备可写的权限；而存放数据的页呢，就对应是可读且可写，但不能拥有可执行权限。</p>
<p><strong>在绝大多数情况下</strong>，当我们编写完一个程序运行的时候，动态分配的页都是用来做数据保存、访问的，不太会有涉及执行权限。</p>
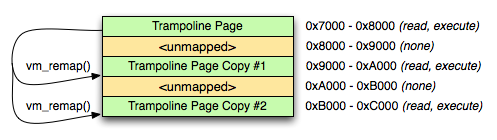
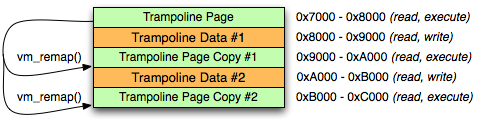
<p>而要做到可以将动态分配出来的内存页具备可执行权限，就需要利用 <code>vm_remap</code>。 它的定义是这样的：</p>
<p>On Darwin, vm_remap() provides support for mapping an existing code page at new address, while retaining the existing page protections; using vm_remap(), we can create multiple copies of existing, executable code, placed at arbitrary addresses. </p>
<p>从定义中我们可以知道两点信息：</p>
<ul>
<li><p><code>vm_remap</code> 可以让内存页具备被 map 的页的特性，如果是可执行页被 map，那新创建的页自然而然页具备了这个权限。</p>
</li>
<li><p><code>vm_remap</code> 也不是肆无忌惮的创建任何可执行的页，通俗理解，它只是一个 copy 映射。</p>
</li>
</ul>
<p><img src="https://landonf.org/static/blog/code/objc/blockimp_vm_remap.png" alt=""></p>
<p><img src="https://landonf.org/static/blog/code/objc/blockimp_vm_remap_data.png" alt=""></p>
<blockquote>
<p>上述图片引用自<a href="https://landonf.org/code/objc/imp_implementationWithBlock.20110413.html" target="_blank" rel="external">Implementing imp_implementationWithBlock()</a></p>
</blockquote>
<p>因此，我们可以通过在编写代码的过程中，<b style="color:red">精心构造、预留在程序二进制的代码页</b>，在运行时不断<strong>“复制映射”</strong>，来完成特殊的使命。</p>
<p>在我们的定义中，我们是构造了<b style="color:red">连续的两个页</b>。</p>
<h4 id="流程设计">流程设计</h4><p>要构造特殊的程序二进制代码，首先还是要梳理我们的目的，<b style="color:red">我们的诉求是所有的函数都能先进入我们的一个中心重定向函数，执行自定义的操作，然后返回原函数，同时这个调用栈不能乱。</b></p>
<ul>
<li>把一个我们要替换的原方法 IMP A 取出来，保存起来。</li>
<li>给这个原方法塞一个动态分配的可执行地址 B。</li>
<li>当执行这个原方法的时候，会跳转到 可执行地址 B。</li>
<li>这个 B 经过一段简短的运算操作，可以获取到原先保存的 IMP A。</li>
<li>在跳转回 IMP A 之前，统一拦截函数先做些事情，比如检查是不是主线程调用之类的。</li>
</ul>
<p><b style="color:red">【注意】：在整个过程中，我们要保证参数寄存器、返回地址等不能错乱。</b></p>
<h4 id="汇编实现">汇编实现</h4><p>既然 <code>vm_remap</code> 是按页的维度来映射，我们要构造的代码自然而然要<b style="color:red">页对齐</b>。<strong>在 arm64 中，一页是 0x4000，也就是 16KB</strong>，所以首先就是 <code>.align 14</code> 来确保。</p>
<p>然后上一下最关键部分的代码，感兴趣的还是去 <a href="https://github.com/SatanWoo/TrampolineHook" target="_blank" rel="external">Github</a> 上阅读完整的代码吧。</p>
<pre><code><span class="label">_th_entry</span>:

// 不要小看这五行汇编
<span class="keyword">nop
</span><span class="keyword">nop
</span>
<span class="keyword">sub </span>x12, <span class="literal">lr</span>,   <span class="number">#0x8</span>
<span class="keyword">sub </span>x12, x12,  <span class="number">#0x4000</span>
<span class="keyword">mov </span><span class="literal">lr</span>,  x13

<span class="keyword">ldr </span>x10, [x12]

<span class="label">stp</span> <span class="literal">q0</span>,  <span class="literal">q1</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">q2</span>,  <span class="literal">q3</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">q4</span>,  <span class="literal">q5</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!
<span class="label">stp</span> <span class="literal">q6</span>,  <span class="literal">q7</span>,   [<span class="literal">sp</span>, #-<span class="number">32</span>]!

<span class="label">stp</span> <span class="literal">lr</span>,  x10,  [<span class="literal">sp</span>, #-<span class="number">16</span>]!
<span class="label">stp</span> x0,  x1,   [<span class="literal">sp</span>, #-<span class="number">16</span>]!
<span class="label">stp</span> x2,  x3,   [<span class="literal">sp</span>, #-<span class="number">16</span>]!
<span class="label">stp</span> x4,  x5,   [<span class="literal">sp</span>, #-<span class="number">16</span>]!
<span class="label">stp</span> x6,  x7,   [<span class="literal">sp</span>, #-<span class="number">16</span>]!
<span class="keyword">str </span>x8,        [<span class="literal">sp</span>, #-<span class="number">16</span>]!

// 加载自定义的拦截器，并跳转过去。
<span class="keyword">ldr </span>x8,  interceptor
<span class="keyword">blr </span>x8

<span class="keyword">ldr </span>x8,        [<span class="literal">sp</span>], <span class="number">#16</span>
<span class="label">ldp</span> x6,  x7,   [<span class="literal">sp</span>], <span class="number">#16</span>
<span class="label">ldp</span> x4,  x5,   [<span class="literal">sp</span>], <span class="number">#16</span>
<span class="label">ldp</span> x2,  x3,   [<span class="literal">sp</span>], <span class="number">#16</span>
<span class="label">ldp</span> x0,  x1,   [<span class="literal">sp</span>], <span class="number">#16</span>
<span class="label">ldp</span> <span class="literal">lr</span>,  x10,  [<span class="literal">sp</span>], <span class="number">#16</span>

<span class="label">ldp</span> <span class="literal">q6</span>,  <span class="literal">q7</span>,   [<span class="literal">sp</span>], <span class="number">#32</span>
<span class="label">ldp</span> <span class="literal">q4</span>,  <span class="literal">q5</span>,   [<span class="literal">sp</span>], <span class="number">#32</span>
<span class="label">ldp</span> <span class="literal">q2</span>,  <span class="literal">q3</span>,   [<span class="literal">sp</span>], <span class="number">#32</span>
<span class="label">ldp</span> <span class="literal">q0</span>,  <span class="literal">q1</span>,   [<span class="literal">sp</span>], <span class="number">#32</span>

<span class="keyword">br </span> x10

<span class="label">.rept</span> <span class="number">2032</span>
<span class="keyword">mov </span>x13, <span class="literal">lr</span>
<span class="keyword">bl </span>_th_entry<span class="comment">;</span>
<span class="label">.endr</span>
</code></pre><p>整段汇编可以分为几个部分：</p>
<ul>
<li><p>设计一大堆的动态可执行地址，即：</p>
<pre><code><span class="label">.rept</span> <span class="number">2032</span>
<span class="keyword">mov </span>x13, <span class="literal">lr</span>
<span class="keyword">bl </span>_th_entry<span class="comment">;</span>
<span class="label">.endr</span>
</code></pre><p>这里最早我的实现是复制粘贴一大堆重复性代码，<b style="color:red">在 HookZZ 作者的指导下，我优化成了上述这样。</b></p>
</li>
<li><p>执行统一的运行过程，通过偏移计算等方式获取保留的原始 IMP。</p>
</li>
<li><p>要注意特定的寄存器用处，<code>x8-x18</code>是临时寄存器，里面的值在函数调用后可能被修改，这些寄存器为caller-saved。<b style="color:red">所以在我们自身函数可以用，但是要在调用别的函数之前保存好。</b></p>
</li>
<li><p>要特别注意对 LR 寄存器的处理，没处理好，调用栈就回不去了。</p>
</li>
<li><p>保存对应的参数、浮点参数等寄存器，避免上下文被我们自己的处理函数破坏。</p>
</li>
<li><p><code>b / bl</code> 的跳转范围非常有限，由于我们是动态地址分配，不能保证拦截函数的范围偏移，所以要采用 <code>blr</code> 的方式。</p>
</li>
</ul>
<h3 id="TrampolineHook_用处">TrampolineHook 用处</h3><p>和传统的 <code>Swizzle</code> 需要提供对应的替换后的函数实现不同，中心化重定向思想可以帮助你实现很多有意思的事情：</p>
<ul>
<li><p>比如网上很常见的 <code>hook objc_msgSend</code>，可以帮你查看任意被 Hook 二进制中的函数耗时和调用链路。</p>
</li>
<li><p>比如 <code>Bang</code> / <code>AnyMethodLog</code> 这样的重定向 Log 日志框架等等。</p>
</li>
</ul>
<p><b style="color:red">苹果著名的 <code>MainThreadChecker</code> 也用了类似的技术。由于我才疏学浅，只是大致完成了对其实现的逆向，通过 <code>TrampolineHook</code> 进行了重写。</b> 因为效果还不错，所以也开源了出来，地址是：<a href="https://github.com/SatanWoo/TrampolineHook/tree/master/Example/MainThreadChecker" target="_blank" rel="external">https://github.com/SatanWoo/TrampolineHook/tree/master/Example/MainThreadChecker</a></p>
<p>这次在重写 <code>MainThreadChecker</code> 的过程中，我也对比了下和 2017 年苹果实现的差异。在整体流程上没有比较大的差异，但是还是有一些细节可以分享分享：</p>
<ul>
<li>iOS 10 的时候对应的二进制是 <code>UIKit</code>，到了 iOS 12/13 成了 <code>UIKitCore</code>，所以原先获取二进制的逻辑失效了，为了避免后续版本的变更干扰，我采用了苹果自身的守候，通过 <code>class_getImageName([UIResponder class])</code> 来保证获取的就是我们理解上的 <code>UIKit</code> 动态库。</li>
</ul>
<p>当然 <code>TrampolineHook</code> 的作用不止于此，争取过段时间把我的一些想法做完善再和大家交流。</p>
<h3 id="后续思考">后续思考</h3><p>本质上 <code>Trampoline</code> 和 <code>vm_remap</code> 技术不是新的技术，很早就有人应用了，构造 <code>Trampoline</code> 实际上在苹果自身关于 <code>Block</code> 的实现中就有。业界也有 <code>SwiftTrace</code> 也是用了对应的技术。</p>
<p>真正的关键在于你用 <code>Trampoline</code> 做什么？用途的不同也决定了效果的不同，这也是我把之前的代码重写 <code>TrampolineHook</code> 中所收获的，而且随着 <code>TrampolineHook</code> 相对我自身之前实现的优化，我发现眼前豁然开朗，能玩的事情还有很多，哈哈。</p>
<p>对了，如果有朋友对 arm64 的汇编比较熟悉，同时对函数调用也比较了解的话，会很快的发现我上述提供的汇编代码存在一个漏洞（虽然这个漏洞绝大多数人用不到），感兴趣的朋友可以微信交流下。</p>
<p><b style="color:red">开源地址：<a href="https://github.com/SatanWoo/TrampolineHook" target="_blank" rel="external">https://github.com/SatanWoo/TrampolineHook</a> </b> 如果大家有什么想法或者遇到了自身项目中的 Bug，欢迎 issue。</p>
]]></content>
    <summary type="html">
    <![CDATA[<blockquote>
<p>本来以为是双休日，结果五一调休本周末只休一天，懵逼。不过还算完成了承诺，赶了出来。</p>
</blockquote>
<p>开源地址：<a href="https://github.com/SatanWoo/TrampolineHook" tar]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
      <category term="汇编" scheme="http://satanwoo.github.io/tags/%E6%B1%87%E7%BC%96/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[基于桥的全量方法 Hook 方案（2） - 全新升级]]></title>
    <link href="http://satanwoo.github.io/2020/04/22/NewBridgeHook/"/>
    <id>http://satanwoo.github.io/2020/04/22/NewBridgeHook/</id>
    <published>2020-04-21T16:12:51.000Z</published>
    <updated>2020-04-21T16:14:03.074Z</updated>
    <content type="html"><![CDATA[<p>如果读过我的博客的人可能知道，我在 <b style="color:red">2017</b> 年曾经研究过<b style="color:red">当时苹果出的一个新玩意 MainThread Checker</b>，并以此为基础推导了一个基于桥的全量 Hook 方案，<a href="http://satanwoo.github.io/2017/09/24/mainthreadchecker1/">基于桥的全量方法Hook方案 - 探究苹果主线程检查实现
</a> 。当时简单写了下 ARM64 的方案代码，并放在了 Github 上，不过已废弃。</p>
<p>当时觉得自己研究的还算深入，基于汇编写（其实是复制粘贴）了一大堆的桥，可以<b style="color:red">针对性</b> Hook 一个或多个二进制，比如 UIKit 的逻辑，觉得挺屌的。</p>
<p>但是使用中发现了<b style="color:red">两个巨大的问题：</b></p>
<ul>
<li>性能问题。由于我是运行时的方案，没法对二进制产物进行修改（比如编译插桩），因此如果要能达到对二进制所有方法<b style="color:red">中心重定向的效果</b>，借助了 forwarding 的流程（不是objc_msgForward）。但是这个方案懂的人肯定明白，性能巨慢。</li>
</ul>
<blockquote>
<p>不能上线的方案其实价值都不大。</p>
</blockquote>
<ul>
<li>Crash 问题。尽管我通过汇编的方式解决了中心重定向 Hook 方案上对一条继承链重复 Hook 会死循环的 Crash 问题(如果你不理解，可以回到我文章开头所提及的文章了解原因或者查看 Aspects 库中对应的 issue)， <b style="color:red">但是却出乎意料的引入了系统库新的 Crash，这个我会开一篇新的文章来分析。</b></li>
</ul>
<p>因此，当时这个方案我就抛弃了，后续也因为我不怎么搞iOS，就没深入优化。</p>
<h4 id="新的方案">新的方案</h4><p>新的方案的起源灵感来自于我隔壁组的同事，<strong>手淘架构新生代小天王谢俊逸</strong>的启发。他说你用汇编写桥，照理性能不会慢啊，你为啥要走一次 forwarding 的逻辑？</p>
<p>我回顾了下代码，发现原先我为了保留所谓的<b style="color:red">层级上下文</b>，将类名和方法名构造成了一个唯一标示，然后将这个唯一标示和一个动态生成的函数地址相绑定。然后通过这个不存在的方法名触发 forwarding 流程，然后改写成正确的方法名，从而调用正确的被 HOOK 前的函数。</p>
<blockquote>
<p>看不懂的话等我周末整理下代码开源吧。</p>
</blockquote>
<p><b style="color:red">而整个流程，也是如下两个问题的罪魁祸首。</b></p>
<ul>
<li><p>改了方法名：SEL 的修改之前是为了解决中心重定向相同继承链上的 Hook Crash 问题，但是会导致意想不到的其他 Crash 问题。</p>
</li>
<li><p>性能巨慢：走 fowarding 流程绕了一大圈。</p>
</li>
</ul>
<p>要解决上述这些问题，汇编和桥依然是不可或缺的，但是如何把所有 UIKit 的方法都中心重定向同时又能绕开继承链问题呢还能不修改 SEL 的名称呢？</p>
<p>经过和<strong>谢俊逸</strong>的讨论，我们发现，我们把原先保存 <strong>拼接后 SEL 的逻辑，换成直接保存 HOOK 之前的 函数IMP，然后通过汇编直接跳过去执行 IMP 不就完事了？</strong></p>
<p><b style="color:red">思路非常 Nice ！ 开工</b>  </p>
<h4 id="动手过程">动手过程</h4><p>想法有了，因为涉及到汇编，需要非常复杂的操作流程，简单抛砖引玉一下。</p>
<pre><code>_template_page:
sub x12, lr, <span class="preprocessor">#<span class="number">0x8</span></span>
sub x12, x12, <span class="preprocessor">#<span class="number">0x4000</span> <span class="comment">// 获取对应数据页的便宜</span></span>
mov lr, x13   <span class="comment">// 获取返回原始调用处</span>

<span class="comment">// x8-x18 临时寄存器，里面的值在函数调用后可能被修改，这些寄存器为caller-saved，可以用</span>
ldr x10, [x12] <span class="comment">// originIMP</span>

stp lr, x10, [sp, <span class="preprocessor">#-<span class="number">16</span>]!</span>
stp x0, x1,  [sp, <span class="preprocessor">#-<span class="number">16</span>]!</span>
stp x2, x3,  [sp, <span class="preprocessor">#-<span class="number">16</span>]!</span>
stp x4, x5,  [sp, <span class="preprocessor">#-<span class="number">16</span>]!</span>
stp x6, x7,  [sp, <span class="preprocessor">#-<span class="number">16</span>]!</span>
str x8,      [sp, <span class="preprocessor">#-<span class="number">16</span>]!</span>

<span class="comment">// 我不用浮点数寄存器，所以我不保存，你们用你们要保存</span>
<span class="comment">// 这行是伪代码，意思意思。实际上这个代码是会Crash的。</span>
bl _WZQMainThreadChecker

ldr x8,      [sp], <span class="preprocessor">#<span class="number">16</span></span>
ldp x6, x7,  [sp], <span class="preprocessor">#<span class="number">16</span></span>
ldp x4, x5,  [sp], <span class="preprocessor">#<span class="number">16</span></span>
ldp x2, x3,  [sp], <span class="preprocessor">#<span class="number">16</span></span>
ldp x0, x1,  [sp], <span class="preprocessor">#<span class="number">16</span></span>
ldp lr, x10, [sp], <span class="preprocessor">#<span class="number">16</span></span>

br x10   <span class="comment">// 执行原函数</span>

mov x13, lr
bl _template_page;

<span class="comment">//// 下面是重复性的一堆代码。</span>
</code></pre><p>主体上是这么写，但是需要考虑的太多了，今天周二，来不及整完博客了，吹吹逼睡觉。</p>
<p>还有很多东西实现了但是文章中没写，周末再写吧，水一篇博客。</p>
<ul>
<li><p>要考虑对齐问题？</p>
</li>
<li><p>为什么可以这么设计桥？</p>
</li>
<li><p>如何保存重要的上下文、寄存器信息等？</p>
</li>
</ul>
<h4 id="结尾">结尾</h4><p>代码写完后我和同事放在手淘里跑了泡，美滋滋，嘻嘻。不崩，还挺顺畅，哈哈，吊打原先的实现。</p>
<p>当然，鉴于本人汇编仅较初级的掌握 ARM64，因此 x86_64 或者 ARM64e（不知道有没有差别） 上的方案近期慢慢等我搞出来吧。</p>
<p>ARM64 上的代码等我周末慢慢整理下开源。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p>如果读过我的博客的人可能知道，我在 <b style="color:red">2017</b> 年曾经研究过<b style="color:red">当时苹果出的一个新玩意 MainThread Checker</b>，并以此为基础推导了一个基于桥的全量 Hook 方案，<]]>
    </summary>
    
      <category term="Assembly" scheme="http://satanwoo.github.io/tags/Assembly/"/>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[目标检测之 Selective Search]]></title>
    <link href="http://satanwoo.github.io/2020/04/07/Selective-Search/"/>
    <id>http://satanwoo.github.io/2020/04/07/Selective-Search/</id>
    <published>2020-04-06T16:36:44.000Z</published>
    <updated>2020-04-06T16:39:34.294Z</updated>
    <content type="html"><![CDATA[<p><br>最近因为工作上的事，搞了一点非常基础目标检测相关的东西。正好在学习之余梳理了下之前自己认知错误的一些地方，记录一下。<br></p>
<h3 id="起因">起因</h3><p><br>之前对于目标检测的了解停留于深度学习部分，比如 Fast-RCNN / Faster-RCNN / Yolo 等等，对于候选框域搜索算法主要还是对于 RPN 的认知。<br><br><br>但是这次在工作中了解到了 Selective Search 的概念，没想到在小样本训练的过程中精度也不错，性能还很好，哈哈。因此决定深入研究下。Selective Search 从大类上也可以属于 Region Proposal 的思想，但是主要的思想却是来源于传统的图像处理。<br><br><br>相关的论文发表于 IJCV 2013 《Selective Search for Object Detection》，大家可自行阅读获取更多细节。<br></p>
<blockquote>
<p>主要还是学习目的，业界主流的还是采用 Faster-RCNN 的做法。</p>
</blockquote>
<h3 id="Selective_Search">Selective Search</h3><p><br>目标检测问题相对来说比图像分类复杂点，因为一般情况下要同时检测出多个子物体的位置（及可能需要的分类目的）。最原始的做法就是对于一张图像的每个可能位置都进行搜索，但是这里会产生一个两个互相增加复杂度的问题？<br></p>
<ul>
<li>我们要识别的物体在哪？我们要识别的物体大小是多少？长宽比要不要考虑？</li>
</ul>
<p><br><strong>简单来说，假设知道一个待识别的物体左上角顶点处于（x, y），那么长和宽分别设置多少呢？设置小了，可能没有办法得到正确要识别的物体；设置大了，可能又把要分开区分的两个或多个物体合在了一起。</strong><br><br><br>因此，这种传统的做法产生的搜索空间基本可以认为是无穷尽的。<br><br><br><strong>那么自然而然地，我们的优化的想法肯定是减少搜索空间的大小！怎么做呢？</strong><br><br><br>答案说难也不难，就是<strong>只找哪些可能是物体的区域。从区域这个维度进行搜索，而不是全图像的像素级查询。</strong><br></p>
<blockquote>
<p>全图搜索绝大多数的搜索像素包含区域是不包含物体的，实质上是浪费，可以通过如下两张图进行直观对比。</p>
</blockquote>
<p><br><img src="https://cdn.nlark.com/yuque/0/2020/jpeg/520564/1586190762414-d187819a-a5f8-467c-ac0e-b6f4fdb0facd.jpeg#align=left&amp;display=inline&amp;height=416&amp;originHeight=416&amp;originWidth=813&amp;size=0&amp;status=done&amp;style=none&amp;width=813" alt=""><br><br><br><img src="https://cdn.nlark.com/yuque/0/2020/jpeg/520564/1586190762646-b0f5a4d4-ea6d-4223-a427-3dcab2360020.jpeg#align=left&amp;display=inline&amp;height=389&amp;originHeight=389&amp;originWidth=794&amp;size=0&amp;status=done&amp;style=none&amp;width=794" alt=""><br><br><br>基于此，作者首先利用图像分割的想法，来获取可能是物体的区域；<strong>当然，这种层次的分割肯定不准<br><br><br>进一步地，考虑掉物体之间诸如包含等关系，通过</strong>合并<strong>的方式来构建</strong>层次化**的潜在物体区域。<br><br><br>所以整篇论文的核心就可以归纳为如下的数学公式：<br><br><br><img src="https://cdn.nlark.com/yuque/0/2020/png/520564/1586190762438-1360cd20-f297-4977-8835-07cd1d7ac43b.png#align=left&amp;display=inline&amp;height=389&amp;originHeight=389&amp;originWidth=452&amp;size=0&amp;status=done&amp;style=none&amp;width=452" alt=""><br></p>
<ul>
<li>通过图像分割算法得到初始区域集合 R = {r1, ….. rn}，这个很容易理解吧，就是图像分割。</li>
<li>设定一个相似集合 S，初始为<strong>空</strong>。</li>
<li>对于初始区域集合<strong>相邻</strong>中的每一对(ri, rj)，计算<strong>相似度（下文会说如何计算相似度）</strong>，得到 s(ri, rj)，将其加入之前的相似集合 S 中。</li>
<li>当 S 不为空的时候，从 S 中获取相似度最大的一对 s(ri, rj)，将这两个 ri, rj 区域合并，称为 rt。</li>
<li>把所有和 ri, rj 相关的<strong>相似度对</strong>都从 S 中移除掉。（ri, rj 已经不存在了，变身为 rt）</li>
<li>把新得到的 rt，在分别和其邻区域的 rx 们，计算相似度对，存入 S 中。</li>
<li>把 rt 加入到区域集合 R 中。</li>
<li>重复步骤，知道合并到最后只有一个区域了（即 S 为空）。</li>
</ul>
<p><br>这个时候，R 集合中的所有区域，就是通过 Selective Search 得到的候选框区域。<br><br><br><strong>值得注意的是，这种计算方式得到的 R，本身就包含了多层次的关系。</strong><br></p>
<p><a name="3a2cccf8"></a></p>
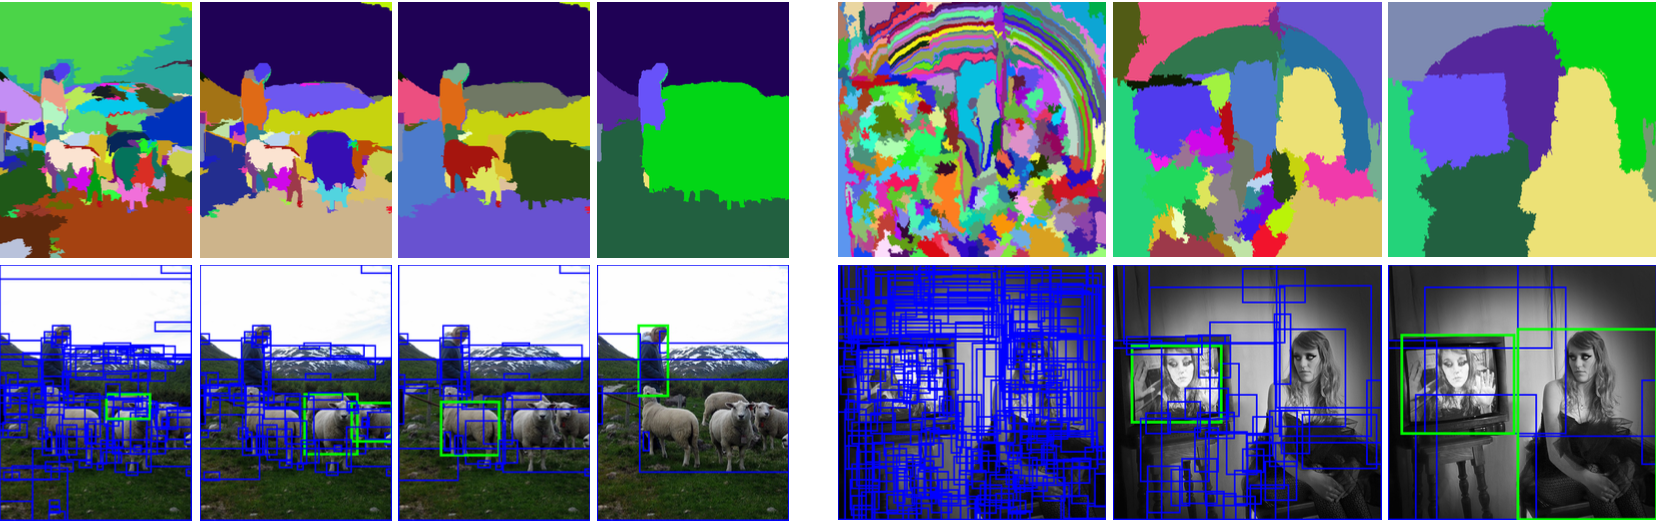
<h4 id="如何合并">如何合并</h4><p><br>前面我们提到了，我们初始的待定区域是基于图像分割得到的一批候选集，但是这些候选集的质量还比较“糙”，粒度也不一定对，需要合并甚至多次合并来处理一下。<strong>因此，如何合并也是一个相对值得思考的问题。</strong><br><strong><br></strong><img src="https://cdn.nlark.com/yuque/0/2020/png/520564/1586190829238-e23f2c94-b271-499f-9cc7-230e005a8d94.png#align=left&amp;display=inline&amp;height=522&amp;name=%E6%88%AA%E5%B1%8F2020-04-07%E4%B8%8A%E5%8D%8812.33.29.png&amp;originHeight=522&amp;originWidth=1656&amp;size=1153243&amp;status=done&amp;style=none&amp;width=1656" alt="截屏2020-04-07上午12.33.29.png"><strong><br></strong></p>
<blockquote>
<p>上两张图不难看出，初始化的图像分割对于目标检测来说是不能直接使用的。</p>
</blockquote>
<p><br><strong>其实这篇文章，作者也坦诚道：图片的样式千变万化，某些图片里面可行的方案到了另外一些图片中就不适用了。</strong> 因此，作者采用了多种方案混合的合并方法。<br></p>
<ul>
<li>比如，背景色大块区域和前景色不同的主体可以很明显区分。</li>
<li>比如，材质 / 纹理等也可以比较明显区分出待检测的物体。</li>
<li>比如，形状和大小也可以做为检测手段区分待检测物体。</li>
</ul>
<p><br>有了这些可以参考的思路，作者设计了<strong>四合一的合并公式。</strong><br></p>
<ul>
<li>颜色相似度</li>
<li>纹理相似度，这里使用了 SIFT 算法。</li>
<li>小区域合并优先级度。这里解释下，作者为了避免出现“大鱼吃小鱼”的现象，即一块区域不断膨胀，吞并周围区域，所以采用了尽量将小区域先分别合并，始终保持大小类似的方式。</li>
<li>距离。如果区域ri包含在rj内，毫无疑问应该立刻合并，另一方面，如果ri很难与rj相接，不应该合并在一块。这里定义区域的合适度距离主要是为了衡量两个区域是否更加“吻合”，其指标是合并后的区域的Bounding Box（能够框住区域的最小矩形BBij）越小，其吻合度越高。</li>
</ul>
<p><a name="72f1243d"></a></p>
<h3 id="Selective_Search_代码理解">Selective Search 代码理解</h3><p><br>读顶尖学术会议论文的好处就是一般对应的代码都会开源，即使论文读的云里雾里，但是只要能大致理解思路，配合源代码深入分析，总是能懂。<br><br><br>这篇论文对应的代码开源在<a href="https://github.com/AlpacaDB/selectivesearch" target="_blank" rel="external">Selective Search</a>，代码总计也就 <strong>300+</strong> 行（当然有些非核心代码直接依赖了库），很容易理解。<br></p>
<figure class="highlight sql"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br><span class="line">62</span><br><span class="line">63</span><br><span class="line">64</span><br><span class="line">65</span><br><span class="line">66</span><br><span class="line">67</span><br><span class="line">68</span><br><span class="line">69</span><br><span class="line">70</span><br><span class="line">71</span><br></pre></td><td class="code"><pre><span class="line">def selective_search(</span><br><span class="line">        im_orig, scale=1.0, sigma=0.8, min_size=50):</span><br><span class="line">    '''Selective Search</span><br><span class="line">    </span><br><span class="line"> 	 assert im_orig.shape[2] == 3, "3ch image is expected"</span><br><span class="line"></span><br><span class="line">    # <span class="operator"><span class="keyword">load</span> image <span class="keyword">and</span> <span class="keyword">get</span> smallest regions</span><br><span class="line">    # region label <span class="keyword">is</span> <span class="keyword">stored</span> <span class="keyword">in</span> the <span class="number">4</span>th <span class="keyword">value</span> <span class="keyword">of</span> <span class="keyword">each</span> pixel [r,<span class="keyword">g</span>,b,(region)]</span><br><span class="line">    </span><br><span class="line">    </span><br><span class="line">   【<span class="number">1</span>】图像分割</span><br><span class="line">    img = _generate_segments(im_orig, scale, sigma, min_size)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">if</span> img <span class="keyword">is</span> <span class="keyword">None</span>:</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">None</span>, &#123;&#125;</span><br><span class="line">        </span><br><span class="line">        </span><br><span class="line">	【<span class="number">2</span>】获取对象总大小</span><br><span class="line">    imsize = img.shape[<span class="number">0</span>] * img.shape[<span class="number">1</span>]</span><br><span class="line">    </span><br><span class="line">   【<span class="number">3</span>】获取初始集合</span><br><span class="line">    R = _extract_regions(img)</span><br><span class="line"></span><br><span class="line">    # <span class="keyword">extract</span> neighbouring information</span><br><span class="line">    </span><br><span class="line">   【<span class="number">4</span>】计算相邻的区域</span><br><span class="line">    neighbours = _extract_neighbours(R)</span><br><span class="line"></span><br><span class="line">   【<span class="number">5</span>】计算初始化的相邻区域相似度</span><br><span class="line">    S = &#123;&#125;</span><br><span class="line">    <span class="keyword">for</span> (ai, ar), (bi, br) <span class="keyword">in</span> neighbours:</span><br><span class="line">        S[(ai, bi)] = _calc_sim(ar, br, imsize)</span><br><span class="line">        </span><br><span class="line">        </span><br><span class="line">	【<span class="number">6</span>】就是之前我们说的搜索过程</span><br><span class="line">    # hierarchal <span class="keyword">search</span></span><br><span class="line">    <span class="keyword">while</span> S != &#123;&#125;:</span><br><span class="line"></span><br><span class="line">        # <span class="keyword">get</span> highest similarity</span><br><span class="line">        <span class="keyword">i</span>, j = sorted(S.items(), <span class="keyword">key</span>=lambda <span class="keyword">i</span>: <span class="keyword">i</span>[<span class="number">1</span>])[-<span class="number">1</span>][<span class="number">0</span>]</span><br><span class="line"></span><br><span class="line">        # <span class="keyword">merge</span> <span class="keyword">corresponding</span> regions</span><br><span class="line">        <span class="keyword">t</span> = <span class="keyword">max</span>(R.<span class="keyword">keys</span>()) + <span class="number">1.0</span></span><br><span class="line">        R[<span class="keyword">t</span>] = _merge_regions(R[<span class="keyword">i</span>], R[j])</span><br><span class="line"></span><br><span class="line">        # mark similarities <span class="keyword">for</span> regions <span class="keyword">to</span> be removed</span><br><span class="line">        key_to_delete = []</span><br><span class="line">        <span class="keyword">for</span> <span class="keyword">k</span>, v <span class="keyword">in</span> <span class="keyword">list</span>(S.items()):</span><br><span class="line">            <span class="keyword">if</span> (<span class="keyword">i</span> <span class="keyword">in</span> <span class="keyword">k</span>) <span class="keyword">or</span> (j <span class="keyword">in</span> <span class="keyword">k</span>):</span><br><span class="line">                key_to_delete.append(<span class="keyword">k</span>)</span><br><span class="line"></span><br><span class="line">        # remove <span class="keyword">old</span> similarities <span class="keyword">of</span> related regions</span><br><span class="line">        <span class="keyword">for</span> <span class="keyword">k</span> <span class="keyword">in</span> key_to_delete:</span><br><span class="line">            del S[<span class="keyword">k</span>]</span><br><span class="line"></span><br><span class="line">        # calculate similarity <span class="keyword">set</span> <span class="keyword">with</span> the <span class="keyword">new</span> region</span><br><span class="line">        <span class="keyword">for</span> <span class="keyword">k</span> <span class="keyword">in</span> [a <span class="keyword">for</span> a <span class="keyword">in</span> key_to_delete <span class="keyword">if</span> a != (<span class="keyword">i</span>, j)]:</span><br><span class="line">            <span class="keyword">n</span> = <span class="keyword">k</span>[<span class="number">1</span>] <span class="keyword">if</span> <span class="keyword">k</span>[<span class="number">0</span>] <span class="keyword">in</span> (<span class="keyword">i</span>, j) <span class="keyword">else</span> <span class="keyword">k</span>[<span class="number">0</span>]</span><br><span class="line">            S[(<span class="keyword">t</span>, <span class="keyword">n</span>)] = _calc_sim(R[<span class="keyword">t</span>], R[<span class="keyword">n</span>], imsize)</span><br><span class="line"></span><br><span class="line">    regions = []</span><br><span class="line">    <span class="keyword">for</span> <span class="keyword">k</span>, r <span class="keyword">in</span> <span class="keyword">list</span>(R.items()):</span><br><span class="line">        regions.append(&#123;</span><br><span class="line">            <span class="string">'rect'</span>: (</span><br><span class="line">                r[<span class="string">'min_x'</span>], r[<span class="string">'min_y'</span>],</span><br><span class="line">                r[<span class="string">'max_x'</span>] - r[<span class="string">'min_x'</span>], r[<span class="string">'max_y'</span>] - r[<span class="string">'min_y'</span>]),</span><br><span class="line">            <span class="string">'size'</span>: r[<span class="string">'size'</span>],</span><br><span class="line">            <span class="string">'labels'</span>: r[<span class="string">'labels'</span>]</span><br><span class="line">        &#125;)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> img, regions</span></span><br></pre></td></tr></table></figure>
<ul>
<li>第一步，通过经典的图像分割算法获取分割的块。这一步留到后续研究 felzenszwalb 算法再说吧，<strong>暂时我也不会。</strong></li>
<li>其实第一步已经得到对应的区域了，但是在算法实现上只是做了一个个标记，所以还需要处理下，变成我们需要的 R 集合。这步里面已经做好了大量的计算处理，后续直接按照论文<strong>层级化</strong>调用就行。</li>
<li>计算相邻的区域，对应产生初始的 S 集合。</li>
<li>对相邻的区域计算最大相似度，然后合并。</li>
<li>后面就重复我上问的内容了。</li>
</ul>
<p><br>大致内容就这样，当然细节还有不少值得研究的，可以继续深入，后续再读读。<br><br><br>最后，作者这 Python 写的真是溜。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p><br>最近因为工作上的事，搞了一点非常基础目标检测相关的东西。正好在学习之余梳理了下之前自己认知错误的一些地方，记录一下。<br></p>
<h3 id="起因">起因</h3><p><br>之前对于目标检测的了解停留于深度学习部分，比如 Fast-RCNN / Fast]]>
    </summary>
    
      <category term="Machine Learning" scheme="http://satanwoo.github.io/tags/Machine-Learning/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[实现 MNN 模型的可视化工具]]></title>
    <link href="http://satanwoo.github.io/2020/02/06/MNN-Visual/"/>
    <id>http://satanwoo.github.io/2020/02/06/MNN-Visual/</id>
    <published>2020-02-06T15:10:21.000Z</published>
    <updated>2020-02-07T13:33:24.017Z</updated>
    <content type="html"><![CDATA[<p><code>Netron</code> 是一个支持 <code>Tensorflow</code> ，<code>PyTorch</code> ，<code>MXNet</code> ，<code>NCNN</code> ， <code>PaddlePaddle</code> 等深度模型格式的可视化框架。去年国庆前的时候我稍微研究了下相关的代码，<b style="color:red">重点关注其将其是如何设计出一套兼容不同模型格式表征，用来归一化展现不同的深度学习框架模型。</b></p>
<p>研究完成后，我利用如下两个 <code>Commit</code> 作为 <code>Pull Request</code> 提交给了作者，用以支持 <code>MNN</code> 的模型可视化。</p>
<ul>
<li><p><a href="https://github.com/lutzroeder/netron/pull/340" target="_blank" rel="external">Visualization support for MNN models #340</a></p>
</li>
<li><p><a href="https://github.com/lutzroeder/netron/pull/345" target="_blank" rel="external">Fix loading .mnn model failed when there is no extraTensorDescribe existed.</a></p>
</li>
</ul>
<p>从中也不难看出我扎实的英语表述能力（我果然是个国际化人才）。</p>
<p>这篇文章会从<strong>架构设计、标准定义、巧用JS解析</strong>等几个方面来阐述</p>
<h3 id="架构设计">架构设计</h3><p>整体上，按照我个人的理解，<code>Netron</code> 的架构可以简要展现如下：</p>
<p><img src="https://upload-images.jianshu.io/upload_images/4292627-565192345c3f5484.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p>最基础的应用部分及运行环境，是 <code>Electron</code> 这个跨平台框架直接呈现的。<br>当然，一些诸如基础zip/gzip用于解压等等的库我们也统一归类到支撑里。</p>
<p>然后是一套经典的 <code>MVC</code> 的结构，<code>app.js</code> 作为整体的 controller ，负责整个应用的功能逻辑，如导出图片、菜单管理、保存加载等等。<b style="color:red">这一层我们需要的做事非常少，只要将 <code>MNN</code> 支持的模型后缀 <code>.mnn</code> 注册进去即可</b>。 然后是是对应的 <code>view.js</code>，这块实际上还是一层 <code>controller</code>，类比我们常说的子控制器，专门用于处理主视图的逻辑，如下图所示：</p>
<p><img src="https://upload-images.jianshu.io/upload_images/4292627-6539f5107f03904e.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p><b style="color:red">从这块开始，我们就要注意了，因为这里开始通过工厂方法对应的根据读取文件类型的不同，托管给了不同的自定义 <code>xxx.js</code> 来处理后续步骤</b>。 比如<code>.mar</code>，<code>model</code>，<code>prototxt</code> 等格式的模型会首先托管给 <code>mxnet.js</code>来处理。<strong>如果存在重名，则按照先后顺序依次尝试。</strong></p>
<pre><code>view.ModelFactoryService = <span class="keyword">class</span> {
    <span class="constructor"><span class="keyword">constructor</span>(host) </span>{
        <span class="keyword">this</span>._host = host;
        <span class="keyword">this</span>._extensions = [];
        <span class="keyword">this</span>.register(<span class="string">'./onnx'</span>, [ <span class="string">'.onnx'</span>, <span class="string">'.pb'</span>, <span class="string">'.pbtxt'</span>, <span class="string">'.prototxt'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./mxnet'</span>, [ <span class="string">'.mar'</span>, <span class="string">'.model'</span>, <span class="string">'.json'</span>, <span class="string">'.params'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./keras'</span>, [ <span class="string">'.h5'</span>, <span class="string">'.hd5'</span>, <span class="string">'.hdf5'</span>, <span class="string">'.keras'</span>, <span class="string">'.json'</span>, <span class="string">'.model'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./coreml'</span>, [ <span class="string">'.mlmodel'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./caffe'</span>, [ <span class="string">'.caffemodel'</span>, <span class="string">'.pbtxt'</span>, <span class="string">'.prototxt'</span>, <span class="string">'.pt'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./caffe2'</span>, [ <span class="string">'.pb'</span>, <span class="string">'.pbtxt'</span>, <span class="string">'.prototxt'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./pytorch'</span>, [ <span class="string">'.pt'</span>, <span class="string">'.pth'</span>, <span class="string">'.pkl'</span>, <span class="string">'.h5'</span>, <span class="string">'.t7'</span>, <span class="string">'.model'</span>, <span class="string">'.dms'</span>, <span class="string">'.pth.tar'</span>, <span class="string">'.ckpt'</span>, <span class="string">'.bin'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./torch'</span>, [ <span class="string">'.t7'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./torchscript'</span>, [ <span class="string">'.pt'</span>, <span class="string">'.pth'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./mnn'</span>, [<span class="string">'.mnn'</span>, <span class="string">'.tflite'</span>]);
        <span class="keyword">this</span>.register(<span class="string">'./tflite'</span>, [ <span class="string">'.tflite'</span>, <span class="string">'.lite'</span>, <span class="string">'.tfl'</span>, <span class="string">'.bin'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./tf'</span>, [ <span class="string">'.pb'</span>, <span class="string">'.meta'</span>, <span class="string">'.pbtxt'</span>, <span class="string">'.prototxt'</span>, <span class="string">'.json'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./sklearn'</span>, [ <span class="string">'.pkl'</span>, <span class="string">'.joblib'</span>, <span class="string">'.model'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./cntk'</span>, [ <span class="string">'.model'</span>, <span class="string">'.cntk'</span>, <span class="string">'.cmf'</span>, <span class="string">'.dnn'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./openvino'</span>, [ <span class="string">'.xml'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./darknet'</span>, [ <span class="string">'.cfg'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./paddle'</span>, [ <span class="string">'.paddle'</span>, <span class="string">'__model__'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./ncnn'</span>, [ <span class="string">'.param'</span>, <span class="string">'.bin'</span>, <span class="string">'.cfg.ncnn'</span>, <span class="string">'.weights.ncnn'</span>]);
        <span class="keyword">this</span>.register(<span class="string">'./dl4j'</span>, [ <span class="string">'.zip'</span> ]);
        <span class="keyword">this</span>.register(<span class="string">'./mlnet'</span>, [ <span class="string">'.zip'</span>]);

    }
</code></pre><p>在这上层是一层标准定义层，用于抹平不同模型之间的表达方式，用归一化的逻辑来进行处理，<strong>至于怎么把自己的模型表征映射成归一化的逻辑，就需要编写对应 <code>xxx.js</code> 来自行处理，后文会以 <code>MNN</code> 来进行举例。</strong></p>
<p>最上层就是对应各个深度框架自行的逻辑处理了。其中包含了数据格式及对应解析（如 <code>flatbuffer</code>）、内容校验、构图等等，后文也会用 <code>MNN</code> 举例说明。</p>
<h3 id="标准定义">标准定义</h3><p>这一环是一个很不起眼但是却非常重要的环节。 每种深度模型框架都有其自定义的模块结构和模块构成，一般都以 <code>Flatbuffer Schema</code> 的形式构成。（当然也有例外）以<code>MNN</code> 为例，其对应的模型结构大致如下图所示：</p>
<p><img src="https://upload-images.jianshu.io/upload_images/9525982-b558276df2e23ddc.png" alt=""></p>
<blockquote>
<p>上图引用自<a href="https://www.jianshu.com/p/8eb153c12a4b" target="_blank" rel="external">FlatBuffers，MNN模型存储结构基础 —- 无法解读MNN模型文件的秘密</a></p>
</blockquote>
<p>同理， <code>TFLite</code> 的模型也可见 <code>TFLite.schema</code>，不再赘述。</p>
<p>从定义中不难看出，<code>TFLite</code> 有 <code>model</code>，<code>graph</code> ，<code>SubGraph</code> 等；而 <code>MNN</code> 对应的就是<code>Net</code>；再往下一层 <code>TFLite</code> 有 <code>Operator</code> 和 <code>Options</code>；而 <code>MNN</code> 有 <code>OP</code> 和<code>OPParameter</code>；至于 <code>NCNN</code> 则是 <code>Layer</code>。</p>
<p><b style="color:red">如果是从整个架构角度去兼容不同的框架，必然会有着大量的 <code>messy code</code>。因此作者定义了一套标准表征，让不同的深度模型自己去解析，然后附着自身的逻辑到这同一套表征上。</b></p>
<ul>
<li><code>Model</code> ，表示模型的静态表示。</li>
<li><code>Graph</code> ，表示模型的计算图表示。</li>
<li><code>Node</code> ，一个操作对应一个节点。</li>
<li><code>Tensor</code> ，输入输出数据。</li>
<li><code>Parameter</code> ，对应的属性。</li>
<li><code>Argument</code> ，对应的属性值。</li>
</ul>
<blockquote>
<p>上述 <code>Parameter</code> 和 <code>Argument</code>可以简单认为一一对应吧，都认为是属性值即可。</p>
</blockquote>
<p>一图胜千言，下图比较好的展现了<strong>术语和对应的表征：</strong></p>
<p><img src="https://upload-images.jianshu.io/upload_images/4292627-ecec7a02f7c33ae9.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p>这样不同的框架模型只要在自己对应的 <code>xxx.js</code> 中，把<strong>图，<code>OP</code> 层</strong>对应的数据填充至对应的地方即可。</p>
<p>这里依然以 <code>MNN</code> 举例：</p>
<ul>
<li>我们不存在 <code>subgraph</code> 的概念，直接把 <code>Model</code> 和 <code>Graph</code> 等价于一个 <code>net</code>即可。</li>
<li>从 <code>net</code> 中取出 <code>oplist</code> ，对应创建成 <code>Node</code>。</li>
<li>从 <code>oplist</code> 中每个 <code>op</code> ，取出对应的 <code>tensorIndex</code>，根据 <code>net</code> 的 <code>tensorName</code> 和<code>tensorIndex</code> 来创建对应的 <code>tensor</code> 。</li>
<li>从 <code>op</code> 中根据 <code>opparameter</code> 的种类，从 <code>op.main</code> 中取出不同的数据来填入 <code>paramter / argument</code>，<strong>这块是解析的大头，如果没想好方式，就会非常浪费时间</strong>，下文重点说。</li>
</ul>
<h3 id="数据格式">数据格式</h3><p>诸如 <code>MNN</code> ，<code>TFlite</code> 都选用了 <code>Flatbuffer</code> 来进行数据的保存，而官方的 <code>flatc</code> 程序支持直接根据定义的 <code>schema</code> 文件生成对应的 <code>generated.js</code>，命令如下：</p>
<pre><code>.<span class="regexp">/flatc -s ~/y</span>ourPathTo<span class="regexp">/MNN/</span>schema<span class="regexp">/default/</span>Type.fbs
</code></pre><p>这个我看了下很多的同学的在处理多 <code>Schema</code> 定义的时候是对应的一个个生成 <code>generated.js</code>，这样维护成本比较大，既然我们的已经使用了 <code>include</code> 机制，我们直接在生成过程中合并即可，如下所示：</p>
<pre><code>.<span class="regexp">/flatc --js -I ~/y</span>ourPathTo<span class="regexp">/MNN/</span>schema<span class="regexp">/default/</span> ~<span class="regexp">/yourPathTo/M</span>NN<span class="regexp">/schema/</span><span class="keyword">default</span><span class="regexp">/MNN.fbs --gen-all</span>
</code></pre><p>这里有两个参数注意下：</p>
<ul>
<li><code>-I</code>，表示 <code>include</code> 从哪个路径进行搜索。</li>
<li><code>--gen-all</code>，表示自动对生成的所有文件合并。</li>
</ul>
<p>生成代码大致如下：</p>
<pre><code><span class="comment">/**
 * <span class="doctag">@param</span> {number} i
 * <span class="doctag">@param</span> {flatbuffers.ByteBuffer} bb
 * <span class="doctag">@returns</span> {MNN.Blob}
 */</span>
MNN.Blob.prototype.__init = <span class="function"><span class="keyword">function</span><span class="params">(i, bb)</span> </span>{
  this.bb_pos = i;
  this.bb = bb;
  <span class="keyword">return</span> this;
};
<span class="comment">/**
 * <span class="doctag">@param</span> {flatbuffers.ByteBuffer} bb
 * <span class="doctag">@param</span> {MNN.Blob=} obj
 * <span class="doctag">@returns</span> {MNN.Blob}
 */</span>
MNN.Blob.getRootAsBlob = <span class="function"><span class="keyword">function</span><span class="params">(bb, obj)</span> </span>{
  <span class="keyword">return</span> (obj || <span class="keyword">new</span> MNN.Blob).__init(bb.readInt32(bb.position()) + bb.position(), bb);
};
<span class="comment">/**
 * <span class="doctag">@param</span> {flatbuffers.ByteBuffer} bb
 * <span class="doctag">@param</span> {MNN.Blob=} obj
 * <span class="doctag">@returns</span> {MNN.Blob}
 */</span>
MNN.Blob.getSizePrefixedRootAsBlob = <span class="function"><span class="keyword">function</span><span class="params">(bb, obj)</span> </span>{
  <span class="keyword">return</span> (obj || <span class="keyword">new</span> MNN.Blob).__init(bb.readInt32(bb.position()) + bb.position(), bb);
};
</code></pre><p>具体关于 <code>FlatBuffer</code> 的细节，可以阅读我之前的文章，不再赘述。</p>
<h3 id="避免冗余解析流程">避免冗余解析流程</h3><p>上文提到 <strong>根据 OpParameter </strong>来获取 <code>main</code> 中的数据，然后依次填入 <code>parameter / argument</code> 是比较耗费精力的步骤。我们所有的 <code>OpParameter</code> 类型有 <b style="color:red">74</b>种（还在不断更新）</p>
<pre><code>MNN.OpParameter = {
  NONE: <span class="number">0</span>,
  QuantizedAdd: <span class="number">1</span>,
  ArgMax: <span class="number">2</span>,
  AsString: <span class="number">3</span>,
  Axis: <span class="number">4</span>,
  BatchNorm: <span class="number">5</span>,
  BinaryOp: <span class="number">6</span>,
  Blob: <span class="number">7</span>,
  CastParam: <span class="number">8</span>,
  Convolution2D: <span class="number">9</span>,
  Crop: <span class="number">10</span>,
  CropAndResize: <span class="number">11</span>,
  Dequantize: <span class="number">12</span>,
  DetectionOutput: <span class="number">13</span>,
  Eltwise: <span class="number">14</span>,
  ExpandDims: <span class="number">15</span>,
  Fill: <span class="number">16</span>,
  Flatten: <span class="number">17</span>,
  Gather: <span class="number">18</span>,
  GatherV2: <span class="number">19</span>,
  InnerProduct: <span class="number">20</span>,
  Input: <span class="number">21</span>,
  Interp: <span class="number">22</span>,
  LRN: <span class="number">23</span>,
  LSTM: <span class="number">24</span>,
  MatMul: <span class="number">25</span>,
  NonMaxSuppressionV2: <span class="number">26</span>,
  Normalize: <span class="number">27</span>,
  PackParam: <span class="number">28</span>,
  Permute: <span class="number">29</span>,
  Plugin: <span class="number">30</span>,
  Pool: <span class="number">31</span>,
  PRelu: <span class="number">32</span>,
  PriorBox: <span class="number">33</span>,
  Proposal: <span class="number">34</span>,
  QuantizedAvgPool: <span class="number">35</span>,
  QuantizedBiasAdd: <span class="number">36</span>,
  QuantizedConcat: <span class="number">37</span>,
  QuantizedLogistic: <span class="number">38</span>,
  QuantizedMatMul: <span class="number">39</span>,
  QuantizedMaxPool: <span class="number">40</span>,
  QuantizedRelu: <span class="number">41</span>,
  QuantizedRelu6: <span class="number">42</span>,
  QuantizedReshape: <span class="number">43</span>,
  QuantizedSoftmax: <span class="number">44</span>,
  QuantizeMaxMin: <span class="number">45</span>,
  QuantizeV2: <span class="number">46</span>,
  Range: <span class="number">47</span>,
  Rank: <span class="number">48</span>,
  ReduceJoin: <span class="number">49</span>,
  ReductionParam: <span class="number">50</span>,
  Relu: <span class="number">51</span>,
  Relu6: <span class="number">52</span>,
  RequantizationRange: <span class="number">53</span>,
  Requantize: <span class="number">54</span>,
  Reshape: <span class="number">55</span>,
  Resize: <span class="number">56</span>,
  RoiPooling: <span class="number">57</span>,
  Scale: <span class="number">58</span>,
  Selu: <span class="number">59</span>,
  Size: <span class="number">60</span>,
  Slice: <span class="number">61</span>,
  SliceTf: <span class="number">62</span>,
  SpaceBatch: <span class="number">63</span>,
  SqueezeParam: <span class="number">64</span>,
  StridedSliceParam: <span class="number">65</span>,
  TensorConvertInfo: <span class="number">66</span>,
  TfQuantizedConv2D: <span class="number">67</span>,
  TopKV2: <span class="number">68</span>,
  Transpose: <span class="number">69</span>,
  UnaryOp: <span class="number">70</span>,
  MomentsParam: <span class="number">71</span>,
  RNNParam: <span class="number">72</span>,
  BatchMatMulParam: <span class="number">73</span>,
  QuantizedFloatParam: <span class="number">74</span>
};
</code></pre><p><strong>以 <code>Convolution2D</code> 举例，它又有几个对应的参数：<code>weight</code> ，<code>bias</code> ，<code>quanParameter</code> ，<code>symmetricQuan</code> ，<code>padX</code> ，<code>padY</code> ，<code>kernelX</code> ，<code>kernelY</code> 等等，需要解析。</strong></p>
<p>一开始我采用了人肉的解析方式，代码就成了 <code>if else</code> 加上一大堆解析代码：</p>
<pre><code>mnn_private.Convolution2DAttrBuilder = <span class="keyword">class</span> {
constructor() {}

buildAttributes(metadata, parameter) {
    <span class="comment">//var common = parameter.common();</span>
    var attributes = [];
    var common = parameter.common();
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"padX"</span>, common.padX(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"padY"</span>, common.padY(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"kernelX"</span>, common.kernelX(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"kernelY"</span>, common.kernelY(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"strideX"</span>, common.strideX(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"strideY"</span>, common.strideY(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"dilateX"</span>, common.dilateX(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"dilateY"</span>, common.dilateY(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"padMode"</span>, mnn.schema.PadModeName[common.dilateY()], <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"group"</span>, common.<span class="keyword">group</span>(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"outputCount"</span>, common.outputCount(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"inputCount"</span>, common.inputCount(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"relu"</span>, common.relu(), <span class="keyword">true</span>));
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"relu6"</span>, common.relu6(), <span class="keyword">true</span>));
    <span class="comment">//var quanParameter = parameter.quanParameter();</span>
    var weights = [];
    <span class="keyword">for</span> (var w = <span class="number">0</span>; w &lt; parameter.weightLength(); w++) {
        weights.<span class="keyword">push</span>(parameter.weight(w));
    }
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"weights"</span>, weights, <span class="keyword">true</span>));
    var bias = [];
    <span class="keyword">for</span> (var b = <span class="number">0</span>; b &lt; parameter.biasLength(); b++) {
        bias.<span class="keyword">push</span>(parameter.bias(b));
    }
    attributes.<span class="keyword">push</span>(<span class="keyword">new</span> mnn.Attribute(metadata, <span class="string">"bias"</span>, bias, <span class="keyword">true</span>));

    <span class="keyword">return</span> attributes;
}

get hasMain() {
    <span class="keyword">return</span> <span class="keyword">true</span>;
}
</code></pre><p><strong>这样的代码如果写完74个 <code>OpParameter</code> ，可维护性和后续的扩展也不够。</strong></p>
<p><b style="color:red">我们要巧用 <code>JavaScript</code>的 <code>Reflect</code> 能力以及<strong>属性等于与字符串值属性的特性</strong></b></p>
<pre><code>_buildAttributes(metadata, op, net, args) {
        <span class="keyword">var</span> opParameter = op.mainType();    
        <span class="keyword">var</span> opParameterName = mnn.schema.OpParameterName[opParameter];

        <span class="comment">// 获取对应的类型</span>
        <span class="keyword">var</span> mainConstructor = mnn.schema[opParameterName];
        <span class="keyword">var</span> opParameterObject = <span class="keyword">null</span>;
        <span class="keyword">if</span> (<span class="keyword">typeof</span> mainConstructor === <span class="string">'function'</span>) {
            <span class="keyword">var</span> mainTemplate = Reflect.construct(mainConstructor, []);
            opParameterObject = op.main(mainTemplate);
        }
        <span class="keyword">this</span>._recursivelyBuildAttributes(metadata, net, opParameterObject, <span class="keyword">this</span>._attributes);
    }
    _recursivelyBuildAttributes(metadata, net, opParameterObject, attributeHolders) {
        <span class="keyword">if</span> (!opParameterObject) <span class="keyword">return</span>;
        <span class="keyword">var</span> attributeName;
        <span class="keyword">var</span> attributeNames = [];
        <span class="keyword">var</span> attributeNamesMap = {};
        <span class="keyword">for</span> (attributeName of Object.keys(Object.getPrototypeOf(opParameterObject))) {
            <span class="keyword">if</span> (attributeName != <span class="string">'__init'</span>) {
                attributeNames.push(attributeName);
            }
            attributeNamesMap[attributeName] = <span class="keyword">true</span>;
        }
        <span class="keyword">var</span> attributeArrayNamesMap = {}; 
        <span class="keyword">for</span> (attributeName of Object.keys(attributeNamesMap)) {
            <span class="keyword">if</span> (attributeNamesMap[attributeName + <span class="string">'Length'</span>]) {                    attributeArrayNamesMap[attributeName] = <span class="keyword">true</span>;
                attributeNames = attributeNames.filter((item) =&gt; item != (attributeName + <span class="string">'Array'</span>) &amp;&amp; item != (attributeName + <span class="string">'Length'</span>));
            }
        }
        <span class="keyword">for</span> (attributeName of attributeNames) {
            <span class="keyword">if</span> (opParameterObject[attributeName] &amp;&amp; <span class="keyword">typeof</span> opParameterObject[attributeName] == <span class="string">'function'</span>) {
                <span class="keyword">var</span> <span class="keyword">value</span> = <span class="keyword">null</span>;
                <span class="keyword">if</span> (attributeArrayNamesMap[attributeName]) {
                    <span class="keyword">var</span> array = [];
                    <span class="keyword">var</span> length = opParameterObject[attributeName + <span class="string">'Length'</span>]();
                    <span class="comment">//var a = opParameterObject[attributeName + 'Array']();</span>
                    <span class="keyword">for</span> (<span class="keyword">var</span> l = <span class="number">0</span>; l &lt; length; l++) {
                        array.push(opParameterObject[attributeName + <span class="string">'Length'</span>](l));
                    }
                    <span class="keyword">value</span> = array;
                }
                <span class="keyword">else</span> {
                    <span class="keyword">value</span> = opParameterObject[attributeName]();
                    <span class="keyword">if</span> (<span class="keyword">typeof</span> <span class="keyword">value</span> === <span class="string">'object'</span>) {
                        <span class="keyword">this</span>._recursivelyBuildAttributes(metadata, net, <span class="keyword">value</span>, attributeHolders);   
                        <span class="keyword">value</span> = <span class="keyword">null</span>;
                    }
                }
                <span class="keyword">if</span> (<span class="keyword">value</span>) {
                    <span class="keyword">var</span> attribute = <span class="keyword">new</span> mnn.Attribute(metadata, attributeName, <span class="keyword">value</span>);
                    attributeHolders.push(attribute);
                }                
            }
        }
    }
</code></pre><p><b style="color:red">区区50多行代码就可以完成所有 <code>OpParamater</code> 及其对应的属性解析。</b></p>
]]></content>
    <summary type="html">
    <![CDATA[<p><code>Netron</code> 是一个支持 <code>Tensorflow</code> ，<code>PyTorch</code> ，<code>MXNet</code> ，<code>NCNN</code> ， <code>PaddlePaddle</code]]>
    </summary>
    
      <category term="JavaScript" scheme="http://satanwoo.github.io/tags/JavaScript/"/>
    
      <category term="Machine Learning" scheme="http://satanwoo.github.io/tags/Machine-Learning/"/>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[了解 SIMD 指令]]></title>
    <link href="http://satanwoo.github.io/2019/12/01/SIMD-1/"/>
    <id>http://satanwoo.github.io/2019/12/01/SIMD-1/</id>
    <published>2019-12-01T15:39:48.000Z</published>
    <updated>2019-12-01T15:44:41.000Z</updated>
    <content type="html"><![CDATA[<h2 id="了解_SIMD_指令">了解 SIMD 指令</h2><p>SIMD 是一种常见的利用单指令完成多数据量处理的计算方式。本文作为 SIMD 文章的引子，先来了解简单的 SIMD 使用和概念。</p>
<h4 id="SIMD_的含义">SIMD 的含义</h4><p>SIMD 的全称是 Single Instruction Multiple Data。简要来说，就是通过一条指令完成多条数据处理的行为。我们知道，虽然程序是由一条条机器指令组成，但是实际上执行一条机器码包含了多个过程，包含取指令、分析指令到执行等，如下图所示（暂时先忽略流水线并行）</p>
<p><img src="http://file.elecfans.com/web1/M00/47/5F/pIYBAFqkjYeAONeZAAApUrptLBI051.jpg" alt=""></p>
<p>而在这其中，每一个阶段，都会消耗一个或多个机器周期。如果我们认为，取指令和分析指令（译码）可以近似的认为是一个机器周期内完成，<b style="color:red">那么不同的指令，在执行阶段耗费的机器周期则大不相同。</b></p>
<p>举个例子，可能加法指令的执行阶段需要两个机器周期；而乘法可能需要5-6个机器周期。那么，当我们无法缩短指令的执行周期缩短的时候，利用 SIMD 技术，则可以在相同的执行周期内完成更多的数据处理，这样也同等的提升了单位时间内的数据吞吐，提高了计算性能。</p>
<p>在 Intel 的手册上，提供了包含 MMX, SSE, AVX 等系列的并行指令，面向不同长度的数据并行，比如：</p>
<ul>
<li>MMX 并行计算 64bit 的数据。</li>
<li>SSE 并行计算 128bit 的数据。</li>
<li>AVX 并行计算 256bit 的数据。</li>
<li>AVX512 并行计算 512bit 的数据。</li>
</ul>
<p>更多详细的使用可以参考：</p>
<p><a href="https://software.intel.com/sites/landingpage/IntrinsicsGuide/" target="_blank" rel="external">Intel 手册</a></p>
<h3 id="SIMD_的使用方式">SIMD 的使用方式</h3><p>由于绝大多数的人对 SIMD 还不甚了解，因此本文基于大家比较熟悉的环境 Xcode + x86/64 架构来完成。</p>
<blockquote>
<p>主要是我懒，不想再翻 ARM 的手册了。</p>
</blockquote>
<p>这里我们以一个简单的 256bit (32 byte) 加法改写成 SIMD 的形式来验证：</p>
<p>原始版本：</p>
<pre><code>double input1[k] = {<span class="number">1</span>, <span class="number">2</span>, <span class="number">3</span>, <span class="number">4</span>};
double input2[k] = {<span class="number">5</span>, <span class="number">6</span>, <span class="number">7</span>, <span class="number">8</span>};
double <span class="literal">result</span>[k] = {<span class="number">0</span>};

<span class="keyword">for</span> (<span class="type">int</span> i = <span class="number">0</span>; i &lt; k; i++) {
    <span class="literal">result</span>[i] = input1[i] + input2[i];
}
</code></pre><p>SIMD 版本：</p>
<pre><code><span class="keyword">const</span> <span class="type">int</span> k = <span class="number">4</span>;
double input1[k] = {<span class="number">1</span>, <span class="number">2</span>, <span class="number">3</span>, <span class="number">4</span>};
double input2[k] = {<span class="number">5</span>, <span class="number">6</span>, <span class="number">7</span>, <span class="number">8</span>};
double <span class="literal">result</span>[k] = {<span class="number">0</span>};

__m256d a = _mm256_load_pd(input1);
__m256d b = _mm256_load_pd(input2);

__m256d c = _mm256_add_pd(a, b);
_mm256_store_pd(<span class="literal">result</span>, c);
</code></pre><p>原始版本比较好懂，我们主要来深入看下 SIMD 中代码的意思：</p>
<ul>
<li><p><code>_mm256_load_pd</code> 就是从内存中读取一个地址，这个地址返回为 <code>__m256d</code> 的向量（256bit）。其中， <code>__mm256d</code>的定义为下：</p>
<pre><code>typedef double __m256d __attribute__<span class="list">(<span class="list">(<span class="keyword">__vector_size__</span><span class="list">(<span class="number">32</span>)</span>)</span>)</span><span class="comment">;</span>
</code></pre><p>  这个含义的意思就是 <code>__m256d</code> 的长度是 32 byte（256bit），而这个 32 byte 是按照 4 个 double 元素构成的。</p>
</li>
<li><p><code>_mm256_add_pd</code> 就是对两个 256bit 的向量元素进行直接相加。</p>
</li>
<li><p><code>_mm256_store_pd</code> 就是 <code>_mm256_load_pd</code>的逆运算，不再赘述。</p>
</li>
</ul>
<p><b style="color:red">注意：如果提示需要 AVX 支持的话，请在 Xcode 对应的代码文件处添加 Compiler Flag: <code>-mavx</code></b></p>
<h3 id="用_SIMD_实现求和加法">用 SIMD 实现求和加法</h3><p>既然说了 SIMD 的本质还是为了提升单位时间内的计算吞吐量，我们还是用一个简单的例子，<strong>加法求和</strong>来实践一下：</p>
<p>常规的代码如下：</p>
<pre><code>double <span class="type">CommonAdd</span>(double *data, <span class="type">int</span> count)
{
    double <span class="literal">result</span> = <span class="number">0</span>;

    <span class="keyword">for</span> (<span class="type">int</span> i = <span class="number">0</span> ; i &lt; count; i++) {
        <span class="literal">result</span> += data[i];
    }

    <span class="keyword">return</span> <span class="literal">result</span>;
}
</code></pre><p>SIMD 的代码如下：</p>
<pre><code><span class="keyword">double</span> AVXAdd(<span class="keyword">double</span> *data, <span class="keyword">int</span> <span class="keyword">count</span>)
{
    <span class="keyword">int</span> offset = <span class="number">0</span>;

    __m256d v1;
    __m256d <span class="keyword">sum</span> = _mm256_setzero_pd();

    <span class="keyword">double</span> ret = <span class="number">0</span>;

    <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; <span class="keyword">count</span>/<span class="number">4</span>; i++) {
        v1 = _mm256_load_pd(data + offset);
        <span class="keyword">sum</span> = _mm256_add_pd(<span class="keyword">sum</span>, v1);
        offset += <span class="number">4</span>;
    }

    <span class="keyword">sum</span> = _mm256_hadd_pd(<span class="keyword">sum</span>, <span class="keyword">sum</span>); <span class="comment">// 水平求和</span>

    ret += <span class="keyword">sum</span>[<span class="number">0</span>];
    ret += <span class="keyword">sum</span>[<span class="number">2</span>];

    <span class="keyword">return</span> ret;
}
</code></pre><p>测试代码如下：</p>
<pre><code><span class="function"><span class="keyword">int</span> <span class="title">main</span><span class="params">()</span> </span>{

    <span class="keyword">struct</span>  timeval   start;
    <span class="keyword">struct</span>  timeval   end;


    <span class="keyword">const</span> <span class="keyword">int</span> k = <span class="number">512</span> * <span class="number">512</span>;

    <span class="keyword">const</span> <span class="keyword">int</span> loop = <span class="number">1</span>;

    <span class="keyword">double</span> input1[k];

    <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; k; i++) {
        input1[i] = i;
    }

    gettimeofday(&amp;start, <span class="literal">nullptr</span>);

    <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; j &lt; loop; j++) {
        CommonAdd(input1, k);
    }

    gettimeofday(&amp;end, <span class="literal">nullptr</span>);

    <span class="built_in">printf</span>(<span class="string">"tv_sec:%ld\n"</span>,end.tv_sec - start.tv_sec);
    <span class="built_in">printf</span>(<span class="string">"tv_usec:%d\n"</span>, end.tv_usec - start.tv_usec);

    <span class="built_in">std</span>::<span class="built_in">cout</span> &lt;&lt; <span class="string">" ======================= "</span> &lt;&lt; <span class="built_in">std</span>::endl;

    gettimeofday(&amp;start, <span class="literal">nullptr</span>);

    <span class="keyword">for</span> (<span class="keyword">int</span> j = <span class="number">0</span>; j &lt; loop; j++) {
        AVXAdd(input1, k);
    }

    gettimeofday(&amp;end, <span class="literal">nullptr</span>);

    <span class="built_in">printf</span>(<span class="string">"tv_sec:%ld\n"</span>,end.tv_sec - start.tv_sec);
    <span class="built_in">printf</span>(<span class="string">"tv_usec:%d\n"</span>, end.tv_usec - start.tv_usec);

    <span class="keyword">return</span> <span class="number">0</span>;
}
</code></pre><p>这里，我们选择了图像处理里面比较常见的 512 * 512 大小来做验证，在我的 2015款 MacBookPro 上可以得到大致如下两个性能耗时：</p>
<ul>
<li>常规方法 【774 us】</li>
<li>SIMD   【560 us】</li>
</ul>
<p>别小看这一点的性能差距，对于大运算量的端侧深度学习可就有很显著的差距了。</p>
<h3 id="后记">后记</h3><p>本文只是仅仅介绍了最常规的 SIMD 使用方式。但是在实际设计的过程中，不可能像我们这么简单的去应用。随之而来的，你会发现伴随着许多不同的坑，包含不规范的应用导致<b style="color:red">性能的下降</b>和<b style="color:red">崩溃问题</b>。这些都会留在后面我们去解决。</p>
]]></content>
    <summary type="html">
    <![CDATA[<h2 id="了解_SIMD_指令">了解 SIMD 指令</h2><p>SIMD 是一种常见的利用单指令完成多数据量处理的计算方式。本文作为 SIMD 文章的引子，先来了解简单的 SIMD 使用和概念。</p>
<h4 id="SIMD_的含义">SIMD 的含义</h4><]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
      <category term="汇编" scheme="http://satanwoo.github.io/tags/%E6%B1%87%E7%BC%96/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[浅谈移动工程师跨界机器学习之路]]></title>
    <link href="http://satanwoo.github.io/2019/10/27/MNN1/"/>
    <id>http://satanwoo.github.io/2019/10/27/MNN1/</id>
    <published>2019-10-26T17:23:39.000Z</published>
    <updated>2019-10-26T17:44:53.000Z</updated>
    <content type="html"><![CDATA[<h3 id="题记">题记</h3><p>相信从事移动开发的朋友们肯定看到过一个表情包：“iOS 开发没人要啦”。</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnn_1.jpeg?raw=true" alt="15706761042966.jpg"></p>
<p>虽说是搞笑之图，却也反映了移动开发领域的部分焦虑感。网上甚至有文章贴出<strong>“难上加难”</strong>的数据，称：“相比于 2017 年，2018 年 Android 程序员人均面邀数<b style="color:red">减少40%</b>，iOS 程序员<b style="color:red">降幅更高达57%</b>，即<strong>平均每个移动端程序员在找工作时收到的面邀数比去年减少一半</strong>。”</p>
<p>撇开玩笑之言，移动开发人员的焦虑感来自何处？我从自身角度及与他人沟通，大致归纳出如下几点：</p>
<ul>
<li>跨平台框架、如 Flutter 对 Native 研发模式的冲击。</li>
<li>业界关注重点从移动时代向人工智能等领域转移。</li>
<li>对自身掌握技术壁垒的担忧。</li>
</ul>
<p>细细品味这三点，我想<strong>开发者在面临业界趋势转移，担忧自身竞争力不足才是焦虑产生的内在根本</strong>。我曾和几个国内知名的 iOS 开发者闲聊，他们表示：都 <strong>9102 </strong>年了，<strong>从大量公开的文章来看，大家还是局限于研究 Runtime，Runloop，block 源码分析等一些比较缺少创新的知识点，让人感受行业的停滞不前。</strong></p>
<p>当然，也有不少开发者在积极拥抱新技术。身边的许多朋友也在了解机器学习，自学相关课程等。但是其中大部分都反馈：学完了基础知识，不知道如何应用；也不知道这些东西能对自己日常工作带来怎样的帮助。<strong>最终的结果就演变成了学了就忘，无法产生实质价值</strong>。</p>
<p>那是不是事情就此陷入了僵局呢？抱着怀疑及学习的态度，我在2018年中旬加入了<strong>手淘-端智能组</strong>，参与了一款名叫 <strong><a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a></strong> 的深度推理引擎的研发工作。这一年多的开发过程，让我对加深了对机器学习 / 深度学习的理解。<strong>但更重要的是，这一年多的亲身经历，让我对过去的观点产生了颠覆式的看法。</strong></p>
<p>在这里，<b style="color:red">我并不想探讨如何学习机器学习，因为这样的文章数量已经浩瀚如海；相反地，我希望通过这篇文章，阐述在开发推理引擎 <a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a> 的过程中，我的思考与收获；希望给许多曾和我一样迷茫的移动开发者，一些亲历的感受和信心。</b></p>
<blockquote>
<p>节约篇幅直接贴出 MNN 的 Github 地址：<a href="https://github.com/alibaba/MNN" target="_blank" rel="external">https://github.com/alibaba/MNN</a></p>
</blockquote>
<p><a name="098e61e1"></a></p>
<h3 id="定义清晰的跨界目标">定义清晰的跨界目标</h3><p>相信有不少同学都曾和我一样，在了解机器学习的初期被诸多的公式推导所吓退，担心这是一个充斥着算法、数学、理论证明的技术领域。</p>
<p>这个观点没错，如果你想要设计出经典的 MobileNet、ResNet 这样的深度神经网络或者是对 Yolo 这样的结构进行复杂度优化，如 Yolo V3 等，你势必要对数学证明、算法优化等方面有较深刻的理解，<strong>从这个角度看，说一句很残酷的话：移动工程师跨界的机会不大。</strong></p>
<p>但是机器学习是不是只有算法？<strong>这个观点是偏颇的，机器学习本质上是一个工程开发、算法优化与实际应用结合的领域。</strong></p>
<p>用 深度学习领域的知名大牛 <strong>贾扬青 </strong>的观点来看：<strong>AI 是一个系统工程，90%的工作在算法之外</strong>。</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnn_3.jpeg?raw=true" alt="IMG_2784.JPG"></p>
<p>换句话说，<strong>机器学习还包含系统工程这个范畴</strong>。往小了说，模型可视化工具、转换工具；往大了讲，学术界探索机器学习的编译优化系统，比如陈天奇提出的 TVM 等等，这都是机器学习的一部分。</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnn_2.png?raw=true" alt=""></p>
<blockquote>
<p>上图是 MNN 官方在 Netron 上维护的可视化框架，我们应该是国内第一个主动支持可视化能力的深度学习推理引擎。</p>
</blockquote>
<p>因此，对于我们移动开发者来说，我们<strong>更适合从系统工程的角度，通过实际编程解决问题，去探索机器学习</strong>。</p>
<blockquote>
<p>备注：这个观点并不是我自己想象出来。大家可以看看机器学习泰斗级人物 Jeff Dean 和李飞飞等人在2017年发表的机器学习系统白皮书。<a href="https://arxiv.org/abs/1904.03257" target="_blank" rel="external">SysML: The New Frontier of Machine Learning Systems</a></p>
</blockquote>
<h3 id="系统工程角度的机器学习价值">系统工程角度的机器学习价值</h3><p>如同大家学习编程时听过的那样，算法和数据结构是核心能力，一通百通。<strong>那么从系统工程的角度来看，无论是机器学习抑或是移动开发，存在诸多共通点是可以相互借鉴</strong>。限于篇幅，我仅仅列举几点能够切实帮助我自身日常开发的：</p>
<h4 id="数据自描述协议">数据自描述协议</h4><p>曾有人戏言“移动开发就是 UITableView + JSON”。虽然是句玩笑话，但也能看出数据传输在移动开发中的重要性。从个人经验来看，绝大多数的移动端数据传输协议基本都采用了 JSON（可能部分公司设计了自己的数据协议）。但是 JSON 存在几个缺点（不考虑优化的前提）：</p>
<ul>
<li>不内存友好，相对会带来性能瓶颈。</li>
<li>需要人为的解析流程。</li>
<li>不具备很好的类型解释性。</li>
</ul>
<p>为了解决类似的问题，一些新的数据协议，如 <strong>FlatBuffer </strong>也渐渐进入大家的视线之中。<strong>尽管之前就对其有所耳闻，但是真的深入了解还是要追溯到开发推理引擎的过程中</strong>。在设计机器学习模型存储结构中，大名鼎鼎的 TFLite，<a href="https://github.com/alibaba/MNN" target="_blank" rel="external"><strong>MNN</strong></a><strong> </strong>等框架都采用了 <strong>FlatBuffer</strong>，这是一种具备 <code>Access to serialized data without parsing/unpacking</code> 的存储结构。它不仅减少了模型的存储大小、提升了性能，也对模型结构扩展、解析自描述起到了巨大的帮助。</p>
<p>尤其是协议自解析方面，真是令我大开眼界。简单来说，你只要按照 <strong>FlatBuffer Schema 要求的方式定义你的数据结构，剩下的编码 / 解析的过程都自动化完成。</strong></p>
<p>这里以 <a href="https://github.com/alibaba/MNN" target="_blank" rel="external"><strong>MNN</strong></a> 框架中的 <strong>FlatBuffer</strong> 的使用举例，比如整个神经网络的拓扑架构定义如下：</p>
<figure class="highlight css"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br></pre></td><td class="code"><pre><span class="line"><span class="tag">table</span> <span class="tag">Net</span> <span class="rules">&#123;</span><br><span class="line">    <span class="rule"><span class="attribute">bizCode</span>:<span class="value"> string</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">extraTensorDescribe</span>:<span class="value"> [TensorDescribe]</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">gpulibrary</span>:<span class="value"> GpuLibrary</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">oplists</span>:<span class="value"> [Op]</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">outputName</span>:<span class="value"> [string]</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">preferForwardType</span>:<span class="value"> ForwardType = CPU</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">sourceType</span>:<span class="value"> NetSource = CAFFE</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">tensorName</span>:<span class="value"> [string]</span></span>;</span><br><span class="line">    <span class="rule"><span class="attribute">tensorNumber</span>:<span class="value"> int = <span class="number">0</span></span></span>;</span><br><span class="line">&#125;</span></span><br></pre></td></tr></table></figure>
<blockquote>
<p>整体 MNN 中 Schema 的设计可以参考：<a href="https://github.com/alibaba/MNN/tree/master/schema/default" target="_blank" rel="external">https://github.com/alibaba/MNN/tree/master/schema/default</a></p>
</blockquote>
<p>然后我们通过一行简单的命令（这里仅作演示举例）就可以自动生成 JavaScript 的对应代码。</p>
<figure class="highlight"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">./flatc -s -I ~/MNN/schema/default ~/MNN/schema/default/MNN.fbs</span><br></pre></td></tr></table></figure>
<figure class="highlight"><table><tr><td class="gutter"><pre><span class="line">1</span><br></pre></td><td class="code"><pre><span class="line">/**&#10; * @constructor&#10; */&#10;MNN.Net = function() &#123;&#10;  /**&#10;   * @type &#123;flatbuffers.ByteBuffer&#125;&#10;   */&#10;  this.bb = null;&#10;&#10;  /**&#10;   * @type &#123;number&#125;&#10;   */&#10;  this.bb_pos = 0;&#10;&#125;;&#10;&#10;/**&#10; * @param &#123;number&#125; i&#10; * @param &#123;flatbuffers.ByteBuffer&#125; bb&#10; * @returns &#123;MNN.Net&#125;&#10; */&#10;MNN.Net.prototype.__init = function(i, bb) &#123;&#10;  this.bb_pos = i;&#10;  this.bb = bb;&#10;  return this;&#10;&#125;;&#10;&#10;/**&#10; * @param &#123;flatbuffers.ByteBuffer&#125; bb&#10; * @param &#123;MNN.Net=&#125; obj&#10; * @returns &#123;MNN.Net&#125;&#10; */&#10;MNN.Net.getRootAsNet = function(bb, obj) &#123;&#10;  return (obj || new MNN.Net).__init(bb.readInt32(bb.position()) + bb.position(), bb);&#10;&#125;;&#10;&#10;/**&#10; * @param &#123;flatbuffers.ByteBuffer&#125; bb&#10; * @param &#123;MNN.Net=&#125; obj&#10; * @returns &#123;MNN.Net&#125;&#10; */&#10;MNN.Net.getSizePrefixedRootAsNet = function(bb, obj) &#123;&#10;  return (obj || new MNN.Net).__init(bb.readInt32(bb.position()) + bb.position(), bb);&#10;&#125;;&#10;&#10;/**&#10; * @param &#123;number&#125; index&#10; * @param &#123;MNN.TensorDescribe=&#125; obj&#10; * @returns &#123;MNN.TensorDescribe&#125;&#10; */&#10;MNN.Net.prototype.extraTensorDescribe = function(index, obj) &#123;&#10;  var offset = this.bb.__offset(this.bb_pos, 6);&#10;  return offset ? (obj || new MNN.TensorDescribe).__init(this.bb.__indirect(this.bb.__vector(this.bb_pos + offset) + index * 4), this.bb) : null;&#10;&#125;;&#10;&#10;/**&#10; * @returns &#123;number&#125;&#10; */&#10;MNN.Net.prototype.extraTensorDescribeLength = function() &#123;&#10;  var offset = this.bb.__offset(this.bb_pos, 6);&#10;  return offset ? this.bb.__vector_len(this.bb_pos + offset) : 0;&#10;&#125;;&#10;&#10;/**&#10; * @param &#123;number&#125; index&#10; * @param &#123;MNN.Op=&#125; obj&#10; * @returns &#123;MNN.Op&#125;&#10; */&#10;MNN.Net.prototype.oplists = function(index, obj) &#123;&#10;  var offset = this.bb.__offset(this.bb_pos, 10);&#10;  return offset ? (obj || new MNN.Op).__init(this.bb.__indirect(this.bb.__vector(this.bb_pos + offset) + index * 4), this.bb) : null;&#10;&#125;;</span><br></pre></td></tr></table></figure>
<p>而用户在代码中使用这个拓扑结构，只要简单调用入口函数 <strong>getRootAsNet ，剩下来的一切都自动化完成。而当你要修改结构定义的时候，仅仅需要修改对应的 Schema 文件，重新生成对应的解析文件，无需人工逐字段手工修改。</strong></p>
<blockquote>
<p>限于篇幅有限，这里不过多展开对 <strong>FlatBuffer</strong> 的介绍，感兴趣的读者可以阅读 <a href="https://github.com/alibaba/MNN" target="_blank" rel="external"><strong>MNN</strong></a> 用户自发写的博客《<a href="https://www.jianshu.com/p/8eb153c12a4b" target="_blank" rel="external">FlatBuffers，MNN模型存储结构基础 —- 无法解读MNN模型文件的秘密</a>》。</p>
</blockquote>
<p><b style="color:red">那这样的协议能不能应用于移动开发中并起到正向的作用呢？</b>答案是肯定的，有兴趣的朋友可以阅读 Facebook 的相关文章。</p>
<h4 id="汇编知识的深度掌握">汇编知识的深度掌握</h4><p>部分读者可能知道，我和几位同事在知乎上开了一个专栏<a href="https://zhuanlan.zhihu.com/c_142064221" target="_blank" rel="external">《iOS调试进阶》</a>，重点分享 ARM 相关的汇编知识。会有这个想法是因为日常工作中排查许多 Crash 的时候，从源码层面已经无法定位，必须要依赖计算机执行的本质 - 机器码进行分析，而这正是汇编可以产生价值的地方。</p>
<p>但是汇编不仅仅局限于排查 Crash。在开发 <a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a> 过程中，涉及了大量的密集型计算操作。团队的一些大牛在<strong>指令实现层面根据流水线编排、硬件大小核数、缓存大小等等，使用手写汇编来精细化调度数据的读写与执行，使得MNN 的推理性能达到了业界一流的水准</strong>（无论是我们自己的 benchmark 抑或是利益无关的友商的评测都证明了这一点）。而阅读这些<strong>精心酿造的</strong>汇编代码，会让你感到，原来开发还能这么玩！</p>
<p>这里展示一个经典的 <strong>Bilinear </strong>插值通过汇编的实现：</p>
<figure class="highlight"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br><span class="line">46</span><br><span class="line">47</span><br><span class="line">48</span><br><span class="line">49</span><br><span class="line">50</span><br><span class="line">51</span><br><span class="line">52</span><br><span class="line">53</span><br><span class="line">54</span><br><span class="line">55</span><br><span class="line">56</span><br><span class="line">57</span><br><span class="line">58</span><br><span class="line">59</span><br><span class="line">60</span><br><span class="line">61</span><br></pre></td><td class="code"><pre><span class="line">text</span><br><span class="line">  .align 5</span><br><span class="line">  </span><br><span class="line">  asm_function MNNBilinearProcC1</span><br><span class="line">  //void MNNBilinearProcC1(const unsigned char *sample, unsigned char* dst, const int16_t* xFactor, const int16_t* yFactor, size_t w);</span><br><span class="line">  </span><br><span class="line">  //Auto: x0:sample, x1:dst, x2:xFactor, x3:yFactor, x4:w</span><br><span class="line">  </span><br><span class="line">  ld1 &#123;v31.s&#125;[0], [x3]</span><br><span class="line">  //Now x3 is no used</span><br><span class="line">  dup v30.4h, v31.h[0]</span><br><span class="line">  dup v31.4h, v31.h[1]</span><br><span class="line">  </span><br><span class="line">  L8:</span><br><span class="line">  cmp x4, #8</span><br><span class="line">  blt End</span><br><span class="line">  </span><br><span class="line">  LoopL8:</span><br><span class="line">      ld4 &#123;v4.8b, v5.8b, v6.8b, v7.8b&#125;, [x0], #32</span><br><span class="line">      ld2 &#123;v0.8h, v1.8h&#125;, [x2], #32//q0, q1</span><br><span class="line">      //(x00,x01) -&gt; (y0)</span><br><span class="line">      uxtl v2.8h, v4.8b</span><br><span class="line">      uxtl v3.8h, v5.8b</span><br><span class="line">      umull v16.4s, v2.4h, v0.4h</span><br><span class="line">      umull2 v17.4s, v2.8h, v0.8h</span><br><span class="line">      umlal v16.4s, v3.4h, v1.4h</span><br><span class="line">      umlal2 v17.4s, v3.8h, v1.8h</span><br><span class="line">  </span><br><span class="line">      uqshrn v18.4h, v16.4s, #4</span><br><span class="line">      uqshrn v19.4h, v17.4s, #4</span><br><span class="line">  </span><br><span class="line">      //(x10,x11) -&gt; (y1)</span><br><span class="line">      uxtl v2.8h, v6.8b</span><br><span class="line">      uxtl v3.8h, v7.8b</span><br><span class="line">      umull v16.4s, v2.4h, v0.4h</span><br><span class="line">      umull2 v17.4s, v2.8h, v0.8h</span><br><span class="line">      umlal v16.4s, v3.4h, v1.4h</span><br><span class="line">      umlal2 v17.4s, v3.8h, v1.8h</span><br><span class="line">  </span><br><span class="line">      uqshrn v20.4h, v16.4s, #4</span><br><span class="line">      uqshrn v21.4h, v17.4s, #4</span><br><span class="line">  </span><br><span class="line">      //(y0,y1) -&gt; dst</span><br><span class="line">      umull v16.4s, v18.4h, v30.4h</span><br><span class="line">      umull v17.4s, v19.4h, v30.4h</span><br><span class="line">      umlal v16.4s, v20.4h, v31.4h</span><br><span class="line">      umlal v17.4s, v21.4h, v31.4h</span><br><span class="line">  </span><br><span class="line">      uqshrn v2.4h, v16.4s, #16</span><br><span class="line">      uqshrn2 v2.8h, v17.4s, #16</span><br><span class="line">  </span><br><span class="line">      uqrshrn v0.8b, v2.8h, #2</span><br><span class="line">  </span><br><span class="line">      st1 &#123;v0.8b&#125;, [x1], #8</span><br><span class="line">  </span><br><span class="line">  </span><br><span class="line">      sub x4, x4, #8</span><br><span class="line">      cmp x4, #8</span><br><span class="line">      bge LoopL8</span><br><span class="line">  </span><br><span class="line">  End:</span><br></pre></td></tr></table></figure>
<p><b style="color:red">相信我，当你从不懂汇编 -&gt; 读懂汇编 -&gt; 手写汇编，每前进一步，你会发现更广阔的天地。</b>有一天当你要做性能优化，发现许多网上常见的手段都使用过了但仍然不起作用的时候，也许汇编就是你杀手锏。</p>
<h4 id="GPU_相关知识融合">GPU 相关知识融合</h4><p>近些年来随着短视频的崛起，市面上渲染、多媒体相关的岗位也越加变得火热。而这些岗位无一例外都需要对 GPU 有着深度的了解。而操作 GPU，自然而然就少不了与 Shader 打交道。</p>
<blockquote>
<p>Shader 其实就是专门用来渲染图形的一种技术。通过 Shader ，我们可以自定义显卡渲染画面的算法，使画面达到我们想要的效果。</p>
</blockquote>
<p>但 Shader 的作用不仅仅作用于渲染。在机器学习领域，苹果的 Metal 框架所包含的Metal Performance Shader（MPS）也能用来做 GPU 计算，提升机器学习在移动端的执行性能。就连诞生已久的 OpenGL，也在最新的 <strong>OpenGL 3</strong> 标准中增加了<b style="color:red">计算纹理</b>，支持 GPU 计算的能力。由此可见，尽管最初的目的并不相同，但是技术本质是相通的，最后都会产生微妙的化学反应。</p>
<p><strong>上述几点，仅仅是个人抛砖引玉，展示机器学习和日常移动开发相互交织的冰山一角</strong>。从工程实现的角度，仍有许多值得探索并实践应用的，欢迎大家一起探讨交流。</p>
<hr>
<p><a name="RC2H2"></a></p>
<h3 id="与大家携手一起进步">与大家携手一起进步</h3><p>读到这，可能有些读者内心的兴奋之情被熊熊点燃，恨不得立刻能将相关的知识学习起来；但也有部分朋友会觉得，可能只有 BAT 这样的大厂才会有实际的场景需要进行如此深入的研究和开发工作，有沮丧之情。</p>
<p>我对这种体会特别感同身受，因为去年刚转型开发 <strong><a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a> </strong>之初，我也有过手足无促，连简单的 Metal Performance Shader 都写不好。加上之前有些朋友通过 QCon 和云栖大会听闻了 <strong><a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a></strong>，也和我或其他同事进行过一些实现上或者应用方面的探讨。</p>
<p>因此，借着这个机会，除了希望通过这篇文章带领大家对<strong>【机器学习系统】</strong>有一个全新的认知之外，<strong>后续也会以连载的方式</strong>，<strong>在以下两个方面给大家继续带来更多有价值的点：</strong></p>
<ul>
<li><p><strong>技术介绍</strong>，我会把 <strong><a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a> </strong>里面使用的相关技术点，逐个拆解，带领大家通过理论探索和实际编程相结合的方式来深入了解细节，反哺于大家日常的开发工作。</p>
</li>
<li><p><strong>最佳实践</strong>，目前在客户端领域应用机器学习的典型案例还比较缺乏。而我正好在过去一年多的时间里，探索了诸多的实践案例（比如<strong>大家耳熟能详的拍立淘、淘宝直播、AR试妆等等中都有 MNN 的身影哦～</strong>），我也会将其整理分享出来，<strong>和大家一起探索端智能的前行之路</strong>。</p>
</li>
</ul>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnn_4.png?raw=true" alt=""></p>
<p>对了，写了这么多文字，还请读者们见谅，<strong>允许我打个招人合作的广告吧</strong>：</p>
<p><strong><a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a></strong> 是阿里巴巴开源的一款轻量级、高性能深度学习推理引擎，用于<strong>解决深度神经网络模型在端侧推理运行问题。</strong></p>
<p>从今年4月份开源到现在，我们始终在完善和响应社区用户的诉求，并保持着每两个月一次重大 Feature Release 的发布频率。</p>
<p>但我们团队的力量是有限的，而端上智能应用前进的道路仍然充满着广阔未被探索的区域，我们希望和大家一起教学相长，携手进步。</p>
<p>如果大家对移动端机器学习有什么好的想法和建议，也可以前往 <a href="https://github.com/alibaba/MNN" target="_blank" rel="external">Github</a> 上，给我们反馈。</p>
<p>也欢迎对 <a href="https://github.com/alibaba/MNN" target="_blank" rel="external"><strong>MNN</strong></a><strong> </strong>感兴趣的朋友，扫描二维码，加入钉钉群，和我们一起交流或者直接加入我们团队哦（悄悄地说，人气有点高，一群都满啦）</p>
<blockquote>
<p>用钉钉群比较方便我们在工作闲暇时间及时响应大家的问题和诉求，请大家多包涵啦～</p>
</blockquote>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnn_5.jpeg?raw=true" alt=""></p>
<h3 id="结语">结语</h3><p>本文记录了过去一年多，个人参与 <strong><a href="https://github.com/alibaba/MNN" target="_blank" rel="external">MNN</a></strong> 框架相关开发过程中的一些收获与心得。<b style="color:red">如何不分裂的看待机器学习与移动开发的关系，如何从看似不相关的领域寻找共同点，提升自己所处领域的价值和核心能力，是值得我们每位开发同学需要思考的。</b></p>
<p>在最后，还是要说一句：<strong>移动客户端的从业人员并不需要过多的焦虑和担忧，动态化、高性能、内核、渲染等等方向都充满前景。但是，你需要找到你所擅长且愿意为之深入的，这才是你保证在浪潮中不被拍翻的核心竞争力。</strong></p>
]]></content>
    <summary type="html">
    <![CDATA[<h3 id="题记">题记</h3><p>相信从事移动开发的朋友们肯定看到过一个表情包：“iOS 开发没人要啦”。</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnn_1.jpeg?raw=t]]>
    </summary>
    
      <category term="Machine Learning" scheme="http://satanwoo.github.io/tags/Machine-Learning/"/>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[Revisit iOS Autorelease之二]]></title>
    <link href="http://satanwoo.github.io/2019/07/07/RevisitAutorelease2/"/>
    <id>http://satanwoo.github.io/2019/07/07/RevisitAutorelease2/</id>
    <published>2019-07-07T14:44:00.000Z</published>
    <updated>2019-07-07T14:46:49.000Z</updated>
    <content type="html"><![CDATA[<h2 id="Revisit_iOS_Autorelease（二）：为啥生成的优化没有了。">Revisit iOS Autorelease（二）：为啥生成的优化没有了。</h2><p>在<a href="http://satanwoo.github.io/2019/07/02/RevisitAutorelease/">Revisit iOS Autorelease（一）</a>中，按照我的示例我提及，是如下这段代码对基于<code>TLS</code>的优化产生了影响：</p>
<pre><code><span class="comment">// Debug 模式</span>
<span class="keyword">for</span> (Model *m <span class="keyword">in</span> <span class="keyword">self</span><span class="variable">.models</span>) {      
}
</code></pre><p>这段看似平平无奇的代码为啥会造成优化失效，让我们还是从汇编角度来看看：</p>
<pre><code><span class="number">0x100011e90</span> &lt;+<span class="number">568</span>&gt;: ldr    x0, [sp, <span class="preprocessor">#<span class="number">0x10</span>]</span>

<span class="comment">// 【注意点】：正常情况下应该是b objc_autoreleaseReturnValue</span>
<span class="number">0x100011e94</span> &lt;+<span class="number">572</span>&gt;: bl     <span class="number">0x100012904</span>               ; symbol stub <span class="keyword">for</span>: objc_autoreleaseReturnValue
<span class="number">0x100011e98</span> &lt;+<span class="number">576</span>&gt;: adrp   x8, <span class="number">3</span>
<span class="number">0x100011e9c</span> &lt;+<span class="number">580</span>&gt;: ldr    x8, [x8, <span class="preprocessor">#<span class="number">0x8</span>]</span>
<span class="number">0x100011ea0</span> &lt;+<span class="number">584</span>&gt;: ldr    x8, [x8]
<span class="number">0x100011ea4</span> &lt;+<span class="number">588</span>&gt;: ldur   x9, [x29, <span class="preprocessor">#-<span class="number">0x18</span>]</span>
<span class="number">0x100011ea8</span> &lt;+<span class="number">592</span>&gt;: cmp    x8, x9
<span class="number">0x100011eac</span> &lt;+<span class="number">596</span>&gt;: str    x0, [sp, <span class="preprocessor">#<span class="number">0x8</span>]</span>
<span class="number">0x100011eb0</span> &lt;+<span class="number">600</span>&gt;: b.ne   <span class="number">0x100011ec8</span>               ; &lt;+<span class="number">624</span>&gt; at Container.m
<span class="number">0x100011eb4</span> &lt;+<span class="number">604</span>&gt;: ldr    x0, [sp, <span class="preprocessor">#<span class="number">0x8</span>]</span>
<span class="number">0x100011eb8</span> &lt;+<span class="number">608</span>&gt;: ldp    x29, x30, [sp, <span class="preprocessor">#<span class="number">0x170</span>]</span>
<span class="number">0x100011ebc</span> &lt;+<span class="number">612</span>&gt;: ldp    x28, x27, [sp, <span class="preprocessor">#<span class="number">0x160</span>]</span>
<span class="number">0x100011ec0</span> &lt;+<span class="number">616</span>&gt;: add    sp, sp, <span class="preprocessor">#<span class="number">0x180</span>            ; =<span class="number">0x180</span> </span>
<span class="number">0x100011ec4</span> &lt;+<span class="number">620</span>&gt;: ret    
<span class="number">0x100011ec8</span> &lt;+<span class="number">624</span>&gt;: bl     <span class="number">0x1000128d4</span>               ; symbol stub <span class="keyword">for</span>: __stack_chk_fail
<span class="number">0x100011ecc</span> &lt;+<span class="number">628</span>&gt;: brk    <span class="preprocessor">#<span class="number">0x1</span></span>
</code></pre><p>按照符号优化的场景，<code>LR</code>寄存器的地址需要指向获取<code>Model</code>的外部调用方才能产生正确的优化，因此<b style="color:red">正常情况下应该直接<code>b objc_autoreleaseReturnValue</code>即可</b>，而这里对应的汇编却是<code>bl</code>，说明执行完<code>objc_autoreleaseReturnValue</code>后还要继续从<code>0x100011e98 &lt;+576&gt;: adrp   x8, 3</code>往后执行。</p>
<p>虽然这么一大段汇编很难具体了解做的每一件事的意义，但是从几个关键点上我们可以描绘出一个轮廓：</p>
<ul>
<li><code>cmp x8, x9</code>肯定在试图检查什么条件。</li>
<li><code>b.ne   0x100011ec8</code>，如果条件满足，继续走（1），否则走（2）</li>
<li>（1）最后是栈恢复和<code>ret</code>，说明这是正确的流程。</li>
<li>（2）看到了一个比较陌生的符号<code>__stack_chk_fail</code>，暂且不管。但是紧跟着就是<code>brk</code>。而<code>brk</code>简单来讲，就是触发崩溃或者异常。</li>
</ul>
<p>整体轮廓搞定后，我们再来看看<code>stack_chk_fail</code>到底是啥。从<code>stack</code>中我们不难推断，这肯定是和栈相关的检查工作。那为什么会有这样的检查工作？主要还是害怕栈越界造成的危害。用下图来大致讲解吧。</p>
<p><img src="https://bbsmax.ikafan.com/static/L3Byb3h5L2h0dHAvaW1hZ2VzMjAxNS5jbmJsb2dzLmNvbS9ibG9nLzc0MDk4OS8yMDE1MTEvNzQwOTg5LTIwMTUxMTA5MjIzMjAxNzU5LTQ2MTU2MDEwMy5wbmc=.jpg" alt=""></p>
<blockquote>
<p>这里抄了张<code>armv7</code>的图，大致意思没差别。</p>
</blockquote>
<p><strong>局部变量和保存函数调用上下文的<code>LR</code>, <code>FP</code>都存在栈上。假设我们的局部变量是个大小为2的数组，但是我如果不小心写出了*(addr + 3) = 5。是不是相当于数组越界，破坏了紧邻着的其他栈内容。如果这个栈内容是重要的上下文信息，那就完蛋了。</strong></p>
<p><b style="color:red">那栈越界究竟有什么具体事例呢？嘿嘿，欢迎加入阿里巴巴来内网看我写的关于<code>xxx</code>问题的分析，你就知道了。</b></p>
<p>所以，在LLVM::CodeGen里面，就帮我们做了这样的栈越界检查（当然对于很多动态的数组也是没法完全防护的），在<code>StackProtector.cpp</code>中：</p>
<pre><code><span class="keyword">bool</span> StackProtector::InsertStackProtectors() {
   <span class="comment">// Loop through the basic blocks that have return instructions. Convert this:</span>
   <span class="comment">//</span>
   <span class="comment">//   return:</span>
   <span class="comment">//     ...</span>
   <span class="comment">//     ret ...</span>
   <span class="comment">//</span>
   <span class="comment">// into this:</span>
   <span class="comment">//</span>
   <span class="comment">//   return:</span>
   <span class="comment">//     ...</span>
   <span class="comment">//     %1 = load __stack_chk_guard</span>
   <span class="comment">//     %2 = load &lt;stored stack guard&gt;</span>
   <span class="comment">//     %3 = cmp i1 %1, %2</span>
   <span class="comment">//     br i1 %3, label %SP_return, label %CallStackCheckFailBlk</span>
   <span class="comment">//</span>
   <span class="comment">//   SP_return:</span>
   <span class="comment">//     ret ...</span>
   <span class="comment">//</span>
   <span class="comment">//   CallStackCheckFailBlk:</span>
   <span class="comment">//     call void @__stack_chk_fail()</span>
   <span class="comment">//     unreachable</span>
   <span class="comment">//</span>
   BasicBlock *FailBB = <span class="number">0</span>;       <span class="comment">// The basic block to jump to if check fails.</span>
   AllocaInst *AI = <span class="number">0</span>;           <span class="comment">// Place on stack that stores the stack guard.</span>
   Constant *StackGuardVar = <span class="number">0</span>;  <span class="comment">// The stack guard variable.</span>

   <span class="keyword">for</span> (<span class="function"><span class="keyword">Function</span>::<span class="title">iterator</span> <span class="title">I</span> = <span class="title">F</span>-&gt;<span class="title">begin</span><span class="params">()</span>, <span class="title">E</span> = <span class="title">F</span>-&gt;<span class="title">end</span><span class="params">()</span></span>; I != E; ) {
     BasicBlock *BB = I;

     <span class="keyword">if</span> (ReturnInst *RI = dyn_cast&lt;ReturnInst&gt;(BB-&gt;getTerminator())) {
       <span class="keyword">if</span> (!FailBB) {
         <span class="comment">// Insert code into the entry block that stores the __stack_chk_guard</span>
         <span class="comment">// variable onto the stack.</span>
         PointerType *PtrTy = PointerType::getUnqual(Type::Int8Ty);
         StackGuardVar = M-&gt;getOrInsertGlobal(<span class="string">"__stack_chk_guard"</span>, PtrTy);

         BasicBlock &amp;Entry = F-&gt;getEntryBlock();
         Instruction *InsPt = &amp;Entry.front();

         AI = <span class="keyword">new</span> AllocaInst(PtrTy, <span class="string">"StackGuardSlot"</span>, InsPt);
         LoadInst *LI = <span class="keyword">new</span> LoadInst(StackGuardVar, <span class="string">"StackGuard"</span>, <span class="keyword">false</span>, InsPt);

         Value *Args[] = { LI, AI };
         CallInst::
           Create(Intrinsic::getDeclaration(M, Intrinsic::stackprotector_create),
                  &amp;Args[<span class="number">0</span>], array_endof(Args), <span class="string">""</span>, InsPt);

         <span class="comment">// Create the basic block to jump to when the guard check fails.</span>
         FailBB = CreateFailBB();
       }

-      <span class="function"><span class="keyword">Function</span>::<span class="title">iterator</span> <span class="title">InsPt</span> = <span class="title">BB</span></span>; ++InsPt; <span class="comment">// Insertion point for new BB.</span>
       ++I; <span class="comment">// Skip to the next block so that we don't resplit the return block.</span>

       <span class="comment">// Split the basic block before the return instruction.</span>
       BasicBlock *NewBB = BB-&gt;splitBasicBlock(RI, <span class="string">"SP_return"</span>);

-      <span class="comment">// Move the newly created basic block to the point right after the old basic</span>
-      <span class="comment">// block so that it's in the "fall through" position.</span>
+      <span class="comment">// Move the newly created basic block to the point right after the old</span>
+      <span class="comment">// basic block so that it's in the "fall through" position.</span>
       NewBB-&gt;removeFromParent();
-      F-&gt;getBasicBlockList().insert(InsPt, NewBB);
+      F-&gt;getBasicBlockList().insert(I, NewBB);

       <span class="comment">// Generate the stack protector instructions in the old basic block.</span>
       LoadInst *LI1 = <span class="keyword">new</span> LoadInst(StackGuardVar, <span class="string">""</span>, <span class="keyword">false</span>, BB);
       CallInst *CI = CallInst::
         Create(Intrinsic::getDeclaration(M, Intrinsic::stackprotector_check),
                AI, <span class="string">""</span>, BB);
       ICmpInst *Cmp = <span class="keyword">new</span> ICmpInst(CmpInst::ICMP_EQ, CI, LI1, <span class="string">""</span>, BB);
       BranchInst::Create(NewBB, FailBB, Cmp, BB);
     } <span class="keyword">else</span> {
       ++I;
     }
   }

   <span class="comment">// Return if we didn't modify any basic blocks. I.e., there are no return</span>
   <span class="comment">// statements in the function.</span>
   <span class="keyword">if</span> (!FailBB) <span class="keyword">return</span> <span class="keyword">false</span>;

   <span class="keyword">return</span> <span class="keyword">true</span>;
 }

 <span class="comment">/// CreateFailBB - Create a basic block to jump to when the stack protector</span>
 <span class="comment">/// check fails.</span>
 BasicBlock *StackProtector::CreateFailBB() {
   BasicBlock *FailBB = BasicBlock::Create(<span class="string">"CallStackCheckFailBlk"</span>, F);
   Constant *StackChkFail =
     M-&gt;getOrInsertFunction(<span class="string">"__stack_chk_fail"</span>, Type::VoidTy, <span class="keyword">NULL</span>);
   CallInst::Create(StackChkFail, <span class="string">""</span>, FailBB);
   <span class="keyword">new</span> UnreachableInst(FailBB);
   <span class="keyword">return</span> FailBB;
 }
</code></pre><p>还是比较容易看懂的，这里就不过多解释了。</p>
<h3 id="后记">后记</h3><p><code>autorelease</code>相关的文章网上不在少数，但是大多数都大同小异，只是在讲<code>libobjc</code>中的代码实现。但是深究我们日常编码过程中的<code>autorelease</code>，其实有不少被我们所忽视的细节值得深挖研究。（不挖还容易踩坑）</p>
<p>最后按照惯例，以一首诗致敬伟大的90后<code>iOS</code>第一人Y帝：</p>
<p>吾辈有Y帝，技术特牛逼。</p>
<p>胸有中国情，一人虐美帝。</p>
<p>Google服务器，Y帝轻松逆。</p>
<p>苹果App，他天天Patch。</p>
<p>微软的程序，总被他蓝屏。</p>
<p>川普各手机，监听so easy。</p>
<p>为躲粉丝迷，转行写程序。</p>
<p>90后第一，当代方世玉！</p>
]]></content>
    <summary type="html">
    <![CDATA[<h2 id="Revisit_iOS_Autorelease（二）：为啥生成的优化没有了。">Revisit iOS Autorelease（二）：为啥生成的优化没有了。</h2><p>在<a href="http://satanwoo.github.io/2019/07/02]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[Revisit iOS Autorelease 之不经意间可能被影响的优化]]></title>
    <link href="http://satanwoo.github.io/2019/07/02/RevisitAutorelease/"/>
    <id>http://satanwoo.github.io/2019/07/02/RevisitAutorelease/</id>
    <published>2019-07-02T13:53:12.000Z</published>
    <updated>2019-07-02T13:57:58.000Z</updated>
    <content type="html"><![CDATA[<blockquote>
<p>本文的硬核在第二段</p>
</blockquote>
<p>之前在做某项目的时候，自建了基于<code>NSThread</code>的私有线程池，在线程池分配了固定个数的常驻工作线程，在工作线程里面运行相关任务；这个方案取代了原先直接无脑使用<code>GCD</code>的方式，在各方面效果都还不错。</p>
<p>但是在一次偶然的情况下，通过<code>Memory Graph</code>发现很多<strong>任务</strong>对象却在<strong>本该早就销毁的时候</strong>仍然存活着。持有其的对象是<code>autorelease content</code>，如下图所示：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/autorelease_r1.png?raw=true" alt="屏幕快照 2019-06-20 下午8.22.39"></p>
<blockquote>
<p>我把数据对象类型隐藏了，公司数据还是要保密。</p>
</blockquote>
<p>那这个东西究竟是个啥呢？</p>
<blockquote>
<p>由于其是<strong>黄色图标</strong>，基本上是一个容器类型或其子类。</p>
</blockquote>
<p>这个类型<code>@autoreleasepool content</code>先不管，先从右边的堆栈来看：</p>
<ul>
<li>某个方法调用了<code>autorelease</code>相关的API</li>
<li>由于我是在子线程触发的，<b style="color:red">没有显示创建的<code>autoreleasepool</code>。因此需要调用<code>autoreleaseNoPage</code></b></li>
</ul>
<p>而<code>autoreleaseNoPage</code>其实本质上就是在当前线程没有<code>autoreleasePage</code>的时候，创建一个。然后通过<code>Thread Local Storage</code>存入线程相关上下文中。</p>
<pre><code><span class="keyword">static</span> __attribute__((noinline))
    <span class="keyword">id</span> *autoreleaseNoPage(<span class="keyword">id</span> obj)
    {
        <span class="comment">// "No page" could mean no pool has been pushed</span>
        <span class="comment">// or an empty placeholder pool has been pushed and has no contents yet</span>
        assert(!hotPage());

        <span class="keyword">bool</span> pushExtraBoundary = <span class="literal">false</span>;
        <span class="keyword">if</span> (haveEmptyPoolPlaceholder()) {
            <span class="comment">// We are pushing a second pool over the empty placeholder pool</span>
            <span class="comment">// or pushing the first object into the empty placeholder pool.</span>
            <span class="comment">// Before doing that, push a pool boundary on behalf of the pool </span>
            <span class="comment">// that is currently represented by the empty placeholder.</span>
            pushExtraBoundary = <span class="literal">true</span>;
        }
        <span class="keyword">else</span> <span class="keyword">if</span> (obj != POOL_BOUNDARY  &amp;&amp;  DebugMissingPools) {
            <span class="comment">// We are pushing an object with no pool in place, </span>
            <span class="comment">// and no-pool debugging was requested by environment.</span>
            _objc_inform(<span class="string">"MISSING POOLS: (%p) Object %p of class %s "</span>
                         <span class="string">"autoreleased with no pool in place - "</span>
                         <span class="string">"just leaking - break on "</span>
                         <span class="string">"objc_autoreleaseNoPool() to debug"</span>, 
                         pthread_self(), (<span class="keyword">void</span>*)obj, object_getClassName(obj));
            objc_autoreleaseNoPool(obj);
            <span class="keyword">return</span> <span class="literal">nil</span>;
        }
        <span class="keyword">else</span> <span class="keyword">if</span> (obj == POOL_BOUNDARY  &amp;&amp;  !DebugPoolAllocation) {
            <span class="comment">// We are pushing a pool with no pool in place,</span>
            <span class="comment">// and alloc-per-pool debugging was not requested.</span>
            <span class="comment">// Install and return the empty pool placeholder.</span>
            <span class="keyword">return</span> setEmptyPoolPlaceholder();
        }

        <span class="comment">// We are pushing an object or a non-placeholder'd pool.</span>

        <span class="comment">// Install the first page.</span>
        AutoreleasePoolPage *page = new AutoreleasePoolPage(<span class="literal">nil</span>);
        setHotPage(page);

        <span class="comment">// Push a boundary on behalf of the previously-placeholder'd pool.</span>
        <span class="keyword">if</span> (pushExtraBoundary) {
            page-&gt;add(POOL_BOUNDARY);
        }

        <span class="comment">// Push the requested object or pool.</span>
        <span class="keyword">return</span> page-&gt;add(obj);
    }
</code></pre><p>同时由于是第一个<code>page</code>，连父子关系都不用串联，非常简单。</p>
<p><b style="color:red">但是，其他线程有一点相对主线程比较坑的就是子线程默认没有<code>runloop</code>，导致在释放被<code>autoreleasepool</code>的对象的时候产生着问题。</b></p>
<p>那么子线程的<code>autoreleasepool</code>在没有<code>runloop</code>的情况下何时释放呢？</p>
<ul>
<li>线程退出的时候</li>
<li>局部<code>autoreleasepool drain</code>的时候</li>
</ul>
<p>第二点比较好理解，就是常规的<code>page push</code>以及对应的<code>page pop</code>。</p>
<p>那么线程退出释放是如何确定的呢？我们在线程退出的时候下个断点：</p>
<pre><code>static <span class="literal">void</span> tls_dealloc(<span class="literal">void</span> *p) 
{
    <span class="keyword">if</span> (p == (<span class="literal">void</span>*)EMPTY_POOL_PLACEHOLDER) {
        <span class="comment">// No objects or pool pages to clean up here.</span>
        <span class="keyword">return</span>;
    }

    <span class="comment">// reinstate TLS value while we work</span>
    setHotPage((AutoreleasePoolPage *)p);

    <span class="keyword">if</span> (AutoreleasePoolPage *page = coldPage()) {
        <span class="keyword">if</span> (<span class="subst">!</span>page<span class="subst">-&gt;</span>empty()) pop(page<span class="subst">-&gt;</span>begin());  <span class="comment">// pop all of the pools</span>
        <span class="keyword">if</span> (DebugMissingPools <span class="subst">||</span> DebugPoolAllocation) {
            <span class="comment">// pop() killed the pages already</span>
        } <span class="keyword">else</span> {
            page<span class="subst">-&gt;</span>kill();  <span class="comment">// free all of the pages</span>
        }
    }

    <span class="comment">// clear TLS value so TLS destruction doesn't loop</span>
    setHotPage(nil);
}
</code></pre><p>而在<code>runtime</code>初始化的过程中，会调用<code>AutoReleasePoolPage::init</code>方法注册<code>tls_dealloc</code>：</p>
<pre><code><span class="function"><span class="keyword">static</span> <span class="keyword">void</span> <span class="title">init</span><span class="params">()</span>
</span>{
    <span class="keyword">int</span> r __unused = pthread_key_init_np(AutoreleasePoolPage::key, 
                                         AutoreleasePoolPage::tls_dealloc);
    assert(r == <span class="number">0</span>);
}
</code></pre><p>结合这两段代码，我们大致可以猜测下<code>phtread_key_init_np</code>是将<code>tls_dealloc</code>注册给某个回调使用。那具体是干嘛的？</p>
<p>实际上<code>phtread_key_init_np</code>时给<code>thread</code>注册了线程销毁时的自定义析构函数，这里我们可以一起来看看<code>darwin-apple</code>的<code>libpthread</code>代码，这里我直接简化掉流程，输出大致的过程：</p>
<p><code>_pthread_exit</code> 在线程销毁时调用 -&gt; <code>_pthread_tsd_cleanup</code> -&gt; <code>_pthread_tsd_cleanup_new</code> -&gt; <code>_pthread_tsd_cleanup_key</code>。</p>
<p>在最终的函数里，会遍历所有的自定义销毁函数，逐个触发：</p>
<pre><code><span class="keyword">static</span> <span class="keyword">void</span>
_pthread_tsd_cleanup_key(<span class="keyword">pthread_t</span> self, <span class="keyword">pthread_key_t</span> key)
{
    <span class="keyword">void</span> (*destructor)(<span class="keyword">void</span> *);
    <span class="keyword">if</span> (_pthread_key_get_destructor(key, &amp;destructor)) {
        <span class="keyword">void</span> **ptr = &amp;self-&gt;tsd[key];
        <span class="keyword">void</span> *value = *ptr;
        <span class="keyword">if</span> (value) {
            *ptr = <span class="literal">NULL</span>;
            <span class="keyword">if</span> (destructor) {
                destructor(value);
            }
        }
    }
}
</code></pre><p><b style="color:red">因此，对于我这样设计了常驻线程的“不死线程”来说，无法指望线程销毁时候的释放，必须自己引入<code>autoreleasepool</code>来修正内存没释放干净！</b></p>
<h3 id="到底哪些东西会触发autorelease持有?">到底哪些东西会触发<code>autorelease</code>持有?</h3><p><b style="color:red">本文的重点来了。</b></p>
<p>其实网上关于<code>autoreleasepage</code>相关的文章分析的很多了，<b style="color:red">我这篇文章的主要目的还是想思考下，看看平常无奇的代码，究竟会在什么情况下触发<code>autorelease</code>及其相关行为。</b>如果说所有的东西都是直接了当的引用计数相加减如<code>objc_storeStrong / objc_storeStrong(nil)</code>，何须多此一举引入<code>autorelease</code>呢？</p>
<p>网上许多的文章的结论基本上都是：</p>
<blockquote>
<p>编译器为判断方法名是否是以<code>alloc/new/copy/mutableCopy</code>开头，如果不是，就自动将返回的对象注册到池子中。<br>编译器会在<code>objc_autoreleaseReturnValue</code>和<code>objc_retainAutoreleasedReturnValue</code>进行基于TLS的判断优化，本质上也不会走入autorelease的环节。</p>
</blockquote>
<p>为了验证这些结论，我首先重温了下《iOS 内存高级编程》一书，它所阐述的都是内存管理的思想，以<code>alloc/mew/copy/mutableCopy</code>驼峰命名开头的方法，方法的对象由调用者自己持有；而其他方法是<strong>取得非自己生成并持有的对象</strong></p>
<blockquote>
<p>卧槽，真拗口。</p>
</blockquote>
<p>写个Demo验证下，</p>
<pre><code>@interface <span class="keyword">Model</span> : NSObject
- (<span class="keyword">Model</span> *)haha;
@end

- (<span class="keyword">Model</span> *)haha
{
    // 这里是为了避免调用系统库的对象可能在存在某些MRC的情况导致无法优化。
    return [[<span class="keyword">Model</span> alloc] init];
}

// 调用
<span class="keyword">Model</span> *<span class="keyword">model</span> = [[<span class="keyword">Model</span> alloc] init];
<span class="keyword">Model</span> *m2 = [<span class="keyword">model</span> haha];
</code></pre><p><strong>万变不如汇编</strong>，让我们先来看第一条调用的汇编代码。</p>
<pre><code><span class="number">0x100046768</span> &lt;+<span class="number">96</span>&gt;:  bl     <span class="number">0x100046b80</span>               ; symbol stub <span class="keyword">for</span>: objc_msgSend
<span class="number">0x10004676c</span> &lt;+<span class="number">100</span>&gt;: adrp   x8, <span class="number">2</span>
<span class="number">0x100046770</span> &lt;+<span class="number">104</span>&gt;: add    x8, x8, <span class="preprocessor">#<span class="number">0xd38</span>            ; =<span class="number">0xd38</span> </span>
<span class="number">0x100046774</span> &lt;+<span class="number">108</span>&gt;: ldr    x1, [x8]
<span class="number">0x100046778</span> &lt;+<span class="number">112</span>&gt;: bl     <span class="number">0x100046b80</span>               ; symbol stub <span class="keyword">for</span>: objc_msgSend
<span class="number">0x10004677c</span> &lt;+<span class="number">116</span>&gt;: mov    x8, <span class="preprocessor">#<span class="number">0x0</span></span>
<span class="number">0x100046780</span> &lt;+<span class="number">120</span>&gt;: add    x9, sp, <span class="preprocessor">#<span class="number">0x8</span>              ; =<span class="number">0x8</span> </span>
<span class="number">0x100046784</span> &lt;+<span class="number">124</span>&gt;: str    x0, [sp, <span class="preprocessor">#<span class="number">0x8</span>]</span>
<span class="number">0x100046788</span> &lt;+<span class="number">128</span>&gt;: mov    x0, x9
<span class="number">0x10004678c</span> &lt;+<span class="number">132</span>&gt;: mov    x1, x8
<span class="number">0x100046790</span> &lt;+<span class="number">136</span>&gt;: bl     <span class="number">0x100046bb0</span>               ; symbol stub <span class="keyword">for</span>: objc_storeStrong
</code></pre><p>很明显的，并没有涉及到任何的和<code>retainAutorelease/autorelease</code>相关的调用。</p>
<blockquote>
<p>需要注意：在release优化下这里的<code>objc_storeStrong(nil)</code>会直接优化成<code>objc_release</code></p>
</blockquote>
<p>而对于第二条调用，汇编如下：</p>
<pre><code><span class="number">0x10006275c</span> &lt;+<span class="number">140</span>&gt;: bl     <span class="number">0x100062b80</span>               ; symbol stub <span class="keyword">for</span>: objc_msgSend
<span class="number">0x100062760</span> &lt;+<span class="number">144</span>&gt;: mov    x29, x29
<span class="number">0x100062764</span> &lt;+<span class="number">148</span>&gt;: bl     <span class="number">0x100062ba4</span>               ; symbol stub <span class="keyword">for</span>: objc_retainAutoreleasedReturnValue
</code></pre><p>关键字出现了，当然具体会不会进入autorelease的环节，还需要看优化的效果，我们进入<code>haha</code>函数看一看：</p>
<pre><code> <span class="number">0x100096b28</span> &lt;+<span class="number">36</span>&gt;: bl     <span class="number">0x100096b80</span>               ; symbol stub <span class="keyword">for</span>: objc_msgSend
<span class="number">0x100096b2c</span> &lt;+<span class="number">40</span>&gt;: adrp   x1, <span class="number">2</span>
<span class="number">0x100096b30</span> &lt;+<span class="number">44</span>&gt;: ldr    x1, [x1, <span class="preprocessor">#<span class="number">0xd38</span>]</span>
<span class="number">0x100096b34</span> &lt;+<span class="number">48</span>&gt;: bl     <span class="number">0x100096b80</span>               ; symbol stub <span class="keyword">for</span>: objc_msgSend
<span class="number">0x100096b38</span> &lt;+<span class="number">52</span>&gt;: ldp    x29, x30, [sp, <span class="preprocessor">#<span class="number">0x10</span>]</span>
<span class="number">0x100096b3c</span> &lt;+<span class="number">56</span>&gt;: add    sp, sp, <span class="preprocessor">#<span class="number">0x20</span>             ; =<span class="number">0x20</span> </span>
<span class="number">0x100096b40</span> &lt;+<span class="number">60</span>&gt;: b      <span class="number">0x100096b74</span>               ; symbol stub <span class="keyword">for</span>: objc_autoreleaseReturnValue
</code></pre><p>也和我们预测的一样，确实有着<code>objc_autoreleaseReturnValue</code>，那么究竟会不会有基于TLS的优化行为呢？对<code>objc_autoreleaseReturnValue</code>下个符号断点：</p>
<pre><code>libobjc.A.dylib`objc_autoreleaseReturnValue:
-&gt;  <span class="number">0x18563e528</span> &lt;+<span class="number">0</span>&gt;:  ldr    w8, [x30]
    <span class="number">0x18563e52c</span> &lt;+<span class="number">4</span>&gt;:  mov    w9, <span class="preprocessor">#-<span class="number">0x55e30000</span></span>
    <span class="number">0x18563e530</span> &lt;+<span class="number">8</span>&gt;:  movk   w9, <span class="preprocessor">#<span class="number">0x3fd</span></span>
    <span class="number">0x18563e534</span> &lt;+<span class="number">12</span>&gt;: cmp    w8, w9
    <span class="number">0x18563e538</span> &lt;+<span class="number">16</span>&gt;: b.ne   <span class="number">0x18563e550</span>               ; &lt;+<span class="number">40</span>&gt;
    <span class="number">0x18563e53c</span> &lt;+<span class="number">20</span>&gt;: mrs    x8, TPIDRRO_EL0
    <span class="number">0x18563e540</span> &lt;+<span class="number">24</span>&gt;: and    x8, x8, <span class="preprocessor">#<span class="number">0xfffffffffffffff8</span></span>
    <span class="number">0x18563e544</span> &lt;+<span class="number">28</span>&gt;: orr    w9, wzr, <span class="preprocessor">#<span class="number">0x1</span></span>
    <span class="number">0x18563e548</span> &lt;+<span class="number">32</span>&gt;: str    x9, [x8, <span class="preprocessor">#<span class="number">0x160</span>]</span>
    <span class="number">0x18563e54c</span> &lt;+<span class="number">36</span>&gt;: ret    
    <span class="number">0x18563e550</span> &lt;+<span class="number">40</span>&gt;: b      <span class="number">0x18563c130</span>               ; objc_autorelease
</code></pre><p>这里，偏移 +16的地方的<code>b.ne</code>就是对优化的判断，判断的条件是<code>w8</code>和<code>w9</code>的相等与否，不等就走传统的<code>objc_autorelease</code>。</p>
<p>这里经过断点我们发现确实走了优化。</p>
<p><b style="color:red">那按照这个思路，难道真的在如今的ARC下，没有东西要进<code>autoreleasepool</code>了？那为什么还会在<code>MemoryGraph</code>中出现大量<code>autorelease content</code>呢？</b></p>
<p><b style="color:red">答案可能出乎你的意料，<code>for</code>会影响这个<code>autorelease</code>优化逻辑。</b></p>
<p>我们构建一个两个线程的场景，<code>Model</code>类型如上述文章段落不变。构建一个符合类型<code>Container</code>，包含一个<code>NSMutableArray</code>的数组：</p>
<pre><code><span class="class"><span class="keyword">@interface</span> <span class="title">Container</span>()</span>
<span class="keyword">@property</span> (<span class="keyword">nonatomic</span>, <span class="keyword">strong</span>) <span class="built_in">NSMutableArray</span> *models;
<span class="keyword">@end</span>

<span class="class"><span class="keyword">@implementation</span> <span class="title">Container</span></span>

- (instancetype)init
{
    <span class="keyword">self</span> = [<span class="keyword">super</span> init];
    <span class="keyword">if</span> (<span class="keyword">self</span>) {
        _models = @[]<span class="variable">.mutableCopy</span>;

    }
    <span class="keyword">return</span> <span class="keyword">self</span>;
}

- (<span class="keyword">void</span>)addModel:(Model *)model
{
    <span class="keyword">if</span> (!model) <span class="keyword">return</span>;
    [<span class="keyword">self</span><span class="variable">.models</span> addObject:model];
}

- (Model *)takeModel
{
    <span class="comment">//NSMutableArray *toOperateArray = self.models;</span>
    <span class="keyword">for</span> (Model *model <span class="keyword">in</span> <span class="keyword">self</span><span class="variable">.models</span>) {
    }

    Model *model = [<span class="keyword">self</span><span class="variable">.models</span> firstObject];
    [<span class="keyword">self</span><span class="variable">.models</span> removeObject:model];

    <span class="keyword">return</span> model;
}
</code></pre><p>为了简化场景，我先在<code>ViewController viewDidLoad</code>塞入几个<code>Model</code>到<code>Container</code>，然后再启动第二个线程从<code>Container</code>中取<code>Model</code>。</p>
<p>测试场景如下：</p>
<pre><code>- (<span class="keyword">void</span>)viewDidLoad {
    [<span class="keyword">super</span> viewDidLoad];

    <span class="keyword">self</span><span class="variable">.container</span> = [[Container alloc] init];

    <span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; <span class="number">10</span>; i++) {
        [<span class="keyword">self</span><span class="variable">.container</span> addModel:[[Model alloc] initWithCount:i]];
    }

    <span class="keyword">self</span><span class="variable">.thread</span> = [[<span class="built_in">NSThread</span> alloc] initWithTarget:<span class="keyword">self</span> selector:<span class="keyword">@selector</span>(loop) object:<span class="literal">nil</span>];
    [<span class="keyword">self</span><span class="variable">.thread</span> setName:<span class="string">@"com.walle.test"</span>];
    [<span class="keyword">self</span><span class="variable">.thread</span> start];
}

- (<span class="keyword">void</span>)loop
{
    <span class="keyword">while</span> (<span class="literal">true</span>) {
        Model *m = [<span class="keyword">self</span><span class="variable">.container</span> takeModel];        
        [m increment];
    }
}
</code></pre><p>如果你执行我这段代码，你会发现的确如文章一开头所示，<code>MemoryGraph</code>中存在大量被<code>@autoreleasepool content</code>持有的<code>Model</code>。</p>
<p>那罪魁祸首是什么呢？<b style="color:red">从表象上看</b>是这段并不起眼的代码：</p>
<pre><code><span class="keyword">for</span> (<span class="constant">Model </span>*model <span class="keyword">in</span> <span class="keyword">self</span>.models) {
}
</code></pre><p>可具体原因是为啥呢？还是从汇编上来摸索下：</p>
<p>首先先回到没有汇编的场景上，调用的函数是<code>-[ViewController loop]</code>，被调用者是<code>-[Container takeModel:]</code></p>
<p>如果要进行优化，按照<code>objc_autoreleaseReturnValue：</code>的逻辑，在<code>loop</code>调用<code>takeModel:</code>的地方必须有对应的暗示：这个暗示在<code>arm64</code>中如下代码所示：</p>
<pre><code><span class="function"><span class="keyword">static</span> ALWAYS_INLINE <span class="keyword">bool</span> 
<span class="title">callerAcceptsOptimizedReturn</span><span class="params">(<span class="keyword">const</span> <span class="keyword">void</span> *ra)</span>
</span>{
    <span class="comment">// fd 03 1d aa    mov fp, fp</span>
    <span class="comment">// arm64 instructions are well-aligned</span>
    <span class="keyword">if</span> (*(<span class="keyword">uint32_t</span> *)ra == <span class="number">0xaa1d03fd</span>) {
        <span class="keyword">return</span> <span class="literal">true</span>;
    }
    <span class="keyword">return</span> <span class="literal">false</span>;
}
</code></pre><p>简单来说，要有<code>mov fp, fp</code>，而<code>fp</code>就是<code>x29</code>寄存器。那我们来看看<code>loop</code>的对应汇编：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/autorelease_r2.png?raw=true" alt="屏幕快照 2019-07-01 下午1.15.11"></p>
<p><strong>哈哈，0x62b0</strong>的地方果然是<code>mov x29, x29</code>。</p>
<p>如果你对静态分析的结果不熟悉，可以动态进入汇编。在<code>obc_autoreleaseReturnValue</code>下符号断点，得到</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/autorelease_r3.png?raw=true" alt="屏幕快照 2019-07-01 下午1.16.57"></p>
<p>如果你输出<code>x30</code>寄存器的值（注意不是把寄存器的值当地址再取值）然后再减去所在二进制的基地址，会发现<strong>偏移正正好好也是<code>0x62b0</code></strong></p>
<p>而如果你加上之前提到的<code>for</code>循环代码，再断到<code>obc_autoreleaseReturnValue</code>去查看<code>x30</code>的值，计算偏移量会得到：<code>0x0000000000005e98</code>。</p>
<p>而对应到二进制里是：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/autorelease_r4.png?raw=true" alt="屏幕快照 2019-07-01 下午1.46.10"></p>
<p>看到没，这里调用<code>objc_autoreleaseReturnValue</code>走的是<code>bl</code>，也就是会修改<code>LR</code>寄存器，而<code>LR</code>寄存器的值就是调用后的返回地址<code>5e98</code>。而<code>LR</code>寄存器本身就是<code>x30</code>，导致<code>autorelease</code>的优化失效。</p>
<p><b style="color:red">至此，我们终于发现了为什么我们的数据会被所谓的<code>@autoreleasepool content</code>持有。</b></p>
<h3 id="后记">后记</h3><p>虽然正如网上很多文章所述，子线程确实会对<code>autoreleasepool</code>进行自动的管理避免内存泄漏。但是，由于诸多场景导致的释放时机变更，会产生诸多的<b style="color:red">内存不释放（并非是内存泄漏，<code>Leaks</code>是查不出来的）</b>，也会对<code>App</code>的稳定性造成巨大的影响。</p>
<p><b style="color:red">更重要的是，基于这种TLS的优化很有可能被我们不知情下编写的代码所改变，产生奇怪的问题，因此要特别注意。</b></p>
<p>下文我会从<strong>编译以及代码生成的层面</strong>来探讨为什么会产生这种不同的汇编代码。</p>
]]></content>
    <summary type="html">
    <![CDATA[<blockquote>
<p>本文的硬核在第二段</p>
</blockquote>
<p>之前在做某项目的时候，自建了基于<code>NSThread</code>的私有线程池，在线程池分配了固定个数的常驻工作线程，在工作线程里面运行相关任务；这个方案取代了原先直接无脑使用<]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[基于智能指针和RAII的对象内存管理设计]]></title>
    <link href="http://satanwoo.github.io/2019/01/26/RAII/"/>
    <id>http://satanwoo.github.io/2019/01/26/RAII/</id>
    <published>2019-01-26T15:13:23.000Z</published>
    <updated>2019-01-26T18:43:29.000Z</updated>
    <content type="html"><![CDATA[<p>在<a href="http://satanwoo.github.io/2019/01/26/shared-ptr/">从C++ std::shared_ptr 原理来看看栈溢出的危害</a>，我提及了<code>C++</code>的智能指针指向被管理对象的<code>raw ptr</code>会被栈内存溢出而破坏，而利用智能指针进行对象构造的管理和设计，可以衍生出和<code>RAII</code>的结合，今天就来谈谈这项技术。</p>
<h3 id="什么是RAII？">什么是RAII？</h3><p><code>RAII</code>是<code>Resource Acquisition Is Initialization</code>，简而言之就是将对一个资源的申请封装在一个对象的生命周期内的理念。这样做的好处就是，C++的对象势必在创建的时候会经过构造函数，而在销毁的时候会触发析构函数。</p>
<p>听起来有点绕是不是，让我们来简化一下其主要特点。</p>
<ul>
<li>所有的资源管理内聚在对象内部</li>
<li>利用对象申请／释放的特性对资源同步进行对应的申请／释放</li>
<li>自动管理对象</li>
</ul>
<p>前两点都比较容易，那么第三点如何达到呢？</p>
<p><b style="color:red">合理的利用局部变量。</b></p>
<p>绝大多数语言，比如<code>C++</code>，都居于块级作用域。当在创建的变量离开其所在的块级时候，就会触发释放。而这就可以达到我们所说的自动管理对象。</p>
<blockquote>
<p>这其实就是压栈／出栈的高级语言表现。</p>
</blockquote>
<p>而在<code>C++</code>领域，有一个比较经典的利用<code>RAII</code>特性的设计就是<strong>ScopeLock</strong>。</p>
<pre><code><span class="title">template</span>&lt;<span class="keyword">class</span> <span class="type">LockType</span>&gt;
<span class="class">
<span class="keyword">class</span> <span class="type">My_scope_lock</span>
{

   public:

   <span class="type">My_scope_lock</span><span class="container">(<span class="type">LockType</span>&amp; <span class="title">_lock</span>)</span>:m_lock<span class="container">(<span class="title">_lock</span>)</span>

   {

         m_lock.occupy<span class="container">()</span>;

    }

   ~<span class="type">My_scope_lock</span><span class="container">()</span>

   {

        m_lock.relase<span class="container">()</span>;

   }

   protected:

   <span class="type">LockType</span>    m_lock;
}</span>
</code></pre><p>在这里，<b style="color:red">锁被看成是一种资源，他需要lock/unlock的配对操作，不然就会引发问题。</b></p>
<p>而上述代码，将锁保留在对象的构造函数和西沟函数中。这样，当我们在某个函数中需要操作临界区域的时候，就可以简洁明了的使用局部变量来操作锁：</p>
<pre><code><span class="keyword">void</span> Data::Update()
{
     <span class="function">My_scope_lock <span class="title">l_lock</span><span class="params">(m_mutex_lock)</span></span>;
    <span class="comment">// do some operation</span>
}
</code></pre><h3 id="基于智能指针的RAII">基于智能指针的RAII</h3><p>上文我们用锁的例子来举例说明了<code>RAII</code>的设计理念，那什么又是基于智能指针的<code>RAII</code>呢？</p>
<p>我们都知道，在编程过程中，我们必须和内存打交道，而内存分为了两种类型：栈上内存和堆上内存。栈上内存不仅和线程相关，同时空间大小也相对堆内存来说非常小。因此，当我们在处理一些大规模数据（以及对象规模不确定）的时候，比如使用几百个对象的数据等等，一般都采用堆上动态分配内存。</p>
<p>但是堆上内存，在诸多的语言中，都需要手动管理，比如<code>C++</code>。而一般处理不当，比如（new []和delete搭配），或者遗忘了释放，那么就会产生内存泄漏等严重问题。</p>
<p>为此，我们参考上节的设计，准备构建一个可以在对象的构造／析构函数中成对正确释放内存的设计思路。</p>
<p>先假设一个需要在堆上频发操作的对象<code>Data</code></p>
<pre><code><span class="class"><span class="keyword">class</span> <span class="title">Data</span> </span>{
    <span class="comment">// 省略</span>
}
</code></pre><p>如果直接使用，一般情况下是这样的代码:</p>
<pre><code><span class="type">Data</span> *<span class="typedef"><span class="keyword">data</span> = new <span class="type">Data</span><span class="container">()</span>;</span>
<span class="title">delete</span> <span class="typedef"><span class="keyword">data</span>;</span>
</code></pre><p>需要频繁的确认对堆内存的正确使用。现在我们给他加一个包装对象，<code>DataHandle</code></p>
<pre><code><span class="class"><span class="keyword">class</span> <span class="title">DataHandle</span> </span>{
    <span class="keyword">private</span>:
        Data *m_data;
}

DataHandle::DataHandle():m_data(<span class="keyword">new</span> Data())
{}

DataHandle::~DataHandle()
{
    delete m_data;
    m_data = NULL;
}
</code></pre><p>这样，我们后续每次使用，就可以简化成  </p>
<pre><code><span class="collection">{
    DataHandle handle;
}</span>
</code></pre><p>但是，别忘记了，<code>C++</code>中海油拷贝构造和重载赋值等操作，一旦我们写出如下代码，就会引发<code>double free</code>的问题。</p>
<pre><code><span class="collection">{
    DataHandle handle1<span class="list">(<span class="keyword">handle</span>)</span><span class="comment">;</span>
    handle1 = handle;
}</span>
</code></pre><p>因此，我们需要对拷贝构造函数和重载赋值进行特别处理。这里有两种处理方式：</p>
<ul>
<li>对于拷贝／赋值，每次把内部指针<code>m_data</code>也拷贝<code>new</code>一次。</li>
<li>对于<code>m_data</code>进行合理的计数记录。</li>
</ul>
<p><strong>一般情况下，我们期望<code>DataHandle</code>的行为和<code>Data</code>是一致的。</strong> 因此我们想使用第二种方式。</p>
<p>这个时候，<code>C++</code>的<code>shared_ptr</code>就派上用场了。改写下<code>DataHanle</code></p>
<pre><code><span class="keyword">class</span> DataHandle{
    <span class="keyword">public</span>:
        DataHandle();
        DataHandle(<span class="keyword">const</span> DataHandle &amp;handle);
        DataHandle&amp; <span class="keyword">operator</span>=(<span class="keyword">const</span> DataHanlde &amp;handle);
    <span class="keyword">private</span>:
        <span class="built_in">std</span>::<span class="built_in">shared_ptr</span>&lt;Data&gt; m_dataS;
}
</code></pre><p>对于重载后的拷贝／复制函数，我们只要利用智能指针自身重载过的赋值操作赋，即可解决引用计数问题。</p>
<p><strong>最后要特别注意的是，下述两种情况的代码，是完全不相同的含义。</strong></p>
<pre><code><span class="comment">// 第一种情况</span>
Data *data = <span class="keyword">new</span> Data();

<span class="built_in">std</span>::<span class="built_in">shared_ptr</span>&lt;Data&gt; s1 = <span class="built_in">std</span>::<span class="built_in">shared_ptr</span>(data);

<span class="built_in">std</span>::<span class="built_in">shared_ptr</span>&lt;Data&gt; s2 = s1;

<span class="comment">// 第二种情况</span>

Data *data = <span class="keyword">new</span> Data();

<span class="built_in">std</span>::<span class="built_in">shared_ptr</span>&lt;Data&gt; s1 = <span class="built_in">std</span>::<span class="built_in">shared_ptr</span>(data);

<span class="built_in">std</span>::<span class="built_in">shared_ptr</span>&lt;Data&gt; s2 = <span class="built_in">std</span>::<span class="built_in">shared_ptr</span>(data);
</code></pre>]]></content>
    <summary type="html">
    <![CDATA[<p>在<a href="http://satanwoo.github.io/2019/01/26/shared-ptr/">从C++ std::shared_ptr 原理来看看栈溢出的危害</a>，我提及了<code>C++</code>的智能指针指向被管理对象的<code>r]]>
    </summary>
    
      <category term="C++" scheme="http://satanwoo.github.io/tags/C/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[LD-2]]></title>
    <link href="http://satanwoo.github.io/2019/01/26/LD-2/"/>
    <id>http://satanwoo.github.io/2019/01/26/LD-2/</id>
    <published>2019-01-26T08:51:30.000Z</published>
    <updated>2019-01-26T08:52:11.000Z</updated>
    <content type="html"><![CDATA[<h2 id="了解苹果的LD">了解苹果的LD</h2><blockquote>
<p>其实文章关于传统<code>Section Based Linker</code>那块我还没怎么读懂，有兴趣的欢迎互相探讨。</p>
</blockquote>
<p>之前研究<code>Xcode 10</code>兼容<code>libstdc++</code>的时候，稍微把玩了下苹果的<code>LD</code>，借这个机会正好通读了下苹果的<code>LD</code>设计，本文做一下总结。</p>
<h3 id="Atom_&amp;_FixUp">Atom &amp; FixUp</h3><p>苹果的<code>LD</code>，核心理念就是基于<code>Atom</code>和<code>FixUp</code>，拿着两个术语是啥意思呢？</p>
<ul>
<li><code>Atom</code>就是一块代码（函数）或者数据（全局变量）之类的，每个<code>Atom</code>都有一些属性，比如名称、作用域、内容类型、字节对齐之类的。</li>
<li><code>Fixup</code>可以理解为一个包含种类、便宜、辅助加数以及目标<code>Atom</code>的数据结构。</li>
</ul>
<p>有点抽象对吧？概要来说，苹果<code>LD</code>通过<code>Atom</code>和<code>FixUP</code>构建一张图，图中的节点都是<code>Atom</code>，连接<code>Atom</code>的则是<code>FixUP</code>。</p>
<p><strong>通过构建这样一张图，苹果就可以在链接期间进行一系列的优化，比如死代码剔除，怎么做呢？比如一段代码也会被抽象成<code>Atom</code>，如果没有<code>FixUP</code>连接的<code>Atom</code>就可以进行剔除</strong></p>
<p>举一个简单的小例子<code>main.c</code>：</p>
<pre><code><span class="preprocessor">#<span class="keyword">include</span> <span class="string">&lt;stdio.h&gt;</span></span>

<span class="function"><span class="keyword">int</span> <span class="title">main</span><span class="params">()</span>
</span>{
    <span class="built_in">printf</span>(<span class="string">"hello world"</span>);
    <span class="keyword">return</span> <span class="number">0</span>;
}
</code></pre><p>会被抽象出如下行为：</p>
<p><img src="https://opensource.apple.com/source/ld64/ld64-253.3/doc/design/hello.png" alt=""></p>
<p>单独编译这个<code>.c</code>文件生成的<code>.o</code>会包含两个<code>atom</code>，一个是<code>main</code>函数，另外一个是<code>C</code>字符串<code>&quot;hello world&quot;</code></p>
<blockquote>
<p>printf 本质上也会一个<code>atom</code>，但是在这个编译单元内他还没加入图中。</p>
</blockquote>
<p>而<code>fixup</code>也存在两个，一个是去调用不知道在哪的函数<code>printf</code>的调用<code>fixup</code>，一个是去加载字符串的<code>fixup</code>。</p>
<h3 id="链接过程">链接过程</h3><ul>
<li><p>链接过程的第一步就是要处理输入文件，构建一张初始图。</p>
<ul>
<li>如果输入文件是<code>.o</code>，那么所有的<code>atom</code>都会被加入到初始图当中。</li>
<li>如果输入文件是静态库(静态库基本上就是一组<code>.o</code>文件包含一个目录)，初始状态下这里面的<code>atom</code>都默认<b style="color:red">不会加入到里面</b>，当<code>LD</code>不断初始图中有没被决议的<code>fixup</code>，如果fixup对应的目标<code>atom</code>在这个静态库里面的话，就会把找到的<code>atom</code>的加入到图内。</li>
<li>动态库其实在链接期间不会添加任何的<code>atom</code>，同静态库一样，如果有没被决议的<code>fixup</code>对应的<code>atom</code>在动态库内找到（比如<code>tbd</code>声明的那些），就就提供一个代理，<b style="color:red">这个代理标记了这个符号来自哪个动态库</b></li>
</ul>
</li>
</ul>
<blockquote>
<p>本质上来说，链接期间动态库的作用就是参与标记一下。</p>
</blockquote>
<ul>
<li><p>考虑完符号决议，还要考虑符号合并之类的，比如根据字符串表的设计，来自不同文件的相同字符串，比如<code>&quot;haha&quot;</code>，不可能保留两份，需要合并。此外还有诸如<code>C</code>中的<code>tentative definitions</code>，<code>C++ Weak Symbol</code>等</p>
</li>
<li><p>处理<code>fixup</code>的时候，也需要分几种类型，见下图：</p>
</li>
</ul>
<p><img src="https://opensource.apple.com/source/ld64/ld64-253.3/doc/design/bindings.png" alt=""></p>
<h3 id="其他">其他</h3><p>虽然苹果的<code>LD</code>已经抽象成了<code>Atom-FixUP</code>的架构，但是它的可执行文件<code>Mach-O</code>还是传统的基于<code>section</code>的结构，这限制了<code>Atom-FixUP</code>的能力。</p>
]]></content>
    <summary type="html">
    <![CDATA[<h2 id="了解苹果的LD">了解苹果的LD</h2><blockquote>
<p>其实文章关于传统<code>Section Based Linker</code>那块我还没怎么读懂，有兴趣的欢迎互相探讨。</p>
</blockquote>
<p>之前研究<code>X]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[从C++ std::shared_ptr 原理来看看栈溢出的危害]]></title>
    <link href="http://satanwoo.github.io/2019/01/26/shared-ptr/"/>
    <id>http://satanwoo.github.io/2019/01/26/shared-ptr/</id>
    <published>2019-01-26T08:48:20.000Z</published>
    <updated>2019-01-26T15:22:43.000Z</updated>
    <content type="html"><![CDATA[<h2 id="C++_std::shared_ptr_实现原理">C++ std::shared_ptr 实现原理</h2><p>上周五排查了一个由于<code>XXX模块</code>操作疏忽导致栈越界引发的<code>我的模块</code>的智能指针Crash问题，因此稍微研究了一下，以作参考：</p>
<blockquote>
<p>shared_ptr共享被管理对象，同一时刻可以有多个shared_ptr拥有对象的所有权，当最后一个shared_ptr对象销毁时，被管理对象自动销毁</p>
</blockquote>
<h3 id="shared_ptr_实现">shared_ptr 实现</h3><p><img src="https://github.com/SatanWoo/BeeHive/blob/master/share_ptr.png?raw=true" alt=""></p>
<p>简单来说，<code>shared_ptr</code>实现包含了两部分，</p>
<ul>
<li>一个指向堆上创建的对象的裸指针，<code>raw_ptr</code></li>
<li><strong>一个指向内部隐藏的、共享的管理对象。<code>share_count_object</code></strong></li>
</ul>
<p>第一部分没什么好说的，第二部分是需要关注的重点：</p>
<ul>
<li><code>use_count</code>，当前这个堆上对象被多少对象引用了，简单来说就是引用计数。</li>
<li><code>weak_count</code>，这个管理对象被多少个智能指针共享了，简单来说就是<code>管理对象</code>的引用计数。</li>
</ul>
<p><b style="color:red">不同指针创建的对同一个堆上对象的智能管理，并不共享管理对象，因此存在<code>double free</code>的可能性</b></p>
<p><code>_shared_ptr</code>直接包含的裸指针，即<code>raw prt</code>，是为了实现一般指针的-&gt;,*等操作，通过<code>__shared_count object</code>间接包含的指针是为了管理对象的生命周期，回收相关资源。</p>
<p>换句话说，<code>__shared_count object</code>内部的<code>use_count</code>主要用来标记<strong>被管理对象</strong>的生命周期，<code>weak_count</code>主要用来标记<strong>管理对象</strong>的生命周期。</p>
<blockquote>
<p>注意区分管理和被管理。</p>
</blockquote>
<h3 id="问题原因">问题原因</h3><p>了解了原理，可以看出<code>std::share_ptr</code>本身的<code>raw ptr</code>指向了堆上通过<code>new</code>创建的对象。但是其自身这个<code>raw ptr</code>却会如果在不当操作上，被修改，比如栈越界操作，就会被破坏，导致产生对非法对象的访问：</p>
<pre><code><span class="keyword">int</span> i = <span class="number">5</span>;
NSLog(@<span class="string">"i address is %p"</span>, &amp;i);

XXX::XX df = XXX::XX::buildDataFrame();
NSLog(@<span class="string">"sp0 address is %p"</span>, &amp;df);

<span class="keyword">int</span> a[<span class="number">1</span>] = {<span class="number">1</span>};

NSLog(@<span class="string">"k address is %p"</span>, a);

<span class="keyword">for</span> (<span class="keyword">int</span> i = <span class="number">0</span>; i &lt; <span class="number">10</span>; i++) {
    a[i] = i;
}

NSLog(@<span class="string">"haha"</span>);
</code></pre><p>上述这段代码就会引发问题，这里<code>XXX::XX</code>的具体内部设计使用了经典的<code>RAII</code>，下文再表。</p>
]]></content>
    <summary type="html">
    <![CDATA[<h2 id="C++_std::shared_ptr_实现原理">C++ std::shared_ptr 实现原理</h2><p>上周五排查了一个由于<code>XXX模块</code>操作疏忽导致栈越界引发的<code>我的模块</code>的智能指针Crash问题，因此稍微]]>
    </summary>
    
      <category term="c++" scheme="http://satanwoo.github.io/tags/c/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[抛开性能，谈谈不该用@Synchronized的原因]]></title>
    <link href="http://satanwoo.github.io/2019/01/01/Synchronized/"/>
    <id>http://satanwoo.github.io/2019/01/01/Synchronized/</id>
    <published>2019-01-01T15:50:00.000Z</published>
    <updated>2019-01-01T15:55:53.000Z</updated>
    <content type="html"><![CDATA[<p>关于<code>Objective-C</code>中的<code>@Synchronized</code>，想必从事<code>iOS</code>开发相关工作的同学都不陌生，可以说这是一种最简单的加锁的方式了。</p>
<p>网上关于锁对比的文章也不在少数，太多说集中在用法概述以及性能对比。而<code>@Synchronized</code>在不少文章中常常因其<b>性能</b>而被建议不要使用。</p>
<p>本质上来说，在客户端场景下，高密度使用锁的场景是相对较少（比如<code>IM</code>数据库除外）；同时，抛开使用场景单独通过比如<code>for</code>循环测试锁的性能，也是比较蛋疼的，不合适的用法、过大的锁范围以及竞态条件，都会导致比较条件的欠考虑性。</p>
<p><b style="color:red">因此，今天我想谈谈一个不应该使用<code>@Synchronized</code>的本质原因：它是一个和上下文强相关的锁，会导致锁失效。</b></p>
<h3 id="一个简单的事例">一个简单的事例</h3><p>考虑一个场景：</p>
<p>我们后台静默更新一下数据，一旦有了新数据，就整体替换掉现在呈现的数据，这在列表页配合远程数据的时候非常常见。</p>
<p>为了放大多线程<b>可能出错的场景</b>，我放大到<b>5000</b>个线程，构造如下代码：</p>
<pre><code><span class="class"><span class="keyword">@interface</span> <span class="title">ViewController</span> ()</span>
<span class="keyword">@property</span> (<span class="keyword">nonatomic</span>, <span class="keyword">strong</span>) <span class="built_in">NSMutableArray</span> *testArray;
<span class="keyword">@end</span>

<span class="class"><span class="keyword">@implementation</span> <span class="title">ViewController</span></span>

- (<span class="keyword">void</span>)viewDidLoad
{
    [<span class="keyword">super</span> viewDidLoad];

    <span class="keyword">self</span><span class="variable">.testArray</span> = @[]<span class="variable">.mutableCopy</span>;

    <span class="keyword">for</span> (<span class="built_in">NSUInteger</span> i = <span class="number">0</span>; i &lt; <span class="number">5000</span>; i++) {
        <span class="built_in">dispatch_async</span>(dispatch_get_global_queue(DISPATCH_QUEUE_PRIORITY_DEFAULT, <span class="number">0</span>), ^{
            [<span class="keyword">self</span> testThreadArray];
        });
    }
}

- (<span class="keyword">void</span>)testThreadArray
{
    <span class="keyword">@synchronized</span> (<span class="keyword">self</span><span class="variable">.testArray</span>) {
        <span class="keyword">self</span><span class="variable">.testArray</span> = @[]<span class="variable">.mutableCopy</span>;
    }
}
</code></pre><p>可以看出，为了避免多个线程同时更新临界资源<code>testArray</code>，我们使用 <code>@synchronized (self.testArray)</code> 进行了资源保护。</p>
<blockquote>
<p>备注：为什么需要保护这里的赋值操作，可以阅读我的<a href="http://satanwoo.github.io/2016/07/10/immutable-thread/">从Immutable来谈谈对于线程安全的理解误区
</a></p>
</blockquote>
<p>看起来一切都很Ok，但是当你实际运行代码，还是会出现野指针Crash。如下图所示：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/synchronized-1.png?raw=true" alt="屏幕快照 2018-12-27 下午2.02.28.png"></p>
<blockquote>
<p>这里用<code>@Synchronized(self)</code>是可以成功锁住的，但是这会陷入到锁的范围太大的场景中去，不再此文探讨的范围内。</p>
</blockquote>
<h3 id="Crash的根因">Crash的根因</h3><p><code>@Synchronized</code>会变成一对基于<code>try-catch</code>的<code>objc_sync_enter</code>和<code>objc_sync_exit</code>的代码，想必都不陌生了，许多网上文章都有，不再赘述，可以参考<code>clang</code>的代码：</p>
<blockquote>
<p><a href="https://clang.llvm.org/doxygen/RewriteObjC_8cpp_source.html" target="_blank" rel="external">https://clang.llvm.org/doxygen/RewriteObjC_8cpp_source.html</a></p>
</blockquote>
<pre><code><span class="comment">/// RewriteObjCSynchronizedStmt -</span>
 <span class="comment">/// This routine rewrites @synchronized(expr) stmt;</span>
 <span class="comment">/// into:</span>
 <span class="comment">/// objc_sync_enter(expr);</span>
 <span class="comment">/// @try stmt @finally { objc_sync_exit(expr); }</span>
 <span class="comment">///</span>
 Stmt *RewriteObjC::RewriteObjCSynchronizedStmt(ObjCAtSynchronizedStmt *S) {
   <span class="comment">// Get the start location and compute the semi location.</span>
   SourceLocation startLoc = S-&gt;getBeginLoc();
   <span class="keyword">const</span> <span class="keyword">char</span> *startBuf = SM-&gt;getCharacterData(startLoc);

   assert((*startBuf == <span class="string">'@'</span>) &amp;&amp; <span class="string">"bogus @synchronized location"</span>);

   std::string buf;
   buf = <span class="string">"objc_sync_enter((id)"</span>;
   <span class="keyword">const</span> <span class="keyword">char</span> *lparenBuf = startBuf;
   <span class="keyword">while</span> (*lparenBuf != <span class="string">'('</span>) lparenBuf++;
   ReplaceText(startLoc, lparenBuf-startBuf+<span class="number">1</span>, buf);
   <span class="comment">// We can't use S-&gt;getSynchExpr()-&gt;getEndLoc() to find the end location, since</span>
   <span class="comment">// the sync expression is typically a message expression that's already</span>
   <span class="comment">// been rewritten! (which implies the SourceLocation's are invalid).</span>
   SourceLocation endLoc = S-&gt;getSynchBody()-&gt;getBeginLoc();
   <span class="keyword">const</span> <span class="keyword">char</span> *endBuf = SM-&gt;getCharacterData(endLoc);
   <span class="keyword">while</span> (*endBuf != <span class="string">')'</span>) endBuf--;
   SourceLocation rparenLoc = startLoc.getLocWithOffset(endBuf-startBuf);
   buf = <span class="string">");\n"</span>;
   <span class="comment">// declare a new scope with two variables, _stack and _rethrow.</span>
   buf += <span class="string">"/* @try scope begin */ \n{ struct _objc_exception_data {\n"</span>;
   buf += <span class="string">"int buf[18/*32-bit i386*/];\n"</span>;
   buf += <span class="string">"char *pointers[4];} _stack;\n"</span>;
   buf += <span class="string">"id volatile _rethrow = 0;\n"</span>;
   buf += <span class="string">"objc_exception_try_enter(&amp;_stack);\n"</span>;
   buf += <span class="string">"if (!_setjmp(_stack.buf)) /* @try block continue */\n"</span>;
   ReplaceText(rparenLoc, <span class="number">1</span>, buf);
   startLoc = S-&gt;getSynchBody()-&gt;getEndLoc();
   startBuf = SM-&gt;getCharacterData(startLoc);

   assert((*startBuf == <span class="string">'}'</span>) &amp;&amp; <span class="string">"bogus @synchronized block"</span>);
   SourceLocation lastCurlyLoc = startLoc;
   buf = <span class="string">"}\nelse {\n"</span>;
   buf += <span class="string">"  _rethrow = objc_exception_extract(&amp;_stack);\n"</span>;
   buf += <span class="string">"}\n"</span>;
   buf += <span class="string">"{ /* implicit finally clause */\n"</span>;
   buf += <span class="string">"  if (!_rethrow) objc_exception_try_exit(&amp;_stack);\n"</span>;

   std::string syncBuf;
   syncBuf += <span class="string">" objc_sync_exit("</span>;

   Expr *syncExpr = S-&gt;getSynchExpr();
   CastKind CK = syncExpr-&gt;getType()-&gt;isObjCObjectPointerType()
                   ? CK_BitCast :
                 syncExpr-&gt;getType()-&gt;isBlockPointerType()
                   ? CK_BlockPointerToObjCPointerCast
                   : CK_CPointerToObjCPointerCast;
   syncExpr = NoTypeInfoCStyleCastExpr(Context, Context-&gt;getObjCIdType(),
                                       CK, syncExpr);
   std::string syncExprBufS;
   llvm::raw_string_ostream syncExprBuf(syncExprBufS);
   assert(syncExpr != nullptr &amp;&amp; <span class="string">"Expected non-null Expr"</span>);
   syncExpr-&gt;printPretty(syncExprBuf, nullptr, PrintingPolicy(LangOpts));
   syncBuf += syncExprBuf.<span class="keyword">str</span>();
   syncBuf += <span class="string">");"</span>;

   buf += syncBuf;
   buf += <span class="string">"\n  if (_rethrow) objc_exception_throw(_rethrow);\n"</span>;
   buf += <span class="string">"}\n"</span>;
   buf += <span class="string">"}"</span>;

   ReplaceText(lastCurlyLoc, <span class="number">1</span>, buf);

   <span class="keyword">bool</span> hasReturns = <span class="keyword">false</span>;
   HasReturnStmts(S-&gt;getSynchBody(), hasReturns);
   <span class="keyword">if</span> (hasReturns)
     RewriteSyncReturnStmts(S-&gt;getSynchBody(), syncBuf);

   <span class="keyword">return</span> nullptr;
 }
</code></pre><blockquote>
<p>卧槽，原来<code>clang</code>的rewrite部分也写的这么挫逼啊。</p>
</blockquote>
<p>我们就从<code>objc_sync_enter</code>来继续挖掘：</p>
<pre><code><span class="title">if</span> (obj) {
    <span class="type">SyncData</span>* <span class="typedef"><span class="keyword">data</span> = id2data<span class="container">(<span class="title">obj</span>, <span class="type">ACQUIRE</span>)</span>;</span>
    assert(<span class="typedef"><span class="keyword">data</span>);</span>
    <span class="typedef"><span class="keyword">data</span>-&gt;mutex.lock<span class="container">()</span>;</span>
}
</code></pre><p>关键其实就是在于从<code>obj</code>转换到<code>SyncData</code>，然后通过<code>SyncData</code>中的<code>mutex</code>来进行临界区的锁。</p>
<p>有两个部分需要分析一下，首先<code>SyncData</code>结构体定义如下：</p>
<pre><code><span class="function"><span class="keyword">typedef</span> <span class="keyword">struct</span> <span class="title">alignas</span><span class="params">(CacheLineSize)</span> SyncData </span>{
    <span class="keyword">struct</span> SyncData* nextData;
    DisguisedPtr&lt;objc_object&gt; object;
    <span class="keyword">int32_t</span> threadCount;  <span class="comment">// number of THREADS using this block</span>
    <span class="keyword">recursive_mutex_t</span> mutex;
} SyncData;
</code></pre><ul>
<li><code>mutex</code>，一把递归锁，这也是为什么我们可以在<code>@Synchronized</code>里面嵌套<code>@Synchronized</code>的原因。</li>
<li><code>DisguisedPtr</code>，还记得我们以前<b>写安全气垫的时候给一些释放的内存地址填充<code>0x55</code>用于拦截<code>use after free</code>的场景</b>？这里<code>DisguisedPtr</code>其实就是对裸对象指针<code>objc_object</code>的一层包装改写。</li>
</ul>
<p>继续回到<code>id2data</code>函数往下研究，可以发现一段比较有意思的函数：</p>
<pre><code><span class="keyword">static</span> StripedMap&lt;SyncList&gt; sDataLists;
</code></pre><p>我们具体就关注<code>[]</code>对应的操作即可：</p>
<pre><code><span class="keyword">class</span> StripedMap {
<span class="preprocessor">#<span class="keyword">if</span> TARGET_OS_IPHONE &amp;&amp; !TARGET_OS_SIMULATOR</span>
    <span class="keyword">enum</span> { StripeCount = <span class="number">8</span> };
<span class="preprocessor">#<span class="keyword">else</span></span>
    <span class="keyword">enum</span> { StripeCount = <span class="number">64</span> };
<span class="preprocessor">#<span class="keyword">endif</span></span>

    <span class="keyword">struct</span> PaddedT {
        <span class="function">T value <span class="title">alignas</span><span class="params">(CacheLineSize)</span></span>;
    };

    PaddedT <span class="built_in">array</span>[StripeCount];

    <span class="function"><span class="keyword">static</span> <span class="keyword">unsigned</span> <span class="keyword">int</span> <span class="title">indexForPointer</span><span class="params">(<span class="keyword">const</span> <span class="keyword">void</span> *p)</span> </span>{
        <span class="keyword">uintptr_t</span> addr = <span class="keyword">reinterpret_cast</span>&lt;<span class="keyword">uintptr_t</span>&gt;(p);
        <span class="keyword">return</span> ((addr &gt;&gt; <span class="number">4</span>) ^ (addr &gt;&gt; <span class="number">9</span>)) % StripeCount;
    }

 <span class="keyword">public</span>:
    T&amp; <span class="keyword">operator</span>[] (<span class="keyword">const</span> <span class="keyword">void</span> *p) { 
        <span class="keyword">return</span> <span class="built_in">array</span>[indexForPointer(p)].value; 
    }
    <span class="keyword">const</span> T&amp; <span class="keyword">operator</span>[] (<span class="keyword">const</span> <span class="keyword">void</span> *p) <span class="keyword">const</span> { 
        <span class="keyword">return</span> <span class="keyword">const_cast</span>&lt;StripedMap&lt;T&gt;&gt;(<span class="keyword">this</span>)[p]; 
    }
</code></pre><p>抽丝剥茧，这里其实就是一个简单的<code>Hash</code>算法，然后将传入的对象地址，通过<code>indexForPointer</code>映射到不同的<code>SyncList</code>上。而<code>SyncList</code>是一个维护<code>SyncData</code>的链表，每个<code>SyncList</code>都单独维护操作自己的<code>lock</code>。</p>
<blockquote>
<p><code>indexForPointer</code>公式：<code>((addr &gt;&gt; 4) ^ (addr &gt;&gt; 9)) % StripeCount</code>，其中<code>StripeCount</code>是个数。</p>
</blockquote>
<p>这样做的好处就是创建了一个所谓的散列锁，可以有效的降低不同的对象操作指尖的相互影响性。当然，从本质上看，<code>iOS</code>上就<b style="color:red">8个散列锁，这也是影响大规模使用@Synchronized会影响性能的原因之一。</b></p>
<p>接着往下走，我们直接<b>关注没有命中<code>Thread Local Storage</code>的场景</b>。</p>
<pre><code><span class="comment">#define LOCK_FOR_OBJ(obj) sDataLists[obj].lock</span>
spinlock_t *lockp = &amp;<span class="type">LOCK_FOR_OBJ</span>(<span class="keyword">object</span>);

// 通过对对象地址hash，算法对应<span class="type">SyncList</span>的锁

lockp-&gt;lock();

{
    <span class="type">SyncData</span>* p;
    <span class="type">SyncData</span>* firstUnused = <span class="type">NULL</span>;
    <span class="keyword">for</span> (p = *listp; p != <span class="type">NULL</span>; p = p-&gt;nextData) {
        <span class="keyword">if</span> ( p-&gt;<span class="keyword">object</span> == <span class="keyword">object</span> ) {
            <span class="literal">result</span> = p;
            // atomic because may collide <span class="keyword">with</span> concurrent <span class="type">RELEASE</span>
            <span class="type">OSAtomicIncrement32Barrier</span>(&amp;<span class="literal">result</span>-&gt;threadCount);
            goto done;
        }
        <span class="keyword">if</span> ( (firstUnused == <span class="type">NULL</span>) &amp;&amp; (p-&gt;threadCount == <span class="number">0</span>) )
            firstUnused = p;
    }

    // no <span class="type">SyncData</span> currently associated <span class="keyword">with</span> <span class="keyword">object</span>
    <span class="keyword">if</span> ( (why == <span class="type">RELEASE</span>) || (why == <span class="type">CHECK</span>) )
        goto done;

    // an unused one was found, use it
    // 关注点<span class="number">1</span> ！！！！！！！！！！！！
    <span class="keyword">if</span> ( firstUnused != <span class="type">NULL</span> ) {
        <span class="literal">result</span> = firstUnused;
        <span class="literal">result</span>-&gt;<span class="keyword">object</span> = (objc_object *)<span class="keyword">object</span>;
        <span class="literal">result</span>-&gt;threadCount = <span class="number">1</span>;
        goto done;
    }
}

// <span class="type">Allocate</span> a new <span class="type">SyncData</span> <span class="keyword">and</span> add to list.
// <span class="type">XXX</span> allocating memory <span class="keyword">with</span> a global lock held <span class="keyword">is</span> bad practice,
// might be worth releasing the lock, allocating, <span class="keyword">and</span> searching again.
// <span class="type">But</span> since we never free these guys we won't be stuck <span class="keyword">in</span> allocation very often.

// 关注点<span class="number">2</span> ！！！！！！！！！！！！
posix_memalign((<span class="type">void</span> **)&amp;<span class="literal">result</span>, alignof(<span class="type">SyncData</span>), sizeof(<span class="type">SyncData</span>));
<span class="literal">result</span>-&gt;<span class="keyword">object</span> = (objc_object *)<span class="keyword">object</span>;
<span class="literal">result</span>-&gt;threadCount = <span class="number">1</span>;
new (&amp;<span class="literal">result</span>-&gt;mutex) recursive_mutex_t(fork_unsafe_lock);
<span class="literal">result</span>-&gt;nextData = *listp;
*listp = <span class="literal">result</span>;

 done:
lockp-&gt;unlock();
<span class="keyword">if</span> (<span class="literal">result</span>) {
    // <span class="type">Only</span> new <span class="type">ACQUIRE</span> should get here.
    // <span class="type">All</span> <span class="type">RELEASE</span> <span class="keyword">and</span> <span class="type">CHECK</span> <span class="keyword">and</span> recursive <span class="type">ACQUIRE</span> are 
    // handled by the per-thread caches above.
    <span class="keyword">if</span> (why == <span class="type">RELEASE</span>) {
        // <span class="type">Probably</span> some thread <span class="keyword">is</span> incorrectly exiting 
        // <span class="keyword">while</span> the <span class="keyword">object</span> <span class="keyword">is</span> held by another thread.
        <span class="keyword">return</span> <span class="keyword">nil</span>;
    }
    <span class="keyword">if</span> (why != <span class="type">ACQUIRE</span>) _objc_fatal(<span class="string">"id2data is buggy"</span>);
    <span class="keyword">if</span> (<span class="literal">result</span>-&gt;<span class="keyword">object</span> != <span class="keyword">object</span>) _objc_fatal(<span class="string">"id2data is buggy"</span>);

      // 关注点<span class="number">3</span>
<span class="comment">#if SUPPORT_DIRECT_THREAD_KEYS</span>
    <span class="keyword">if</span> (!fastCacheOccupied) {
        // <span class="type">Save</span> <span class="keyword">in</span> fast thread cache
        tls_set_direct(<span class="type">SYNC_DATA_DIRECT_KEY</span>, <span class="literal">result</span>);
        tls_set_direct(<span class="type">SYNC_COUNT_DIRECT_KEY</span>, (<span class="type">void</span>*)<span class="number">1</span>);
    } <span class="keyword">else</span> 
<span class="comment">#endif</span>
    {
        // <span class="type">Save</span> <span class="keyword">in</span> thread cache
        <span class="keyword">if</span> (!cache) cache = fetch_cache(<span class="type">YES</span>);
        cache-&gt;list[cache-&gt;used].data = <span class="literal">result</span>;
        cache-&gt;list[cache-&gt;used].lockCount = <span class="number">1</span>;
        cache-&gt;used++;
    }
}

<span class="keyword">return</span> <span class="literal">result</span>;
</code></pre><ul>
<li><ol>
<li>通过散列，计算这个对象应该落入的<code>SyncList</code>，由于需要操作<code>SyncList</code>，用其对应的锁进行加锁。</li>
</ol>
</li>
<li><ol>
<li>关注点1和2，其实本质干的是一件事，就是找出一个可以被使用的<code>SyncData</code>，如果没有就创建一个，设定好对应的成员变量，然后返回。</li>
</ol>
</li>
<li><ol>
<li>关注点3，就是做完了以后，利用一下<code>Thread Local Storage</code>，存一下，这块不关注无伤大雅。</li>
</ol>
</li>
</ul>
<p>Ok，到现在我们分析完成<code>@Synchronized</code>的实现原理后，我们可以回过头再来看看为什么对象被更改后会产生Crash了。</p>
<p><b style="color:red">其实一言以蔽之，就是<code>@Synchronized</code>锁不住对象赋值变化的场景。</b></p>
<p>回到我们上一小节<code>Crash</code>的问题：</p>
<p>考虑三个线程的场景，分别定义为线程A，线程B，线程C，初始的时候在线程A，<code>self.testArray</code>的初始值为<code>arr0</code>（实质上操作的是<code>arr0</code>地址，下文简述为<code>arr0</code>），我们来理下时间线：</p>
<ul>
<li>线程A获取<code>self.testArray</code>的值，为<code>arr0</code>。</li>
<li>线程B获取<code>self.testArray</code>的值，也为<code>arr0</code>。</li>
<li>线程A，B由于对象地址一致，产生竞争，A获取到了对应的锁，我们称之为<code>lock0</code>。</li>
<li>线程A在锁的保护下，执行<code>self.testArray = @[].mutableCopy</code>。<code>self.testArray</code>指向了<code>arr1</code>。</li>
<li>线程A<b>unlock</b>。</li>
<li>此时线程C开始尝试获取<code>self.testArray</code>，获取到了<code>arr1</code>。</li>
<li>这个时候线程B由于线程A释放锁了，线程B继续，线程B使用之前获取的<code>arr0</code>进行获取锁的操作。</li>
<li>这个时候线程C也尝试进行锁操作，由于线程C是<code>arr1</code>，所以使用的是<code>arr1</code>对应的锁操作。</li>
<li><b style="color:red">由于<code>arr0</code>和<code>arr1</code>对应的锁不是一个（当然理论上可能散列计算为同一个），所以这两个线程都进入了临界区</b></li>
<li>线程B和线程C都执行<code>self.testArray = @[].mutableCopy</code>。</li>
<li><p><code>Setter</code>的赋值并不是<code>atomic</code>的，实质上会转换成如下这样的代码：</p>
<pre><code><span class="keyword">static</span> <span class="keyword">inline</span> <span class="keyword">void</span> reallySetProperty(<span class="keyword">id</span> <span class="keyword">self</span>, SEL _cmd, <span class="keyword">id</span> newValue, 
  ptrdiff_t offset, <span class="keyword">bool</span> atomic, <span class="keyword">bool</span> <span class="keyword">copy</span>, <span class="keyword">bool</span> mutableCopy) 
{
    <span class="keyword">id</span> oldValue;
    <span class="comment">// 计算结构体中的偏移量</span>
    <span class="keyword">id</span> *slot = (<span class="keyword">id</span>*) ((<span class="keyword">char</span>*)<span class="keyword">self</span> + offset);

    <span class="keyword">if</span> (<span class="keyword">copy</span>) {
        newValue = [newValue copyWithZone:<span class="literal">NULL</span>];
    } <span class="keyword">else</span> <span class="keyword">if</span> (mutableCopy) {
        newValue = [newValue mutableCopyWithZone:<span class="literal">NULL</span>];
    } <span class="keyword">else</span> {
        <span class="comment">// 某些程度的优化</span>
        <span class="keyword">if</span> (*slot == newValue) <span class="keyword">return</span>;
        newValue = objc_retain(newValue);
    }

    <span class="comment">// 危险区</span>
    <span class="keyword">if</span> (!atomic) {
         <span class="comment">// 第一步</span>
        oldValue = *slot;

        <span class="comment">// 第二步</span>
        *slot = newValue;
    } <span class="keyword">else</span> {
        spin_lock_t *slotlock = &amp;PropertyLocks[GOODHASH(slot)];
        _spin_lock(slotlock);
        oldValue = *slot;
        *slot = newValue;        
        _spin_unlock(slotlock);
    }

    objc_release(oldValue);
}
</code></pre></li>
<li><p>在<b style="color:red">上述危险区的第二步，<code>_testArray</code>在线程B和线程C分别指向了新地址<code>addr2</code>和<code>addr3</code></b>，<b>但是获取到的<code>oldValue</code>可能都是<code>arr1</code></b></p>
</li>
<li>通过<code>objc_release</code>对<code>oldValue</code>，也就是<code>arr1</code>进行了两次释放，妥妥的<code>double free</code>过度释放场景，导致崩溃。</li>
</ul>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/synchronized-2.png?raw=true" alt="屏幕快照 2018-12-28 上午11.05.22.png"></p>
<blockquote>
<p>备注：多线程的场景在于不确定性，可能在其中任何一个指令处挂掉。</p>
</blockquote>
<h3 id="结语">结语</h3><p>所以，从本质上来说，<code>@Synchronized</code>的确是最不应该推荐给用户使用的一种锁机制，但是其根本原因并<b style="color:red">不一定是</b>性能差距，<code>Hash</code>离散设计的优雅的话，一样能保证性能。但是其内在<b style="color:red">锁和对象上下文相关的联系会导致锁失效的场景</b>，一旦有对象发生变化（被赋值），导致潜在的锁不住多线程的场景，我们也应该去了解学习。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p>关于<code>Objective-C</code>中的<code>@Synchronized</code>，想必从事<code>iOS</code>开发相关工作的同学都不陌生，可以说这是一种最简单的加锁的方式了。</p>
<p>网上关于锁对比的文章也不在少数，太多说集中在]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[通过Xcode 10链接libstdc++来深入分析tbd文件]]></title>
    <link href="http://satanwoo.github.io/2018/12/22/LD-1/"/>
    <id>http://satanwoo.github.io/2018/12/22/LD-1/</id>
    <published>2018-12-22T15:20:59.000Z</published>
    <updated>2018-12-22T15:24:46.000Z</updated>
    <content type="html"><![CDATA[<p>相信玩<code>iOS</code>开发的同学对<code>tbd</code>这个格式的文件已经不再陌生了。最近<code>Xcode 10</code>升级的时候，你会发现很多原先用<code>libstdc++</code>的库在新的<code>Xcode</code>已经没有链接通过。而临时的解决方案也比较简单，网上也很多这样的文章，简而言之就是从<code>Xcode 9</code>中拷贝对应的<code>libstdc++.tbd</code>文件给新的<code>Xcode 10</code>来使用。</p>
<p>Ok，解决方案是有了，我们需要更深入的理解下：为什么<strong>拷贝tbd文件，就能够成功解决链接问题?</strong></p>
<h3 id="tbd格式解析">tbd格式解析</h3><p><code>tbd</code>全称是<code>text-based stub libraries</code>，本质上就是一个<strong>YAML</strong>描述的文本文件。</p>
<p>他的作用是用于记录<b style="color:red">动态库的一些信息</b>，包括导出的符号、动态库的架构信息、动态库的依赖信息。</p>
<p>为什么需要包含这些信息呢？</p>
<ul>
<li>动态库的架构信息是了确保运行的程序在运行的平台加载正确的库。比如你不能在运行<code>ARM</code>指令集的<code>iOS</code>设备上加载<code>x86</code>格式的库。</li>
</ul>
<blockquote>
<p>后续我们会举一个手动修改<code>tbd</code>中<code>install-name</code>字段的小例子来让运行在模拟器的时候加载<code>ARM64</code>架构的动态库</p>
</blockquote>
<ul>
<li>导出的符号。写过程序的人都知道，我们肯定会依赖别人提供的一些函数方法。一般业界都会把这些函数或者方法封装成库的形势。</li>
</ul>
<p>那库就分为静态库和动态库两种。相信网上关于这两者的讨论和阐述已经很多了，再次不再赘述。唯一需要提及的一点是，动态库是在程序运行（启动依赖或者按需加载）时候加载进程序的地址空间的，那么我们在静态期的时候，是如何得知动态库提供了哪些能力呢？<b style="color:red">而这就是<code>tbd</code>格式提供的导出符号表的加载，它会指导链接器在链接过程中，将需要决议的符号先做个标记，标记是来自哪个动态库。</b></p>
<p>这里举个小例子吧。<br>在程序构建的过程中，比如我们开发一个iOS应用，毋庸置疑的会用到<code>UIKit</code>这个动态库。而为了使我们的程序能够构建成功，这里分为了两个步骤：</p>
<ul>
<li><p>通过引入头文件，<code>import &lt;UIKit/UIKit.h&gt;</code>，我们知道了<code>UIKit</code>里面的函数、变量声明。有声明，就能通过编译器的检查。</p>
</li>
<li><p>我们在代码里面使用了<code>UIKit</code>的函数，其本质是一种符号，因此需要链接器来决议这个符号来自哪？要是所有地方都找到，就会报类似<code>undefined symbol</code>之类的错误（想必大家已经很熟悉了）。</p>
</li>
</ul>
<h4 id="为什么要改造成tbd格式">为什么要改造成tbd格式</h4><p><code>tbd</code>格式实际上是从<code>Xcode 7</code>时代引入的。</p>
<p><b style="color:red">用于取代在真机开发过程中直接使用传统的<code>dylib</code></b></p>
<p>我们都知道一个库在没有<code>strip</code>诸如调试信息、非导出符号的情况下是非常大的。但是由于在开发过程中，调试等过程是必不可少的，我们来对比下传统直接包含<code>dylib</code>的时候大小，我们以<code>CoreImage.framework</code>来举例：</p>
<ul>
<li>首先看下模拟器上的传统架构大小：</li>
</ul>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/ld-1-dylib.png?raw=true" alt=""></p>
<ul>
<li>再看下对应的真机上的伪<code>framework</code>(包含<code>tbd</code>)的大小</li>
</ul>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/ld-1-tbd.png?raw=true" alt=""></p>
<p>差距很明显了吧，对于真机来说，由于动态库都是在设备上，在<code>Xcode</code>上使用基于<code>tbd</code>格式的伪<code>framework</code>可以大大减少<code>Xcode</code>的大小。</p>
<blockquote>
<p>题外话：网上有人说模拟器上还是使用<code>dylib</code>，的确没错。但是模拟器现在也桥了一层<code>tbd</code>格式，真正的<code>dylib</code>是在这个路径下：<code>iPhoneOS.platform/Developer/Library/CoreSimulator/Profiles/Runtimes/iOS.simruntime/Contents</code></p>
</blockquote>
<p>此外，虽然从<code>Xcode 7</code>时代到现在，一直都是<code>tbd</code>的说法，但是它也是经历了一些演变了，目前已经发展了<code>v3</code>格式的版本。</p>
<h3 id="为什么拷贝tbd文件能解决Xcode_10上的问题">为什么拷贝tbd文件能解决Xcode 10上的问题</h3><p>网上很多人都研究过<code>dyld</code>的代码，与之对应还有一种<code>ld</code>，就是平时我们在构建程序过程中，链接过程中出错的根因：</p>
<p><img src="https://img-blog.csdn.net/20180918212007937?watermark/2/text/aHR0cHM6Ly9ibG9nLmNzZG4ubmV0L3FxXzE4NjgzOTg1/font/5a6L5L2T/fontsize/400/fill/I0JBQkFCMA==/dissolve/70" alt=""></p>
<p>既然我们通过拷贝<code>tbd</code>的方式能解决链接不过的问题，那我们就要知道<code>ld</code>是如何运用<code>tbd</code>文件的。</p>
<p>既然报错事<code>library not found</code>，我们扒一下<code>linker</code>的源码即可：</p>
<pre><code><span class="type">Options</span>::<span class="type">FileInfo</span> <span class="type">Options</span>::findLibrary(<span class="keyword">const</span> <span class="type">char</span>* rootName, <span class="type">bool</span> dylibsOnly) <span class="keyword">const</span>
{
    <span class="type">FileInfo</span> <span class="literal">result</span>;
    <span class="keyword">const</span> <span class="type">int</span> rootNameLen = strlen(rootName);
    // <span class="keyword">if</span> rootName ends <span class="keyword">in</span> .o there <span class="keyword">is</span> no .a vs .dylib choice
    <span class="keyword">if</span> ( (rootNameLen &gt; <span class="number">3</span>) &amp;&amp; (strcmp(&amp;rootName[rootNameLen-<span class="number">2</span>], <span class="string">".o"</span>) == <span class="number">0</span>) ) {
        <span class="keyword">for</span> (std::vector&lt;<span class="keyword">const</span> <span class="type">char</span>*&gt;::const_iterator it = fLibrarySearchPaths.begin();
             it != fLibrarySearchPaths.<span class="keyword">end</span>();
             it++) {
            <span class="keyword">const</span> <span class="type">char</span>* dir = *it;
            <span class="keyword">if</span> ( checkForFile(<span class="string">"%s/%s"</span>, dir, rootName, <span class="literal">result</span>) )
                <span class="keyword">return</span> <span class="literal">result</span>;
        }
    }
    <span class="keyword">else</span> {
        <span class="type">bool</span> lookForDylibs = <span class="literal">false</span>;
        switch ( fOutputKind ) {
            <span class="keyword">case</span> <span class="type">Options</span>::kDynamicExecutable:
            <span class="keyword">case</span> <span class="type">Options</span>::kDynamicLibrary:
            <span class="keyword">case</span> <span class="type">Options</span>::kDynamicBundle:
            <span class="keyword">case</span> <span class="type">Options</span>::kObjectFile:  // &lt;rdar://problem/<span class="number">15914513</span>&gt; 
                lookForDylibs = <span class="literal">true</span>;
                <span class="keyword">break</span>;
            <span class="keyword">case</span> <span class="type">Options</span>::kStaticExecutable:
            <span class="keyword">case</span> <span class="type">Options</span>::kDyld:
            <span class="keyword">case</span> <span class="type">Options</span>::kPreload:
            <span class="keyword">case</span> <span class="type">Options</span>::kKextBundle:
                lookForDylibs = <span class="literal">false</span>;
                <span class="keyword">break</span>;
        }
        switch ( fLibrarySearchMode ) {
        <span class="keyword">case</span> kSearchAllDirsForDylibsThenAllDirsForArchives:
                // first look <span class="keyword">in</span> all directories <span class="keyword">for</span> just <span class="keyword">for</span> dylibs
                <span class="keyword">if</span> ( lookForDylibs ) {
                    <span class="keyword">for</span> (std::vector&lt;<span class="keyword">const</span> <span class="type">char</span>*&gt;::const_iterator it = fLibrarySearchPaths.begin();
                         it != fLibrarySearchPaths.<span class="keyword">end</span>();
                         it++) {
                        <span class="keyword">const</span> <span class="type">char</span>* dir = *it;
                        <span class="type">auto</span> path = std::<span class="type">string</span>(dir) + <span class="string">"/lib"</span> + rootName + <span class="string">".dylib"</span>;
                        <span class="keyword">if</span> ( findFile(path, {<span class="string">".tbd"</span>}, <span class="literal">result</span>) )
                            <span class="keyword">return</span> <span class="literal">result</span>;
                    }
                    <span class="keyword">for</span> (std::vector&lt;<span class="keyword">const</span> <span class="type">char</span>*&gt;::const_iterator it = fLibrarySearchPaths.begin();
                         it != fLibrarySearchPaths.<span class="keyword">end</span>();
                         it++) {
                        <span class="keyword">const</span> <span class="type">char</span>* dir = *it;
                        <span class="keyword">if</span> ( checkForFile(<span class="string">"%s/lib%s.so"</span>, dir, rootName, <span class="literal">result</span>) )
                            <span class="keyword">return</span> <span class="literal">result</span>;
                    }
                }
                // next look <span class="keyword">in</span> all directories <span class="keyword">for</span> just <span class="keyword">for</span> archives
                <span class="keyword">if</span> ( !dylibsOnly ) {
                    <span class="keyword">for</span> (std::vector&lt;<span class="keyword">const</span> <span class="type">char</span>*&gt;::const_iterator it = fLibrarySearchPaths.begin();
                         it != fLibrarySearchPaths.<span class="keyword">end</span>();
                         it++) {
                        <span class="keyword">const</span> <span class="type">char</span>* dir = *it;
                        <span class="keyword">if</span> ( checkForFile(<span class="string">"%s/lib%s.a"</span>, dir, rootName, <span class="literal">result</span>) )
                            <span class="keyword">return</span> <span class="literal">result</span>;
                    }
                }
                <span class="keyword">break</span>;

            <span class="keyword">case</span> kSearchDylibAndArchiveInEachDir:
                // look <span class="keyword">in</span> each directory <span class="keyword">for</span> just <span class="keyword">for</span> a dylib then <span class="keyword">for</span> an archive
                <span class="keyword">for</span> (std::vector&lt;<span class="keyword">const</span> <span class="type">char</span>*&gt;::const_iterator it = fLibrarySearchPaths.begin();
                     it != fLibrarySearchPaths.<span class="keyword">end</span>();
                     it++) {
                    <span class="keyword">const</span> <span class="type">char</span>* dir = *it;
                    <span class="type">auto</span> path = std::<span class="type">string</span>(dir) + <span class="string">"/lib"</span> + rootName + <span class="string">".dylib"</span>;
                    <span class="keyword">if</span> ( lookForDylibs &amp;&amp; findFile(path, {<span class="string">".tbd"</span>}, <span class="literal">result</span>) )
                        <span class="keyword">return</span> <span class="literal">result</span>;
                    <span class="keyword">if</span> ( lookForDylibs &amp;&amp; checkForFile(<span class="string">"%s/lib%s.so"</span>, dir, rootName, <span class="literal">result</span>) )
                        <span class="keyword">return</span> <span class="literal">result</span>;
                    <span class="keyword">if</span> ( !dylibsOnly &amp;&amp; checkForFile(<span class="string">"%s/lib%s.a"</span>, dir, rootName, <span class="literal">result</span>) )
                        <span class="keyword">return</span> <span class="literal">result</span>;
                }
                <span class="keyword">break</span>;
        }
    }
    throwf(<span class="string">"library not found for -l%s"</span>, rootName);
}
</code></pre><ul>
<li><p><code>throwf(&quot;library not found for -l%s&quot;, rootName);</code> 这里我们就找到了错误发生的原因，我们再往上溯源，找到<code>linker</code>处理编译单元的入口：</p>
</li>
<li><p><code>InputFiles::addOtherLinkerOptions</code>里面存在如下代码：</p>
<pre><code>CStringSet newLibraries = <span class="built_in">std</span>::move(state.unprocessedLinkerOptionLibraries);
    state.unprocessedLinkerOptionLibraries.clear();
    <span class="keyword">for</span> (<span class="keyword">const</span> <span class="keyword">char</span>* libName : newLibraries) {
        <span class="keyword">if</span> ( state.linkerOptionLibraries.count(libName) )
            <span class="keyword">continue</span>;
        <span class="keyword">try</span> {
            Options::FileInfo info = _options.findLibrary(libName);
            <span class="keyword">if</span> ( ! <span class="keyword">this</span>-&gt;libraryAlreadyLoaded(info.path) ) {
                _linkerOptionOrdinal = _linkerOptionOrdinal.nextLinkerOptionOrdinal();
                info.ordinal = _linkerOptionOrdinal;
                 <span class="comment">//&lt;rdar://problem/17787306&gt; -force_load_swift_libs</span>
                info.options.fForceLoad = _options.forceLoadSwiftLibs() &amp;&amp; (<span class="built_in">strncmp</span>(libName, <span class="string">"swift"</span>, <span class="number">5</span>) == <span class="number">0</span>);
                ld::File* reader = <span class="keyword">this</span>-&gt;makeFile(info, <span class="literal">true</span>);
                ld::dylib::File* dylibReader = <span class="keyword">dynamic_cast</span>&lt;ld::dylib::File*&gt;(reader);
                ld::archive::File* archiveReader = <span class="keyword">dynamic_cast</span>&lt;ld::archive::File*&gt;(reader);
                <span class="keyword">if</span> ( dylibReader != <span class="literal">NULL</span> ) {
                    dylibReader-&gt;forEachAtom(handler);
                    dylibReader-&gt;setImplicitlyLinked();
                    dylibReader-&gt;setSpeculativelyLoaded();
                    <span class="keyword">this</span>-&gt;addDylib(dylibReader, info);
                }
                <span class="keyword">else</span> <span class="keyword">if</span> ( archiveReader != <span class="literal">NULL</span> ) {
                    _searchLibraries.push_back(LibraryInfo(archiveReader));
                    _options.addDependency(Options::depArchive, archiveReader-&gt;path());
                    <span class="comment">//&lt;rdar://problem/17787306&gt; -force_load_swift_libs</span>
                    <span class="keyword">if</span> (info.options.fForceLoad) {
                        archiveReader-&gt;forEachAtom(handler);
                    }
                }
                <span class="keyword">else</span> {
                    throwf(<span class="string">"linker option dylib at %s is not a dylib"</span>, info.path);
                 }
             }
         }
        <span class="keyword">catch</span> (<span class="keyword">const</span> <span class="keyword">char</span>* msg) {
            <span class="comment">// &lt;rdar://problem/40829444&gt; only warn about missing auto-linked library if some missing symbol error happens later</span>
            state.missingLinkerOptionLibraries.insert(libName);
        }
        state.linkerOptionLibraries.insert(libName);
    }
</code></pre></li>
</ul>
<p><strong>而上述这些需要查询的<code>library</code>是从哪里来的呢？</strong> </p>
<ul>
<li><p>我们以<code>xcconfig</code>举例来看：</p>
<pre><code>OTHER_LDFLAGS = $(inherited) -ObjC <span class="operator">-l</span><span class="string">"stdc++"</span>
</code></pre></li>
</ul>
<p>在链接过程中就需要处理这样的<code>stdc++</code> <strong>Library</strong>，而查询的方式就是在特定目录结构中搜索是否有对应的库文件或者<code>tbd</code>文件。</p>
<h3 id="后记">后记</h3><p>使用<code>tbd</code>当然不止减少<code>Xcode</code>体积大小这一个好处，嘿嘿，你们自己摸索下吧～</p>
<p>而且，基于这种思路，能玩出许多类似文体两开花，中美合拍美猴王的玩法，加油吧。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p>相信玩<code>iOS</code>开发的同学对<code>tbd</code>这个格式的文件已经不再陌生了。最近<code>Xcode 10</code>升级的时候，你会发现很多原先用<code>libstdc++</code>的库在新的<code>Xcode</cod]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[谈谈JSDebugger]]></title>
    <link href="http://satanwoo.github.io/2018/10/06/JSDebugger-INTRO/"/>
    <id>http://satanwoo.github.io/2018/10/06/JSDebugger-INTRO/</id>
    <published>2018-10-05T17:32:55.000Z</published>
    <updated>2018-10-08T08:40:41.000Z</updated>
    <content type="html"><![CDATA[<h3 id="务虚乱弹">务虚乱弹</h3><blockquote>
<p>JSDebugger开源地址：<a href="https://github.com/SatanWoo/JSDebugger" target="_blank" rel="external">https://github.com/SatanWoo/JSDebugger</a>  </p>
</blockquote>
<p>这是一篇谈谈设计<code>JSDebugger</code>的总体设想，不会过于深究具体实现细节，后续会单独探讨一些涉及实现方面的过程。</p>
<p>读过我之前博客的朋友可能会记得我3-4月份的时候写过一篇<a href="http://satanwoo.github.io/2018/04/01/jsengine/">动手制作一个简易的iOS动态执行器</a>，效果如下：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/jstester.gif?raw=true" alt=""></p>
<p>虽然这个效果还起来还不错（有许多人问这个东西咋实现的，挺炫酷的），但是其实只是个原型而已，从设想构思到编码实现没有超过一天的时间。当时在博文里面承诺发代码，想想实现的完善度还不够，就准备完善后再继续搞搞。不过后来由于我转到其他组不继续钻研<code>iOS</code>，这事也就不了了之。</p>
<p><strong><span style="color:red">那为什么现在又重新开搞呢？</span></strong>，三点原因吧：</p>
<ol>
<li>有朋友在群里问我之前提过的<code>Mach-o</code>包瘦身方案怎么也没发文章？</li>
<li>看到同事查非Crash产生的Bug的过程还是比较累。</li>
</ol>
<p>好，来说说前两个原因：</p>
<ul>
<li>第一点，有些文章为什么后续不发，主要原因还是很多产出和收获都是工作中和同事一起探讨研究出来的，发出来一是泄漏了公司的数据（职业操守还是很重要的），二是相当于霸占了一些别人的工作成果。比如说我之前写的内存等等，对外发的一般都是只和开源代码相关的同时删减了大部分略微关键的部分，所以导致有些读者读起来断断续续云里雾里。</li>
</ul>
<blockquote>
<p>完整版的很多文章或者一些没对外的技术研究，我都发在了公司的内网里，欢迎加入阿里巴巴。</p>
</blockquote>
<ul>
<li>第二点，我之前有段时间负责手淘的稳定性，除了有堆栈的Crash问题外，更多是用户反馈的使用异常以及毫无头绪的奇怪现象。针对这种问题，我相信各家(甚至开源方案)一般都有自己的监控体系，比如日志啊、埋点等等。但是怎么说呢，从我的感受来看，都是使用起来偏繁琐，而且<strong><span style="color:blue">还依赖对应的开发把错误信息等现场保留写入到日志内。</span></strong>我想要的就是一个能像我在自己手机上调试应用一样调试用户手机的能力（前提是用户授权同意），因此我就想做了一个这样的工具。结合自己以前玩逆向的些许经历，<code>Cycript</code>就提供了类似的能力，因此就利用业余时间做了一个<strong>JSDebugger</strong>。</li>
</ul>
<p><strong><span style="color:red">说了这么多原因，其实还是我太懒了。</span></strong></p>
<h3 id="JSDebugger">JSDebugger</h3><p>言归正传，回到<strong>JSDebugger</strong>本身，基于之前的代码，这次主要做了完整性的代码重构重写以及功能完善上。</p>
<ul>
<li>类方法调用</li>
<li>实例方法调用</li>
<li>Setter &amp; Getter的调用</li>
<li>可变参数的函数调用</li>
<li>C Pointer的使用</li>
<li>基础类型的使用</li>
<li>对象和类的使用</li>
<li>结构体的使用（目前支持<code>CGSize</code>, <code>CGRect</code>, <code>CGPoint</code>，正在开发自定义注册接口）</li>
<li>插件化的扩展功能。</li>
</ul>
<p>同时，为了更好的测试所写的<code>JavaScript</code>代码，开发了玩具级别的<code>Playground</code>功能，每次实时修改文件后保存即可自动触发<code>Reload</code>。</p>
<p>很多细节此文不表，但是有些功能上的实现还是比较用心的，比如支持了各种类型、个数的可变参数的函数调用，比如目前支持了<code>choose</code>和<code>introspect</code>的能力，二者配合可以对任意对象实时查询其当前所有的属性值。</p>
<p>而且，我对<code>JavaScriptCore</code>的使用可能和常规大家所属性的<code>iOS JavaScriptCore</code>有所区别，利用更低层的设计思路，经过我实测：</p>
<p>更低层的设计桥接思路在<code>iOS</code>上同比基于<code>Objective-C</code>的使用方式可以节省<strong>50%</strong>的时间；同比在<code>Android</code>上使用开源的<code>JavaScriptCore</code>是<strong>50分之一左右</strong>的时间。</p>
<blockquote>
<p>当然Android上比较主流的JS引擎室v8咯</p>
</blockquote>
<p>具体快原因可以阅读<a href="http://satanwoo.github.io/2018/04/01/jsengine/">动手制作一个简易的iOS动态执行器</a>中涉及的<code>JavaScriptCore</code>上层源码分析以及阅读我的<strong>JSDebugger</strong>源码。</p>
<p>目前<strong>JSDebugger</strong>还在不断完善中，后续会把我更多的想法移植到里面，总体规划有几个关键点：</p>
<ul>
<li><p>实现一个交互式的编辑器（或者命令行），能够让大家写<code>Objective-C</code>的代码自动转换成<strong>JSDebugger</strong>的JS语法。以我目前的技术水准，还做不到<code>Cycript</code>那种牛逼的<code>Objective-C</code>和<code>JavaScript</code>的混合语法模式。</p>
</li>
<li><p>实现远程图形化<code>Debug</code>能力。目前<strong>JSDebugger</strong>可以调试数据，但是如果能像<code>Reveal</code>一样把操作界面和数据结合起来就会更有效的定位问题。</p>
</li>
</ul>
<p>欢迎有想法的朋友一起来参与完善这个项目，开源地址如下：</p>
<p><strong><a href="https://github.com/SatanWoo/JSDebugger" target="_blank" rel="external">https://github.com/SatanWoo/JSDebugger</a></strong></p>
<p><strong><span style="color:red"><a href="https://github.com/SatanWoo/JSDebugger" target="_blank" rel="external">https://github.com/SatanWoo/JSDebugger</a></span></strong></p>
<p><strong><a href="https://github.com/SatanWoo/JSDebugger" target="_blank" rel="external">https://github.com/SatanWoo/JSDebugger</a></strong></p>
<p>当然，要是发现了任何的Bug或者使用上的疑惑、抑或是可以改进的点，也可以私聊我或者开<code>issue</code>。</p>
<h3 id="最后">最后</h3><p>实现<strong>JSDebugger</strong>的过程，还是站在两个杰出的项目肩膀上：</p>
<ul>
<li>Cycript</li>
<li>JSPatch</li>
</ul>
<p>我的思路是来自于<code>Cycript</code>，诸如结构体等许多方面的实现细节是参考了<code>JSPatch</code>。在这里对这几个项目的作者和代码贡献者表示感谢！</p>
<p>此外，很多的技术方案是和<strong>HookZZ</strong>大神交流（主要是他教我）中学习而来，在这也特别感谢。也感谢头条的谢大佬的代码贡献以及寒神的<code>Code Style</code>整理。</p>
<p>当然，<strong>JSDebugger</strong>在实现上还是有很多自己思考的部分，感兴趣的读者可以自行前往<a href="https://github.com/SatanWoo/JSDebugger" target="_blank" rel="external">JSDebugger的Github开源地址</a></p>
]]></content>
    <summary type="html">
    <![CDATA[<h3 id="务虚乱弹">务虚乱弹</h3><blockquote>
<p>JSDebugger开源地址：<a href="https://github.com/SatanWoo/JSDebugger" target="_blank" rel="external">https:]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[C++实现一个识别MNIST数字的卷积神经网络]]></title>
    <link href="http://satanwoo.github.io/2018/05/09/MNIST/"/>
    <id>http://satanwoo.github.io/2018/05/09/MNIST/</id>
    <published>2018-05-08T17:04:49.000Z</published>
    <updated>2018-05-08T17:55:18.000Z</updated>
    <content type="html"><![CDATA[<p>新的一个财年加入了新的组，从事机器学习相关的工作。由于之前做的一直是iOS（略微底层）方面的事情，初来乍到，对很多东西不熟悉，在超级大神ZB的建议下，用C++实现一个多层前馈神经网络，来识别MNIST数据中的各种手写图片。</p>
<h3 id="素材寻找">素材寻找</h3><ul>
<li>感谢这位不知名的大佬提供的MNIST数据集，可以直接下载<a href="https://pan.baidu.com/s/1pLMV4Kz" target="_blank" rel="external">纯图片数据集</a></li>
<li>搜索下载已经调整好的<code>weight</code>和<code>bias</code>模型。（下文会介绍）</li>
</ul>
<h3 id="实现过程">实现过程</h3><p>关于实现多层前馈神经网络，网络上的答案数不胜数，但是大多数都是参考Tensorflow或者Caffe（PyTorch）去实现，我觉得这样很不好。因为学习一门新技术，虽然快速完成项目看出效果很重要，但是对个人来说，弄懂黑盒背后的故事非常重要。因此我决定不依赖任何的库来完全裸写。</p>
<blockquote>
<p>当然，对于我来说，实现的完整度和正确性是第一位的，我并没有过多的关注性能。</p>
</blockquote>
<p>虽然在深度学习高度发展的今天，类似于<code>AlexNet</code>这样的网络模型能够近乎完美的识别手写数据集。但是作为这个领域的入门级选手，我还是想追溯起源，从头开始做起。因此，在一番学习和搜索后，我选定了<code>LeNet-5</code>模型进行编写。选择它的原因主要有如下几点：</p>
<ul>
<li>它自身是一个多层的前馈网络模型。</li>
<li>麻雀虽小，五脏俱全。包含了卷积层、全联接层、放缩、灰度以及池化层。同时还引入了<code>ReLu</code>，<code>Softmax</code>等激活函数。</li>
<li><b style="color:red">实现简单，哈哈哈哈哈</b></li>
</ul>
<h3 id="LeNet-5">LeNet-5</h3><p><code>LeNet-5</code>整体是个非常简单的过程，包含如下步骤：</p>
<ol>
<li>接受一个RGBA的图像。这个很简单，直接在RGBA的颜色空间下读取即可。</li>
<li>放缩到<strong>28 * 28</strong>（保留所有的feature）的大小，采用的是<code>bilinear</code>插值方法。</li>
<li>灰度化，公式如下：<code>r / 255.0 * 0.299 + g / 255.0 * 0.587 + b /255.0 * 0.114</code>。</li>
<li>取反，即<code>255.0 - 灰度化的结果</code></li>
<li><strong>5 * 5</strong>大小的卷积，加<code>Relu</code>，进行第一次卷积操作。（这里为了保证卷积后尺寸一致，添加了Padding）</li>
<li>最大池化层降采样。</li>
<li><strong>5 * 5</strong>大小的进行第二次卷积，加<code>ReLu</code>，进行第一次卷积操作。（这里为了保证卷积后尺寸一致，添加了Padding）</li>
<li>最大池化层降采样。</li>
<li>全链接计算 + <code>ReLu</code></li>
<li>全链接输出10个<code>featureMap</code></li>
<li><code>Softmax</code>计算并去除最大的值，即为检测的数字结果。</li>
</ol>
<p><b style="color:red">整体实现上没什么需要特别注意的，如果对这里的名次不懂，可以上网自行查询对应的解释。不过这里有一点很不好，浪费了大量的时间在调试我定义的张量的格式和网上找到的<code>weight</code>模型的格式。</b></p>
<p>什么意思呢？我大致用如下的图解释下我自身设计的张量是如何存储的。</p>
<p>理论上来讲，张量有三个维度，<code>width</code>, <code>height</code>, <code>featureChannels</code>。我在设计我的张量存储上按照的<code>data[height][row][featureChannels]</code>的方式，然后全部拍成了一维。如图所示：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnist1.png?raw=true" alt=""></p>
<blockquote>
<p>之所以想这么做，主要是瞄了眼<code>TensorFlow</code>也是类似的设计，然后印象中CUDA也是按照这样维度进行存储，貌似可以有效做并行计算拆分。（这个不确定）</p>
</blockquote>
<p>然后为什么卡了很久呢？主要是<code>weights</code>和<code>bias</code>的模型文件是个按照自定义协议二进制流的文件（非结构化的数据）。</p>
<p>这模型由于是我网上找的，一开始没注意模型的自定义协议和我设计的张量直接的区别。我直接按照我的张亮顺序进行了相乘，得到了十分错误的结果。</p>
<p>当然，<code>bias</code>模型没什么好说的，就是按照<code>outputFeatureMap</code>定义的纯一维数组，不会出错。</p>
<p>后来发现这个模型是基于苹果的<code>MPS</code>设计的模型，它的模型是这样的数据结构<code>weights[outputChannels][height][width][inputChannel/group]</code>。第一维在计算的时候需要和我做个映射，所以这里没搞清楚模型格式，查了比较久。</p>
<p><b style="color:red">当然，我在加载权重和bias这块还是做了点小油画。用了<code>mmap</code>，避免一次性直接搞进来太大的数据，反正看起来<code>weight</code>和<code>bias</code>这块并不需要一次性的读取，而且只读的<code>mmap</code>还能合理利用iOS设备上的clean memory回收机制。</b></p>
<h3 id="框架设计">框架设计</h3><ul>
<li><p>网络模型拓扑结构，<code>MinstGraph</code>。这里偷懒了，因为<code>LeNet-5</code>也没啥复杂的拓扑结构，不用考虑多个节点连接，直接线性跑下去就好。</p>
</li>
<li><p>支持任意多维度的张量，类似<code>Tensorflow</code>里面的<code>Tensor</code>，这里对应了<code>MinstImage</code>。</p>
</li>
<li>各种Layer，如<code>MaxPoolingLayer</code>，<code>ConvolutionLayer</code>, <code>FullConnectionLayer</code>等等。</li>
<li>各种激活函数，如<code>Relu</code>，<code>Softmax</code>等等。</li>
<li>一些辅助函数之类的。</li>
</ul>
<p>代码下周发吧。</p>
<h3 id="效果">效果</h3><p>准确度一开始不怎么高，检查了很多遍代码，确实发现了一些问题，比如数据精度问题。</p>
<p>一开始从图像的角度理解，认为用<code>unsigned char</code>存储一个数据点就够了，毕竟图像像素点(RGB空间下)的取值范围就是<strong>0-255</strong>。</p>
<p>后来发现在计算卷积、全链接层的时候会产生很多小数，用<code>unsigned char</code>存储精度全部丢失了。因此修改成了现在的<code>float</code>设计。对效果提升还是比较明显的。</p>
<p>后来专门跑了下苹果基于Metal实现的卷积神经网络，由于上述我自身实现的<strong>所有Layer和激活函数</strong>在苹果的框架中都有内置，因此把网络模型搭起来跑就完了（除非苹果自己实现有错）。然后对比我的每一层输入输出和对应的<code>MPSImage</code>输入输出。</p>
<p>不过这里有一点要注意，<code>MPSImage</code>的数据格式是<strong>NHWC</strong>，这里的N是把C按照4对齐后分成的不同batch。如下图所示：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnist2.png?raw=true" alt=""></p>
<p>假设是一个<code>2 * 1 * 5</code>(w <em> h </em> c)的数据，会先把前4层排完，再进行第五层的排列，按4对齐后多出来的三个层补0。</p>
<p>我的代码里面<code>MinstImage</code>提供了一个<code>print</code>方法就是专门做输出对比的。嗯，对比了我的实现和用苹果框架的下输入输出，结果是一致的。(除了iOS10上不支持<code>bilinear</code>插值)</p>
<p>最终效果如下图：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/mnist3.png?raw=true" alt=""></p>
<p><b style="color:red">备注：</b></p>
<blockquote>
<p>如果直接用我开头提到的MNIST数据集，由于每张图都是<strong>28 * 28</strong>的灰度图，因此不需要resize + grayscale，直接从取反开始计算就可以了。</p>
</blockquote>
<h3 id="后续规划">后续规划</h3><ol>
<li><p>做神经网络还是挺有意思，不过目前还是参考简单的模型结构实现，主要做<code>inference</code>。还没真正去研究训练模型这块。<strong>这块需要多深入研究算法，多读论文。</strong></p>
</li>
<li><p>目前并没有真正设计<code>Session</code>的概念。<strong>理论上一张图就是一个静态的拓扑结构的组合而已，不应该承担类似执行<code>run</code>的功能</strong>。后续业余时间还会继续实现完整这套逻辑，将静态结构和动态执行结构彻底分离。</p>
</li>
<li><p>后续有时间的话，可以尝试实现别的模型。同时支持从文件中读取已经建立好的模型，类似Caffee模型之类的</p>
</li>
<li><p>移植到GPU上。</p>
</li>
</ol>
<h3 id="最后">最后</h3><p>文章的最后，按照惯例还是向我的偶像致敬。机器学习发展到今天，已经成为了不可忽视的研究方向。对于我们这样的后生来说，站在大牛的肩膀上是我们的福气和基石。而像杨萧玉这样，能够一周时间内学完机器学习课程，发表博客造福大众，才是推动机器学习不断发展的中坚力量。相信在他的带领下，我们国家一定能够在2030年达到全球领先的AI技术水准。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p>新的一个财年加入了新的组，从事机器学习相关的工作。由于之前做的一直是iOS（略微底层）方面的事情，初来乍到，对很多东西不熟悉，在超级大神ZB的建议下，用C++实现一个多层前馈神经网络，来识别MNIST数据中的各种手写图片。</p>
<h3 id="素材寻找">素材寻找</h]]>
    </summary>
    
      <category term="Machine Learning" scheme="http://satanwoo.github.io/tags/Machine-Learning/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[动手制作一个简易的iOS动态执行器]]></title>
    <link href="http://satanwoo.github.io/2018/04/01/jsengine/"/>
    <id>http://satanwoo.github.io/2018/04/01/jsengine/</id>
    <published>2018-03-31T16:26:55.000Z</published>
    <updated>2018-04-01T15:11:33.000Z</updated>
    <content type="html"><![CDATA[<p>之前听说滴滴的<code>DynamicCocoa</code>是基于JavaScriptCore搞得，一直期待看到他们的真正实现，不过可能后来由于公司机密，应该不能再开源了。</p>
<p>借着最近开始研究JavaScriptCore的契机，我决定利用这一两天所学的JavaScript知识，在业余时间做一个简单的iOS动态执行器玩具。</p>
<blockquote>
<p>题外话1：听说滴滴基于LLVM backend搞了一套中间语言解释器，不知道最后用了哪个？不过LLVM IR解释器的话，嘿嘿，还是有点意思的。</p>
<p>题外话2：我研究这个并不是想做iOS动态化，因为xxxxxxx。我只是纯粹想看看JavaScriptCore的一些实现而已。</p>
</blockquote>
<h3 id="效果">效果</h3><p>一张Gif图想必能最佳得展示我做的玩具，请各位大佬过目：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/jstester.gif?raw=true" alt=""></p>
<h3 id="前置知识点">前置知识点</h3><p>在实现我们的执行器前，我们还是要稍微要了解一下一些前置的知识点。</p>
<h4 id="JSWrapper_Object">JSWrapper Object</h4><p>大家都知道，Objective-C中的诸多类型在JavaScript的环境里是不能直接用的，需要通过JSValue进行一层包装，具体的类型转换如下图展示：</p>
<p><img src="http://upload-images.jianshu.io/upload_images/762048-c669c91024c9308b.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240" alt=""></p>
<p>基本上图上的转换都很容易理解，唯一需要我们注意的是<code>Wrapper Object</code>。什么是<code>Wrapper Object</code>呢？</p>
<p>举个例子：</p>
<pre><code><span class="built_in">self</span><span class="built_in">.</span>context<span class="preprocessor">[</span>@<span class="string">"a"</span><span class="preprocessor">]</span><span class="markup"> = </span><span class="preprocessor">[</span>CustomObject <span class="literal">new</span><span class="preprocessor">]</span><span class="markup"></span>
</code></pre><p>上述代码将我们一个自定义类型<code>CustomObject</code>的实例以变量名<code>a</code>的方式注入到了JavaScript的运行环境里。但是她是怎么知道我们的定义呢，又是如何知道我们是否能调用特定的方法？</p>
<p>从默认的角度看，JS运行环境只会把OC中<code>init</code>初始化方法以及类的继承关系给同步到JS环境中（如果有JSExport我们下文说），然后这个对象会包装给一个JSWrapperValue用于JS环境中使用。而当JS环境调用OC并且涉及到这个对象的时候，JavaScriptCore会自动将其解包还原成原始的OC对象类型。</p>
<pre><code>- <span class="list">(<span class="keyword">JSValue</span> <span class="variable">*)jsWrapperForObject:(id)object
{
    JSC::JSObject*</span> jsWrapper = m_cachedJSWrappers.get<span class="list">(<span class="keyword">object</span>)</span><span class="comment">;</span>
    if <span class="list">(<span class="keyword">jsWrapper</span>)</span>
        return [JSValue valueWithJSValueRef<span class="keyword">:toRef</span><span class="list">(<span class="keyword">jsWrapper</span>)</span> inContext<span class="keyword">:m_context</span>]<span class="comment">;</span>

     // 注意点!!!!!!!!!!!!!!!!!!
    JSValue <span class="variable">*wrapper;
    if (class_isMetaClass(object_getClass(object)))
        wrapper = [[self classInfoForClass:(Class)object] constructor];
    else {
        JSObjCClassInfo*</span> classInfo = [self classInfoForClass:[object class]]<span class="comment">;</span>
        wrapper = [classInfo wrapperForObject<span class="keyword">:object</span>]<span class="comment">;</span>
    }

    JSC:<span class="keyword">:ExecState*</span> exec = toJS<span class="list">([m_context JSGlobalContextRef])</span><span class="comment">;</span>
    jsWrapper = toJS<span class="list">(<span class="keyword">exec</span>, valueInternalValue<span class="list">(<span class="keyword">wrapper</span>)</span>)</span>.toObject<span class="list">(<span class="keyword">exec</span>)</span><span class="comment">;</span>
    m_cachedJSWrappers.set<span class="list">(<span class="keyword">object</span>, jsWrapper)</span><span class="comment">;</span>
    return wrapper<span class="comment">;</span>
}</span>
</code></pre><ul>
<li>整体分析下，就是基于一个缓存来判断是否对特定的对象或类型已经构建果<code>Wrapper Object</code>，没有的话就进行构建，构建过程如下：</li>
</ul>
<figure class="highlight dns"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><span class="line">JSClassDefinition definition<span class="comment">;</span></span><br><span class="line"></span><br><span class="line">definition = kJSClassDefinitionEmpty<span class="comment">;</span></span><br><span class="line">definition.className = className<span class="comment">;</span></span><br><span class="line">m_classRef = JSClassCreate(&amp;definition)<span class="comment">;</span></span><br><span class="line"></span><br><span class="line">[self allocateConstructorAndPrototypeWithSuperClassInfo:superClassInfo]<span class="comment">;</span></span><br></pre></td></tr></table></figure>
<ul>
<li>没啥特别的，就是OC对象创建对应的JS对象，类型对类型。</li>
<li>OC类型的继承关系在JS里面通过设置Constructor和Prototype进行构建，其实就是简单的JavaScript原型链继承。</li>
</ul>
<h4 id="JSExport协议_&amp;_JSExportAs">JSExport协议 &amp; JSExportAs</h4><p><code>JSExport</code>协议本质上只是个<code>Protocol</code>标记，用于让JavaScriptCore加载那些打上这个特殊标记的类，用于特定方式的注册及初始化。</p>
<p>上文我们提过，默认情况下，JavaScriptCore会对象创建一个默认的<code>Wrapper Object</code>，但是这个对象除了简单继承关系外，也就一个按照特殊格式命令的<code>Constructor</code>而已：</p>
<p><code>[NSString stringWithFormat:@&quot;%sConstructor&quot;, className]</code></p>
<p>那如果我们需要将OC环境中的方法注入到JS环境中，就需要用到<code>JSExport</code>协议了，这个协议在运行时会按照如下逻辑进行处理，将方法和属性进行诸如注入：</p>
<figure class="highlight nimrod"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br><span class="line">31</span><br><span class="line">32</span><br><span class="line">33</span><br><span class="line">34</span><br><span class="line">35</span><br><span class="line">36</span><br><span class="line">37</span><br><span class="line">38</span><br><span class="line">39</span><br><span class="line">40</span><br><span class="line">41</span><br><span class="line">42</span><br><span class="line">43</span><br><span class="line">44</span><br><span class="line">45</span><br></pre></td><td class="code"><pre><span class="line">检查init方法簇的方法，并根据这么合法提供合理的</span><br><span class="line"></span><br><span class="line">__block <span class="type">HashMap</span>&lt;<span class="type">String</span>, <span class="type">Protocol</span> *&gt; initTable;</span><br><span class="line">    <span class="type">Protocol</span> *exportProtocol = getJSExportProtocol();</span><br><span class="line">    <span class="keyword">for</span> (<span class="type">Class</span> currentClass = cls; currentClass; currentClass = class_getSuperclass(currentClass)) &#123;</span><br><span class="line">        forEachProtocolImplementingProtocol(currentClass, exportProtocol, ^(<span class="type">Protocol</span> *protocol) &#123;</span><br><span class="line">            forEachMethodInProtocol(protocol, <span class="type">YES</span>, <span class="type">YES</span>, ^(<span class="type">SEL</span> selector, <span class="keyword">const</span> <span class="type">char</span>*) &#123;</span><br><span class="line">                <span class="keyword">const</span> <span class="type">char</span>* name = sel_getName(selector);</span><br><span class="line">                <span class="keyword">if</span> (!isInitFamilyMethod(@(name)))</span><br><span class="line">                    <span class="keyword">return</span>;</span><br><span class="line">                initTable.<span class="type">set</span>(name, protocol);</span><br><span class="line">            &#125;);</span><br><span class="line">        &#125;);</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="keyword">for</span> (<span class="type">Class</span> currentClass = cls; currentClass; currentClass = class_getSuperclass(currentClass)) &#123;</span><br><span class="line">        __block unsigned numberOfInitsFound = <span class="number">0</span>;</span><br><span class="line">        __block <span class="type">SEL</span> initMethod = <span class="number">0</span>;</span><br><span class="line">        __block <span class="type">Protocol</span> *initProtocol = <span class="number">0</span>;</span><br><span class="line">        __block <span class="keyword">const</span> <span class="type">char</span>* types = <span class="number">0</span>;</span><br><span class="line">        forEachMethodInClass(currentClass, ^(<span class="type">Method</span> <span class="keyword">method</span>) &#123;</span><br><span class="line">            <span class="type">SEL</span> selector = method_getName(<span class="keyword">method</span>);</span><br><span class="line">            <span class="keyword">const</span> <span class="type">char</span>* name = sel_getName(selector);</span><br><span class="line">            <span class="type">auto</span> iter = initTable.find(name);</span><br><span class="line"></span><br><span class="line">            <span class="keyword">if</span> (iter == initTable.<span class="keyword">end</span>())</span><br><span class="line">                <span class="keyword">return</span>;</span><br><span class="line"></span><br><span class="line">            numberOfInitsFound++;</span><br><span class="line">            initMethod = selector;</span><br><span class="line">            initProtocol = iter-&gt;value;</span><br><span class="line">            types = method_getTypeEncoding(<span class="keyword">method</span>);</span><br><span class="line">        &#125;);</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> (!numberOfInitsFound)</span><br><span class="line">            <span class="keyword">continue</span>;</span><br><span class="line"></span><br><span class="line">        <span class="keyword">if</span> (numberOfInitsFound &gt; <span class="number">1</span>) &#123;</span><br><span class="line">            <span class="type">NSLog</span>(@<span class="string">"ERROR: Class %@ exported more than one init family method via JSExport. Class %@ will not have a callable JavaScript constructor function."</span>, cls, cls);</span><br><span class="line">            <span class="keyword">break</span>;</span><br><span class="line">        &#125;</span><br><span class="line"></span><br><span class="line">        <span class="type">JSObjectRef</span> <span class="keyword">method</span> = objCCallbackFunctionForInit(context, cls, initProtocol, initMethod, types);</span><br><span class="line">        <span class="keyword">return</span> [<span class="type">JSValue</span> valueWithJSValueRef:<span class="keyword">method</span> inContext:context];</span><br><span class="line">    &#125;</span><br></pre></td></tr></table></figure>
<figure class="highlight dns"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><span class="line">注入方法和属性</span><br><span class="line">Protocol *exportProtocol = getJSExportProtocol()<span class="comment">;</span></span><br><span class="line">forEachProtocolImplementingProtocol(m_class, exportProtocol, ^(Protocol *protocol)&#123;</span><br><span class="line">  copyPrototypeProperties(m_context, m_class, protocol, prototype)<span class="comment">;</span></span><br><span class="line">  copyMethodsToObject(m_context, m_class, protocol, NO, constructor)<span class="comment">;</span></span><br><span class="line">&#125;)<span class="comment">;</span></span><br></pre></td></tr></table></figure>
<p>而至于<code>JSExportAs</code>，就是做了个简单的名称映射而已，毕竟JS函数传参和OC有很大的区别：</p>
<pre><code><span class="keyword">static</span> <span class="built_in">NSMutableDictionary</span> *createRenameMap(Protocol *protocol, <span class="built_in">BOOL</span> isInstanceMethod)
{
    <span class="built_in">NSMutableDictionary</span> *renameMap = [[<span class="built_in">NSMutableDictionary</span> alloc] init];

    forEachMethodInProtocol(protocol, <span class="literal">NO</span>, isInstanceMethod, ^(SEL sel, <span class="keyword">const</span> <span class="keyword">char</span>*){
        <span class="built_in">NSString</span> *rename = @(sel_getName(sel));
        <span class="built_in">NSRange</span> range = [rename rangeOfString:<span class="string">@"__JS_EXPORT_AS__"</span>];
        <span class="keyword">if</span> (range<span class="variable">.location</span> == <span class="built_in">NSNotFound</span>)
            <span class="keyword">return</span>;
        <span class="built_in">NSString</span> *selector = [rename substringToIndex:range<span class="variable">.location</span>];
        <span class="built_in">NSUInteger</span> begin = range<span class="variable">.location</span> + range<span class="variable">.length</span>;
        <span class="built_in">NSUInteger</span> length = [rename length] - begin - <span class="number">1</span>;
        <span class="built_in">NSString</span> *name = [rename substringWithRange:(<span class="built_in">NSRange</span>){ begin, length }];
        renameMap[selector] = name;
    });

    <span class="keyword">return</span> renameMap;
}
</code></pre><h3 id="实现过程">实现过程</h3><p><b style="color:red">说了那么多基础原理，下面让我们来看看具体实现流程：</b></p>
<h4 id="类、实例和方法">类、实例和方法</h4><p>在我看来，要实现一个动态化的执行环境，有三要素是必不可少的：</p>
<p><b style="color:red">类（包括元类）、实例对象以及方法。</b></p>
<p>基于我们上文对于<code>Wrapper Object</code>的分析，我们可以构建特殊类型的Wrapper Object对这三个元素进行包装，具体就不说了，还是建议大家自行思考，基本上类似我上文分析<code>JSWrapperObject</code>的步骤。</p>
<p>除了上述三要素，我们还需要定义一个全局变量，<code>WZGloablObject</code>（大家可以理解为浏览器的window对象），用于拦截顶层的属性访问。</p>
<p><b style="color:red">按照这个设计，大家可以自行思考下，如果是你做，你会如何继续下面的工作，文章下周随着代码一起发布吧。</b></p>
<h4 id="Choose_调试">Choose 调试</h4><p>搞过逆向用过<strong>Cycript</strong>的朋友都知道，<strong>Cycript</strong>在调试时候有个非常方便的调试功能：<code>Choose</code>。该功能可以快速的帮助我们根据类名在堆上的对象全部查询返回。</p>
<p>这么实用的功能必须提供，我基本上直接照搬了Cycript的实现。代码很清晰，基本能够自解释其逻辑。核心基本上就是遍历每个<code>malloc_zone</code>，然后根据获取的<code>vmaddress_range</code>判断获取到的<strong>数据</strong>其类型是不是我们要的。</p>
<pre><code>// 遍历zone
<span class="keyword">for</span> (unsigned i = <span class="number">0</span>; i != size; ++i) {
    <span class="keyword">const</span> malloc_zone_t * zone = reinterpret_cast&lt;<span class="keyword">const</span> malloc_zone_t *&gt;(zones[i]);
    <span class="keyword">if</span> (zone == <span class="type">NULL</span> || zone-&gt;introspect == <span class="type">NULL</span>)
        <span class="keyword">continue</span>;
    zone-&gt;introspect-&gt;enumerator(mach_task_self(), &amp;choice, <span class="type">MALLOC_PTR_IN_USE_RANGE_TYPE</span>, zones[i], &amp;read_memory, &amp;choose_);
}

// 检查对象
<span class="keyword">for</span> (unsigned i = <span class="number">0</span>; i &lt; count; ++i) {
   vm_range_t &amp;<span class="type">range</span> = ranges[i];
   <span class="type">void</span> * data = reinterpret_cast&lt;<span class="type">void</span> *&gt;(<span class="type">range</span>.address);
   size_t size = <span class="type">range</span>.size;

   <span class="keyword">if</span> (size &lt; sizeof(<span class="type">ObjectStruct</span>))
       <span class="keyword">continue</span>;

   uintptr_t * pointers = reinterpret_cast&lt;uintptr_t *&gt;(data);
<span class="comment">#ifdef __arm64__</span>
   <span class="type">Class</span> isa = (__bridge <span class="type">Class</span>)((<span class="type">void</span> *)(pointers[<span class="number">0</span>] &amp; <span class="number">0x1fffffff8</span>));
<span class="comment">#else</span>
   <span class="type">Class</span> isa = reinterpret_cast&lt;<span class="type">Class</span>&gt;(pointers[<span class="number">0</span>]);
<span class="comment">#endif</span>
   std::<span class="type">set</span>&lt;<span class="type">Class</span>&gt;::const_iterator <span class="literal">result</span>(choice-&gt;query_.find(isa));
   <span class="keyword">if</span> (<span class="literal">result</span> == choice-&gt;query_.<span class="keyword">end</span>())
       <span class="keyword">continue</span>;

   size_t needed = class_getInstanceSize(*<span class="literal">result</span>);
   size_t boundary = <span class="number">496</span>;
<span class="comment">#ifdef __LP64__</span>
   boundary *= <span class="number">2</span>;
<span class="comment">#endif</span>
   <span class="keyword">if</span> ((needed &lt;= boundary &amp;&amp; (needed + <span class="number">15</span>) / <span class="number">16</span> * <span class="number">16</span> != size) || (needed &gt; boundary &amp;&amp; (needed + <span class="number">511</span>) / <span class="number">512</span> * <span class="number">512</span> != size))
       <span class="keyword">continue</span>;
   choice-&gt;result_.insert((__bridge id)(data));
}
</code></pre><p><b style="color:red">不过这里一大堆的511、512的数字构成的公式，实话说我不是很懂，有了解的大佬麻烦告知我一下。</b></p>
<h4 id="类型转换">类型转换</h4><p>首先我们需要记住，JavaScript的基础类型如下：</p>
<pre><code>-<span class="ruby"> 字符串、
</span>-<span class="ruby"> 数字、
</span>-<span class="ruby"> 布尔、
</span>-<span class="ruby"> 数组、
</span>-<span class="ruby"> 对象、
</span>-<span class="ruby"> <span class="constant">Null</span>、
</span>-<span class="ruby"> <span class="constant">Undefined</span></span>
</code></pre><p>所以我们只要根据对应的进行转换就可以，如下所示：</p>
<ul>
<li>JS字符串 &lt;-&gt; NSString</li>
<li>数字 &lt;-&gt; NSNumber</li>
<li>数组 &lt;-&gt; NSArray</li>
<li>Null &lt;-&gt; NSNull</li>
<li>Undefined &lt;-&gt; Void (仅当返回值的时候处理，否则直接抛出异常)</li>
</ul>
<blockquote>
<p>题外话，JavaScript里面没有什么整数和浮点数类型区分一说，所以我们可以无脑将其通过double的方式构建<code>NSNumber</code></p>
</blockquote>
<p>最后再来说下对对象类型的处理：</p>
<p>在JavaScript，任何对象都可以简单理解为包含了属性（方法）的一个包装体，如下所示:</p>
<pre><code>var a = {x:<span class="number">10</span>, y:<span class="number">100</span>};
</code></pre><p>因此，我们在对类型进行转换的时候，要特别注意以下几点：</p>
<ul>
<li>这个对象是不是我们刚刚上文提过的<b style="color:red">类、实例、方法</b>，是的话在其进入到Objective-C执行上下文的之前从JSWrapperObject中取出来。</li>
<li>这个对象是不是特定类型的结构体，是的话我们将其转换成结构体，比如<code>CGRect</code>之类的，是的话需要特别转换</li>
<li>是不是可以直接转换成特定类型的对象，比如<code>Date &lt;-&gt; NSDate</code>的转换。</li>
<li>最后，将其可遍历的属性和对应的属性值，转换到<code>NSDictionary</code>之中。</li>
<li><strong>当然，别忘了，需要注意递归处理</strong>。</li>
</ul>
<h4 id="Calling_Convention">Calling Convention</h4><p>关于<code>Calling Convention</code>，本文就不再赘述，有兴趣的读者可以参考我和同事一起写的知乎专栏<a href="https://zhuanlan.zhihu.com/c_142064221" target="_blank" rel="external">iOS调试进阶</a></p>
<p>简单来重新描述下就是：</p>
<p>一个函数的调用过程中，函数的参数既可以使用栈传递，也可以使用寄存器传递，参数压栈的顺序可以从左到右也可以从右到左，函数调用后参数从栈弹出这个工作可以由函数调用方完成，也可以由被调用方完成。如果函数的调用方和被调用方(函数本身)不遵循统一的约定，有这么多分歧这个函数调用就没法完成。这个双方必须遵守的统一约定就叫做调用惯例(Calling Convention)，调用惯例规定了参数的传递的顺序和方式，以及栈的维护方式。</p>
<p>由于业界已经有知名大佬写的<code>libffi</code>，所以我们不需要重复发明轮子，直接使用即可。如果真的要了解具体原理，也可以参考<a href="http://satanwoo.github.io/2017/06/29/Macho-2/">我的文章</a>，具体分析<code>objc_msgSend</code>的实现流程。</p>
<h3 id="其他">其他</h3><p>为了偷懒，我直接用JavaScript实现了这些的效果。其实理论上，如果我完整的实现编译前端，构建抽象语法树分析执行上下文，将Objective-C的代码转换成JavaScript，那么就能实现动态执行Objective-C代码了。(当然本质上还是障眼法)</p>
<blockquote>
<p>其实更快的方式，且不能保证完全正确的方式，就是调用一下<code>JSPatchConvertor</code>就好了，哈哈哈。</p>
</blockquote>
]]></content>
    <summary type="html">
    <![CDATA[<p>之前听说滴滴的<code>DynamicCocoa</code>是基于JavaScriptCore搞得，一直期待看到他们的真正实现，不过可能后来由于公司机密，应该不能再开源了。</p>
<p>借着最近开始研究JavaScriptCore的契机，我决定利用这一两天所学的Jav]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[谈谈ivar的直接访问]]></title>
    <link href="http://satanwoo.github.io/2018/02/04/iOS-iVar/"/>
    <id>http://satanwoo.github.io/2018/02/04/iOS-iVar/</id>
    <published>2018-02-04T15:14:33.000Z</published>
    <updated>2018-02-04T15:15:33.000Z</updated>
    <content type="html"><![CDATA[<blockquote>
<p>大水文一篇<br>大水文一篇<br>大水文一篇  </p>
</blockquote>
<h3 id="起因">起因</h3><p>最近对<code>Block</code>的一些实现细节又进行了一次复习，主要涉及的是捕捉变量的部分。有一个点我之前一直没太关注：对<code>ivar</code>变量的直接访问为啥会产生循环引用。</p>
<p>在我原先的理解中，之所以会产生循环引用，绝大多数场景都是由于<code>block</code>里面涉及了<strong>self</strong>关键字，比如<code>[self doSomething]</code>（同理，对于<code>property</code>的访问本质也是一堆方法），但是为啥对<code>ivar</code>的访问也会导致循环引用呢？</p>
<p>不是直接采用 <code>*(void *)address = xxx</code>这样的直接对编译好的静态地址赋值就好了？</p>
<blockquote>
<p>当时傻逼了，写完本文后想想就算编译成地址了，基地址从哪算还是要依赖<code>self</code>变量。</p>
</blockquote>
<h3 id="谈谈ivar的访问是啥形式">谈谈ivar的访问是啥形式</h3><p>还是回到runtime来看看吧，万变不离其宗，从<code>objc_class</code>结构体看起：</p>
<pre><code>struct objc<span class="number">_</span><span class="keyword">class</span> : objc<span class="number">_</span><span class="keyword">object</span> {
    <span class="comment">// Class ISA; // 8byte</span>
    Class superclass; <span class="comment">// 8byte</span>
    cache<span class="number">_</span>t cache;             <span class="comment">// formerly cache pointer and vtable // 4 + 4 + 8</span>
    <span class="keyword">class</span><span class="number">_</span>data<span class="number">_</span>bits<span class="number">_</span>t bits;    <span class="comment">// class_rw_t * plus custom rr/alloc flags</span>

    <span class="keyword">class</span><span class="number">_</span>rw<span class="number">_</span>t *data() { 
        <span class="keyword">return</span> bits.data();
    }
</code></pre><p>主要的运行时数据都是<code>class_rw_t</code>表示，继续瞅瞅：</p>
<pre><code><span class="keyword">struct</span> <span class="keyword">class_rw_t</span> {
    <span class="comment">// Be warned that Symbolication knows the layout of this structure.</span>
    <span class="keyword">uint32_t</span> flags;
    <span class="keyword">uint32_t</span> version;

    <span class="keyword">const</span> <span class="keyword">class_ro_t</span> *ro;
</code></pre><p>其中<code>class_ro_t</code>基本上是从二进制产物中读取的“副本”数据，我们看看：</p>
<pre><code><span class="keyword">struct</span> <span class="keyword">class_ro_t</span> {
    <span class="keyword">uint32_t</span> flags;
    <span class="keyword">uint32_t</span> instanceStart;
    <span class="keyword">uint32_t</span> instanceSize;
<span class="preprocessor">#<span class="keyword">ifdef</span> __LP64__</span>
    <span class="keyword">uint32_t</span> reserved;
<span class="preprocessor">#<span class="keyword">endif</span></span>

    <span class="keyword">const</span> <span class="keyword">uint8_t</span> * ivarLayout;

    <span class="keyword">const</span> <span class="keyword">char</span> * name;
    <span class="keyword">method_list_t</span> * baseMethodList;
    <span class="keyword">protocol_list_t</span> * baseProtocols;
    <span class="keyword">const</span> <span class="keyword">ivar_list_t</span> * ivars;
</code></pre><p>看起来<code>ivar_list_t</code>就是存放<code>ivar</code>的列表，他的实现是一个模版类，看看具体结构表示：</p>
<pre><code><span class="title">struct</span> entsize_list_tt {
    <span class="title">uint32_t</span> entsizeAndFlags;
    <span class="title">uint32_t</span> count;
    <span class="title">Element</span> first;
</code></pre><p>具体对应<code>ivar</code>，替换掉模版就是：</p>
<pre><code><span class="keyword">struct</span> <span class="keyword">ivar_list_t</span> {
    <span class="keyword">uint32_t</span> entsizeAndFlags;
    <span class="keyword">uint32_t</span> count;
    <span class="keyword">ivar_t</span> first;
</code></pre><p>其中，<code>ivar_t</code>表征的就是我们每个<code>ivar</code>，</p>
<pre><code><span class="keyword">int32_t</span> *offset;
<span class="keyword">const</span> <span class="keyword">char</span> *name;
<span class="keyword">const</span> <span class="keyword">char</span> *type;
</code></pre><p>嗯，从这里开始<code>offset</code>是用一个<code>int32_t *</code>的指针来表示，就开始有意思了。<strong>这里我们先暂时忽略</strong></p>
<p>看起来，如果按照这种方式访问<code>ivar</code>，整个流程要经过好多次指针转移：</p>
<pre><code>class -&gt; class<span class="class">.rw_data</span> -&gt; class<span class="class">.rw_data</span><span class="class">.ro_data</span> -&gt; class<span class="class">.rw_data</span><span class="class">.ro_data</span><span class="class">.ivars</span> -&gt; 
-&gt; class<span class="class">.rw_data</span><span class="class">.ro_data</span><span class="class">.ivars</span><span class="class">.first</span>[n]
</code></pre><p>如果是这样，大量使用<code>ivar</code>肯定很耗时。那么，对于<code>ivar</code>的访问究竟是怎么玩的呢？</p>
<h3 id="全局变量">全局变量</h3><p>我们用如下这个非常简单的例子来瞅瞅：</p>
<pre><code><span class="keyword">typedef</span> <span class="keyword">void</span>(^MyBlock)(<span class="keyword">void</span>);

<span class="class"><span class="keyword">@interface</span> <span class="title">MyObject</span> : <span class="title">NSObject</span></span>
<span class="keyword">@property</span> (<span class="keyword">nonatomic</span>) <span class="built_in">NSUInteger</span> haha;
<span class="keyword">@property</span> (<span class="keyword">nonatomic</span>, <span class="keyword">copy</span>) MyBlock block;

- (<span class="keyword">void</span>)inits;

<span class="keyword">@end</span>

<span class="class"><span class="keyword">@implementation</span> <span class="title">MyObject</span></span>
- (<span class="keyword">void</span>)inits
{
    <span class="keyword">self</span><span class="variable">.block</span> = ^{
        _haha = <span class="number">5</span>;
    };
}
<span class="keyword">@end</span>

<span class="keyword">int</span> main(<span class="keyword">int</span> argc, <span class="keyword">char</span> * argv[]) {
    MyObject *object = [MyObject new];
    [object inits];
}
</code></pre><p>重写一把，基本转化成如下的形式：</p>
<pre><code><span class="keyword">typedef</span> <span class="keyword">void</span>(*MyBlock)(<span class="keyword">void</span>);


<span class="preprocessor">#ifndef _REWRITER_typedef_MyObject</span>
<span class="preprocessor">#define _REWRITER_typedef_MyObject</span>
<span class="keyword">typedef</span> <span class="keyword">struct</span> objc_object MyObject;
<span class="keyword">typedef</span> <span class="keyword">struct</span> {} _objc_exc_MyObject;
<span class="preprocessor">#endif</span>

<span class="comment">// 注意点1!!!!!!!!!!!!!!!!!!!!</span>
<span class="keyword">extern</span> <span class="string">"C"</span> <span class="keyword">unsigned</span> <span class="keyword">long</span> OBJC_IVAR_$_MyObject$_haha;
<span class="keyword">extern</span> <span class="string">"C"</span> <span class="keyword">unsigned</span> <span class="keyword">long</span> OBJC_IVAR_$_MyObject$_block;
<span class="keyword">struct</span> MyObject_I<span class="built_in">MPL</span> {
    <span class="keyword">struct</span> <span class="built_in">NSObject_IMPL</span> <span class="built_in">NSObject_IVARS</span>;
    <span class="built_in">NSUInteger</span> _haha;
    MyBlock _block;
};

<span class="comment">// @property (nonatomic) NSUInteger haha;</span>
<span class="comment">// @property (nonatomic, copy) MyBlock block;</span>

<span class="comment">// - (void)inits;</span>

<span class="comment">/* @end */</span>


<span class="comment">// @implementation MyObject</span>

<span class="keyword">struct</span> __MyObject__inits_block_impl_0 {
  <span class="keyword">struct</span> __block_impl impl;
  <span class="keyword">struct</span> __MyObject__inits_block_desc_0* Desc;
  MyObject *<span class="keyword">self</span>;

  <span class="comment">// 注意点2！！！！！！！！！！！！！！！</span>
  __MyObject__inits_block_impl_0(<span class="keyword">void</span> *fp, <span class="keyword">struct</span> __MyObject__inits_block_desc_0 *desc, MyObject *_<span class="keyword">self</span>, <span class="keyword">int</span> flags=<span class="number">0</span>) : <span class="keyword">self</span>(_<span class="keyword">self</span>) {
    impl<span class="variable">.isa</span> = &amp;_<span class="built_in">NSConcreteStackBlock</span>;
    impl<span class="variable">.Flags</span> = flags;
    impl<span class="variable">.FuncPtr</span> = fp;
    Desc = desc;
  }
};

／／ 注意点<span class="number">3</span>！！！！！！！！！！！！
<span class="keyword">static</span> <span class="keyword">void</span> __MyObject__inits_block_func_0(<span class="keyword">struct</span> __MyObject__inits_block_impl_0 *__cself) {
  MyObject *<span class="keyword">self</span> = __cself-&gt;<span class="keyword">self</span>; <span class="comment">// bound by copy</span>

        (*(<span class="built_in">NSUInteger</span> *)((<span class="keyword">char</span> *)<span class="keyword">self</span> + OBJC_IVAR_$_MyObject$_haha)) = <span class="number">5</span>;
    }
<span class="keyword">static</span> <span class="keyword">void</span> __MyObject__inits_block_copy_0(<span class="keyword">struct</span> __MyObject__inits_block_impl_0*dst, <span class="keyword">struct</span> __MyObject__inits_block_impl_0*src) {_Block_object_assign((<span class="keyword">void</span>*)&amp;dst-&gt;<span class="keyword">self</span>, (<span class="keyword">void</span>*)src-&gt;<span class="keyword">self</span>, <span class="number">3</span><span class="comment">/*BLOCK_FIELD_IS_OBJECT*/</span>);}

<span class="keyword">static</span> <span class="keyword">void</span> __MyObject__inits_block_dispose_0(<span class="keyword">struct</span> __MyObject__inits_block_impl_0*src) {_Block_object_dispose((<span class="keyword">void</span>*)src-&gt;<span class="keyword">self</span>, <span class="number">3</span><span class="comment">/*BLOCK_FIELD_IS_OBJECT*/</span>);}

<span class="keyword">static</span> <span class="keyword">struct</span> __MyObject__inits_block_desc_0 {
  size_t reserved;
  size_t Block_size;
  <span class="keyword">void</span> (*<span class="keyword">copy</span>)(<span class="keyword">struct</span> __MyObject__inits_block_impl_0*, <span class="keyword">struct</span> __MyObject__inits_block_impl_0*);
  <span class="keyword">void</span> (*dispose)(<span class="keyword">struct</span> __MyObject__inits_block_impl_0*);
} __MyObject__inits_block_desc_0_DATA = { <span class="number">0</span>, <span class="keyword">sizeof</span>(<span class="keyword">struct</span> __MyObject__inits_block_impl_0), __MyObject__inits_block_copy_0, __MyObject__inits_block_dispose_0};

<span class="keyword">static</span> <span class="keyword">void</span> _I_MyObject_inits(MyObject * <span class="keyword">self</span>, SEL _cmd) {
    ((<span class="keyword">void</span> (*)(<span class="keyword">id</span>, SEL, MyBlock))(<span class="keyword">void</span> *)objc_msgSend)((<span class="keyword">id</span>)<span class="keyword">self</span>, sel_registerName(<span class="string">"setBlock:"</span>), ((<span class="keyword">void</span> (*)())&amp;__MyObject__inits_block_impl_0((<span class="keyword">void</span> *)__MyObject__inits_block_func_0, &amp;__MyObject__inits_block_desc_0_DATA, <span class="keyword">self</span>, <span class="number">570425344</span>)));
}

<span class="keyword">static</span> <span class="built_in">NSUInteger</span> _I_MyObject_haha(MyObject * <span class="keyword">self</span>, SEL _cmd) { <span class="keyword">return</span> (*(<span class="built_in">NSUInteger</span> *)((<span class="keyword">char</span> *)<span class="keyword">self</span> + OBJC_IVAR_$_MyObject$_haha)); }
<span class="keyword">static</span> <span class="keyword">void</span> _I_MyObject_setHaha_(MyObject * <span class="keyword">self</span>, SEL _cmd, <span class="built_in">NSUInteger</span> haha) { (*(<span class="built_in">NSUInteger</span> *)((<span class="keyword">char</span> *)<span class="keyword">self</span> + OBJC_IVAR_$_MyObject$_haha)) = haha; }

<span class="keyword">static</span> <span class="keyword">void</span>(* _I_MyObject_block(MyObject * <span class="keyword">self</span>, SEL _cmd) )(){ <span class="keyword">return</span> (*(MyBlock *)((<span class="keyword">char</span> *)<span class="keyword">self</span> + OBJC_IVAR_$_MyObject$_block)); }
<span class="keyword">extern</span> <span class="string">"C"</span> __declspec(dllimport) <span class="keyword">void</span> objc_setProperty (<span class="keyword">id</span>, SEL, <span class="keyword">long</span>, <span class="keyword">id</span>, <span class="keyword">bool</span>, <span class="keyword">bool</span>);

<span class="keyword">static</span> <span class="keyword">void</span> _I_MyObject_setBlock_(MyObject * <span class="keyword">self</span>, SEL _cmd, MyBlock block) { objc_setProperty (<span class="keyword">self</span>, _cmd, __OFFSETOFIVAR__(<span class="keyword">struct</span> MyObject, _block), (<span class="keyword">id</span>)block, <span class="number">0</span>, <span class="number">1</span>); }
<span class="comment">// @end</span>

<span class="keyword">int</span> main(<span class="keyword">int</span> argc, <span class="keyword">char</span> * argv[]) {
    MyObject *object = ((MyObject *(*)(<span class="keyword">id</span>, SEL))(<span class="keyword">void</span> *)objc_msgSend)((<span class="keyword">id</span>)objc_getClass(<span class="string">"MyObject"</span>), sel_registerName(<span class="string">"new"</span>));
    ((<span class="keyword">void</span> (*)(<span class="keyword">id</span>, SEL))(<span class="keyword">void</span> *)objc_msgSend)((<span class="keyword">id</span>)object, sel_registerName(<span class="string">"inits"</span>));
}
</code></pre><p>一大堆东西，没啥特别的地方，我们只要关注几个地方：</p>
<ul>
<li><p>对于每个<code>ivar</code>，都有对应的全局变量</p>
<pre><code><span class="keyword">extern</span> <span class="string">"C"</span> <span class="keyword">unsigned</span> <span class="keyword">long</span> OBJC_IVAR_$_MyObject$_haha;
<span class="keyword">extern</span> <span class="string">"C"</span> <span class="keyword">unsigned</span> <span class="keyword">long</span> OBJC_IVAR_$_MyObject$_block;
</code></pre></li>
<li><p>block_invoke对应的实现是通过对象自身作为基地址，全局变量作为偏移去对<code>haha</code>这个<code>ivar</code>进行赋值。</p>
<pre><code><span class="keyword">static</span> <span class="keyword">void</span> __MyObject__inits_block_func_0(<span class="keyword">struct</span> __MyObject__inits_block_impl_0 *__cself) {
  MyObject *<span class="keyword">self</span> = __cself-&gt;<span class="keyword">self</span>; <span class="comment">// bound by copy</span>

        (*(<span class="built_in">NSUInteger</span> *)((<span class="keyword">char</span> *)<span class="keyword">self</span> + OBJC_IVAR_$_MyObject$_haha)) = <span class="number">5</span>;
    }
</code></pre></li>
<li><p>block的构造函数，确实捕捉了<code>self</code></p>
<pre><code>__MyObject__inits_block_impl_0(void *fp, <span class="keyword">struct</span> __MyObject__inits_block_desc_0 *desc, MyObject *_<span class="keyword">self</span>, <span class="keyword">int</span> flags=<span class="number">0</span>) : <span class="keyword">self</span>(_<span class="keyword">self</span>) {
    <span class="keyword">impl</span>.isa = &amp;_NSConcreteStackBlock;
    <span class="keyword">impl</span>.Flags = flags;
    <span class="keyword">impl</span>.FuncPtr = fp;
    Desc = desc;
  }
</code></pre></li>
</ul>
<p>由于全局变量的地址是在编译期就确定了，所以这里也就不难解释<code>ivar_t</code>里面为什么要保存<code>int32_t *</code>，保存的就是对应的全局变量地址。而全局变量的值则是对应的动态偏移。</p>
<h3 id="结语">结语</h3><p>水完了，其实虽然runtime的结构体设计的比较绕，但是最后对于变量的访问和很多静态语言设计一样，也不会损失很多性能。</p>
<p><b style="color:red">从另外一个角度看，如果声明了巨多的<code>ivar</code>，看来也会对包大小产生不可忽视的影响。</b></p>
]]></content>
    <summary type="html">
    <![CDATA[<blockquote>
<p>大水文一篇<br>大水文一篇<br>大水文一篇  </p>
</blockquote>
<h3 id="起因">起因</h3><p>最近对<code>Block</code>的一些实现细节又进行了一次复习，主要涉及的是捕捉变量的部分。有一个点我之前]]>
    </summary>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
  <entry>
    <title><![CDATA[XNU之四：iOS虚拟内存限制（一）]]></title>
    <link href="http://satanwoo.github.io/2018/01/14/iOS-virtual/"/>
    <id>http://satanwoo.github.io/2018/01/14/iOS-virtual/</id>
    <published>2018-01-14T13:37:12.000Z</published>
    <updated>2018-01-14T13:51:47.000Z</updated>
    <content type="html"><![CDATA[<p>XNU之二和之三两篇由于涉及的量过大，就不发了，当然本文我也删除了一定的内容，哈哈哈。</p>
<p><b style="color:red">欢迎加入我们<strong>手淘／天猫的架构组</strong>来内网阅读</b></p>
<p>提起iOS的内存管理，大多数人第一反应想到的都是引用计数、<code>ARC</code>、<code>AutoreleasePool</code>之类的词眼。但是事实上，这只是iOS内存管理的冰山一角，今天就让我们来探究水面之下的内存管理。</p>
<h3 id="虚拟内存的限制">虚拟内存的限制</h3><p>我之所以想研究这个议题，主要还是之前有个UC同事问了我一个问题：</p>
<blockquote>
<p>“现在绝大多数都是ARM64的设备，即64位寻址空间，而且iOS上的通过malloc申请的内存只是虚拟内存，还不是真正物理内存，为什么分配了两三G就会失败了。”</p>
</blockquote>
<p>按照他的想法，我在我的iPhone上测试了如下代码：</p>
<pre><code><span class="keyword">void</span> *buffer = <span class="built_in">malloc</span>(<span class="number">2000</span> * <span class="number">1024</span> * <span class="number">1024</span>);
</code></pre><p>果不其然，报出了如下错误：</p>
<pre><code>malloc: <span class="keyword">*</span><span class="keyword">*</span><span class="keyword">*</span> mach_vm_map(size=2097152000) failed (error code=3)
<span class="keyword">*</span><span class="keyword">*</span><span class="keyword">*</span> error: can't allocate region
</code></pre><p>次奥，我xxxxx分配一个<strong>2G<b style="color:red">虚拟</b>内存</strong>就懵逼？</p>
<p>还是赶紧翻翻看源码，由于我分配的是一个超大的内存，所以按照<code>nano_zone</code>和<code>scalable_zone</code>的设计理念，</p>
<ul>
<li>小于256byte的走<code>nano_zone</code>进行分配。</li>
<li>剩下的我记不得了</li>
</ul>
<p>赶紧翻翻<code>scalable_zone</code>看看源码，如下所示：</p>
<pre><code>void *    szone_malloc_should_clear<span class="list">(<span class="keyword">szone_t</span> <span class="variable">*szone, size_t size, boolean_t cleared_requested)
{
    void *</span>ptr<span class="comment">;</span>
    msize_t msize<span class="comment">;</span>

    if <span class="list">(<span class="keyword">size</span> &lt;= SMALL_THRESHOLD)</span> {
        // tiny size: &lt;1024 bytes <span class="list">(<span class="number">64</span>-bit)</span>, &lt;512 bytes <span class="list">(<span class="number">32</span>-bit)</span>
        // think tiny
        msize = TINY_MSIZE_FOR_BYTES<span class="list">(<span class="keyword">size</span> + TINY_QUANTUM - <span class="number">1</span>)</span><span class="comment">;</span>
        if <span class="list">(!msize)</span> {
            msize = <span class="number">1</span><span class="comment">;</span>
        }
        ptr = tiny_malloc_should_clear<span class="list">(<span class="keyword">szone</span>, msize, cleared_requested)</span><span class="comment">;</span>
    } else if <span class="list">(<span class="keyword">size</span> &lt;= szone-&gt;large_threshold)</span> {
        // small size: &lt;15k <span class="list">(<span class="keyword">&lt;1GB</span> machines)</span>, &lt;127k <span class="list">(<span class="keyword">&gt;1GB</span> machines)</span>
        // think small
        msize = SMALL_MSIZE_FOR_BYTES<span class="list">(<span class="keyword">size</span> + SMALL_QUANTUM - <span class="number">1</span>)</span><span class="comment">;</span>
        if <span class="list">(!msize)</span> {
            msize = <span class="number">1</span><span class="comment">;</span>
        }
        ptr = small_malloc_should_clear<span class="list">(<span class="keyword">szone</span>, msize, cleared_requested)</span><span class="comment">;</span>
    } else {
        // large: all other allocations
        size_t num_kernel_pages = round_page_quanta<span class="list">(<span class="keyword">size</span>)</span> &gt;&gt; vm_page_quanta_shift<span class="comment">;</span>
        if <span class="list">(<span class="keyword">num_kernel_pages</span> == <span class="number">0</span>)</span> { /* Overflowed <span class="variable">*/
            ptr = 0;
        } else {
            ptr = large_malloc(szone, num_kernel_pages, 0, cleared_requested);
        }
    }
#if DEBUG_MALLOC
    if (LOG(szone, ptr)) {
        malloc_printf("szone_malloc returned %p\n", ptr);
    }
#endif
    /*</span>
     <span class="variable">* If requested, scribble on allocated memory.
     *</span>/
    if <span class="list">(<span class="list">(<span class="keyword">szone-&gt;debug_flags</span> &amp; MALLOC_DO_SCRIBBLE)</span> <span class="keyword">&amp;&amp;</span> ptr <span class="keyword">&amp;&amp;</span> !cleared_requested <span class="keyword">&amp;&amp;</span> size)</span> {
        memset<span class="list">(<span class="keyword">ptr</span>, SCRIBBLE_BYTE, szone_size<span class="list">(<span class="keyword">szone</span>, ptr)</span>)</span><span class="comment">;</span>
    }

    return ptr<span class="comment">;</span>
}</span>
</code></pre><ul>
<li>小于1k的走<code>tiny_malloc</code></li>
<li>小于15k或者127k的走<code>small_malloc</code>（视具体不同的设备内存上限不同）</li>
<li>剩下的走<code>large_malloc</code>。</li>
</ul>
<p>OK，由于我们分配的非常大，我们可以确定我们的逻辑是落入<code>large_malloc</code>中。需要特别注意的是：<code>large_malloc</code>分配内存的基本单位是一页大小，而对于其他的几种分配方式，则不是必须按照页大小进行分配。</p>
<p>由于<code>large_malloc</code>这个函数本身并没有特殊需要注意的地方，我们直接关注其真正分配内存的地方，即<code>allocate_pages</code>，如下所示：</p>
<pre><code>vm_addr = vm_page_quanta_size;
kr = mach_vm_map(mach_task_self(), &amp;vm_addr, allocation_size, allocation_mask, alloc_flags, MEMORY_OBJECT_NULL, <span class="number">0</span>, FALSE,
            VM_PROT_DEFAULT, VM_PROT_ALL, VM_INHERIT_DEFAULT);
<span class="keyword">if</span> (kr) {
    szone_error(szone, <span class="number">0</span>, <span class="string">"can't allocate region"</span>, <span class="literal">NULL</span>, <span class="string">"*** mach_vm_map(size=%lu) failed (error code=%d)\n"</span>, size, kr);
    <span class="keyword">return</span> <span class="literal">NULL</span>;
}
addr = (<span class="keyword">uintptr_t</span>)vm_addr;
</code></pre><p>从上我们不难看出，如果分配失败，就是提示报错。而<code>mach_vm_map</code>则是整个内存的分配核心。</p>
<p>可能你一开始看到这个<code>mach_vm_map</code>会比较懵逼，可以先看下我下面这张图：</p>
<p><img src="https://github.com/SatanWoo/BeeHive/blob/master/virtual.png?raw=true" alt="屏幕快照 2018-01-03 上午10.55.41.png"> </p>
<p>OK，是不是有冒出很多名词。没关系，你其实只要记住两点：<code>vm_map</code>代表就是一个进程运行时候涉及的虚拟内存，<code>pmap</code>代表的就是和具体硬件架构相关的物理内存。（这里我们暂时先不考虑<strong>submap</strong>这种情况）。</p>
<p>好，<code>vm_map</code>本身是进程（或者从Mach内核的角度看是task的地址分布图）。这个地址分布图维护着一个<strong><b style="color:red">双向列表</b></strong>，列表的每一项都是<code>vm_entry_t</code>，代表着虚拟地址上连续的一个范围。而<code>pmap</code>这个结构体代表了个硬件相关的内存转换：即利用<code>pmap</code>这个结构体来描述抽象的物理地址访问和使用。</p>
<h3 id="进程（任务）的创建">进程（任务）的创建</h3><p>在继续深入我们的话题之前，我们还需要具备一个额外的知识，就是iOS上的进程创建和加载执行Mach-O过程。</p>
<p>类UNIX系统本质上是没法无缘无故创建出一个全新的进程的，基本上必须要通过<code>fork</code>的形式来创建。(这块不太熟悉，有错请指正)。</p>
<p>在XNU的实现里，不论用户态调用<code>posix</code>相关API还是别的API，落入到内核里面都走的是<code>fork_create_child</code>函数来创建属于Mach内核的任务（task）。其实现如下：</p>
<pre><code>thread_t
fork_create_child(task_t parent_task, coalition_t *parent_coalitions, proc_t child_proc, <span class="type">int</span> inherit_memory, <span class="type">int</span> is64bit, <span class="type">int</span> in_exec)
{
    thread_t    child_thread = <span class="type">NULL</span>;
    task_t        child_task;
    kern_return_t    <span class="literal">result</span>;

    /* <span class="type">Create</span> a new task <span class="keyword">for</span> the child process */
    <span class="literal">result</span> = task_create_internal(parent_task,
                    parent_coalitions,
                    inherit_memory,
                    is64bit,
                    <span class="type">TF_LRETURNWAIT</span> | <span class="type">TF_LRETURNWAITER</span>,         /* <span class="type">All</span> created threads will wait <span class="keyword">in</span> task_wait_to_return */
                    in_exec ? <span class="type">TPF_EXEC_COPY</span> : <span class="type">TPF_NONE</span>,   /* <span class="type">Mark</span> the task exec copy <span class="keyword">if</span> <span class="keyword">in</span> execve */
                    &amp;child_task);

    <span class="keyword">if</span> (<span class="literal">result</span> != <span class="type">KERN_SUCCESS</span>) {
        printf(<span class="string">"%s: task_create_internal failed.  Code: %d\n"</span>,
            __func__, <span class="literal">result</span>);
        goto bad;
    }

    <span class="keyword">if</span> (!in_exec) {
        /*
         * <span class="type">Set</span> the child process task to the new task <span class="keyword">if</span> <span class="keyword">not</span> <span class="keyword">in</span> exec,
         * will <span class="type">set</span> the task <span class="keyword">for</span> exec <span class="keyword">case</span> <span class="keyword">in</span> proc_exec_switch_task after image activation.
         */

         // 注意点：
        child_proc-&gt;task = child_task;
    }
</code></pre><ul>
<li>这个函数本身实现并没什么出彩的，我们唯一要注意的就是<strong>Mach内核里面没有进程的概念，只有任务</strong>，进程是属于BSD之上的抽象。它们之间的联系就是通过指针建立，<code>child_proc-&gt;task = child_task。</code></li>
</ul>
<p><code>fork</code>出来的进程更像是一个空壳，我们需要利用这个进程壳去执行可执行文件变成我们通常意义上理解的<code>程序进程</code>。</p>
<p>从XNU上来看，可执行的文件种类如下：</p>
<pre><code>{ <span class="built_in">exec</span>_mach_imgact,        <span class="string">"Mach-o Binary"</span> },
{ <span class="built_in">exec</span>_fat_imgact,        <span class="string">"Fat Binary"</span> },
{ <span class="built_in">exec</span>_shell_imgact,    <span class="string">"Interpreter Script"</span> }
</code></pre><p>这里咱们先只看最常用的<code>Mach-O</code>文件：</p>
<pre><code>exec_mach_imgact(struct image_params *imgp)
{
    ... 省略无数

    <span class="keyword">if</span> ((mach_header-&gt;magic == MH_CIGAM) ||
        (mach_header-&gt;magic == MH_CIGAM_64)) {
        error = EBADARCH;
        <span class="keyword">goto</span> bad;
    }

    <span class="keyword">if</span> ((mach_header-&gt;magic != MH_MAGIC) &amp;&amp;
        (mach_header-&gt;magic != MH_MAGIC_64)) {
        error = -<span class="number">1</span>;
        <span class="keyword">goto</span> bad;
    }

    <span class="keyword">if</span> (mach_header-&gt;filetype != MH_EXECUTE) {
        error = -<span class="number">1</span>;
        <span class="keyword">goto</span> bad;
    }

    <span class="keyword">if</span> (imgp-&gt;ip_origcputype != <span class="number">0</span>) {
        <span class="comment">/* Fat header previously had an idea about this thin file */</span>
        <span class="keyword">if</span> (imgp-&gt;ip_origcputype != mach_header-&gt;cputype ||
            imgp-&gt;ip_origcpusubtype != mach_header-&gt;cpusubtype) {
            error = EBADARCH;
            <span class="keyword">goto</span> bad;
        }
    } <span class="keyword">else</span> {
        imgp-&gt;ip_origcputype = mach_header-&gt;cputype;
        imgp-&gt;ip_origcpusubtype = mach_header-&gt;cpusubtype;
    }

    task = current_task();
    thread = current_thread();
    uthread = get_bsdthread_info(thread);

    <span class="keyword">if</span> ((mach_header-&gt;cputype &amp; CPU_ARCH_ABI64) == CPU_ARCH_ABI64)
        imgp-&gt;ip_flags |= IMGPF_IS_64BIT;

    <span class="comment">/* If posix_spawn binprefs exist, respect those prefs. */</span>
    psa = (struct _posix_spawnattr *) imgp-&gt;ip_px_sa;
    <span class="keyword">if</span> (psa != <span class="keyword">NULL</span> &amp;&amp; psa-&gt;psa_binprefs[<span class="number">0</span>] != <span class="number">0</span>) {
        <span class="keyword">int</span> pr = <span class="number">0</span>;
        <span class="keyword">for</span> (pr = <span class="number">0</span>; pr &lt; NBINPREFS; pr++) {
            cpu_type_t pref = psa-&gt;psa_binprefs[pr];
            <span class="keyword">if</span> (pref == <span class="number">0</span>) {
                <span class="comment">/* No suitable arch in the pref list */</span>
                error = EBADARCH;
                <span class="keyword">goto</span> bad;
            }

            <span class="keyword">if</span> (pref == CPU_TYPE_ANY) {
                <span class="comment">/* Jump to regular grading */</span>
                <span class="keyword">goto</span> grade;
            }

            <span class="keyword">if</span> (pref == imgp-&gt;ip_origcputype) {
                <span class="comment">/* We have a match! */</span>
                <span class="keyword">goto</span> grade;
            }
        }
        error = EBADARCH;
        <span class="keyword">goto</span> bad;
    }
grade:
    <span class="keyword">if</span> (!grade_binary(imgp-&gt;ip_origcputype, imgp-&gt;ip_origcpusubtype &amp; ~CPU_SUBTYPE_MASK)) {
        error = EBADARCH;
        <span class="keyword">goto</span> bad;
    }

    <span class="comment">/* Copy in arguments/environment from the old process */</span>
    error = exec_extract_strings(imgp);
    <span class="keyword">if</span> (error)
        <span class="keyword">goto</span> bad;

    AUDIT_ARG(argv, imgp-&gt;ip_startargv, imgp-&gt;ip_argc, 
        imgp-&gt;ip_endargv - imgp-&gt;ip_startargv);
    AUDIT_ARG(envv, imgp-&gt;ip_endargv, imgp-&gt;ip_envc,
        imgp-&gt;ip_endenvv - imgp-&gt;ip_endargv);

    <span class="comment">/* reset local idea of thread, uthread, task */</span>
    thread = imgp-&gt;ip_new_thread;
    uthread = get_bsdthread_info(thread);
    task = new_task = get_threadtask(thread);

    <span class="comment">// 注意点：</span>
    lret = load_machfile(imgp, mach_header, thread, &amp;map, &amp;load_result);

    ... 省略无数
</code></pre><p>整个代码都没啥用，就是做些检查，分配个进程壳，然后通过<code>load_machfile</code>加载真正的二进制文件。</p>
<pre><code>load_return_t
load_machfile(
    struct image_params    *imgp,
    struct mach_header    *header,
    thread_t         thread,
    vm_map_t         *mapp,
    load_result_t        *<span class="literal">result</span>
)
{
    ... 省略一大堆

    <span class="keyword">if</span> (macho_size &gt; file_size) {
        <span class="keyword">return</span>(<span class="type">LOAD_BADMACHO</span>);
    }

    <span class="literal">result</span>-&gt;is64bit = ((imgp-&gt;ip_flags &amp; <span class="type">IMGPF_IS_64BIT</span>) == <span class="type">IMGPF_IS_64BIT</span>);

    task_t ledger_task;
    <span class="keyword">if</span> (imgp-&gt;ip_new_thread) {
        ledger_task = get_threadtask(imgp-&gt;ip_new_thread);
    } <span class="keyword">else</span> {
        ledger_task = task;
    }

    // 注意点<span class="number">1</span>
    pmap = pmap_create(get_task_ledger(ledger_task),
               (vm_map_size_t) <span class="number">0</span>,
               <span class="literal">result</span>-&gt;is64bit);

    // 注意点<span class="number">2</span>
    map = vm_map_create(pmap,
            <span class="number">0</span>,
            vm_compute_max_offset(<span class="literal">result</span>-&gt;is64bit),
            <span class="type">TRUE</span>);

<span class="comment">#if defined(__arm64__)</span>
    // 注意点三
    <span class="keyword">if</span> (<span class="literal">result</span>-&gt;is64bit) {
        /* enforce <span class="number">16</span>KB alignment <span class="keyword">of</span> <span class="type">VM</span> map entries */
        vm_map_set_page_shift(map, <span class="type">SIXTEENK_PAGE_SHIFT</span>);
    } <span class="keyword">else</span> {
        vm_map_set_page_shift(map, page_shift_user32);
    }
</code></pre><ul>
<li>利用<code>pmap_create</code>创建硬件相关的物理内存抽象。</li>
<li>利用<code>vmap_create</code>创建虚拟内存的地址图。</li>
<li>ARM64下的页是16k一个虚拟页对应一个物理页。</li>
</ul>
<p>别的没啥关注，我们重点关注<code>vm_map_create</code><b style="color:red"><code>0</code>和<code>vm_compute_max_offset(result-&gt;is64bit)</code></b>。</p>
<p><b style="color:red">因为这个代表了这个任务分配的虚拟地址上下限！</b>这个函数的实现如下：</p>
<pre><code><span class="tag">vm_map_offset_t</span>
<span class="tag">vm_compute_max_offset</span>(boolean_t is64)
{
<span class="id">#if</span> <span class="tag">defined</span>(__arm__) || <span class="tag">defined</span>(__arm64__)
    <span class="tag">return</span> (<span class="function">pmap_max_offset</span>(is64, ARM_PMAP_MAX_OFFSET_DEVICE));
<span class="id">#else</span>
    <span class="tag">return</span> (is64 ? (vm_map_offset_t)<span class="attribute">MACH_VM_MAX_ADDRESS </span>: (vm_map_offset_t)VM_MAX_ADDRESS);
<span class="id">#endif</span>
}
</code></pre><p>继续往下看：</p>
<pre><code><span class="keyword">vm_map_offset_t</span> pmap_max_offset(
    <span class="keyword">boolean_t</span>    is64 __unused,
    <span class="keyword">unsigned</span> <span class="keyword">int</span>    option)
{
    <span class="keyword">vm_map_offset_t</span>    max_offset_ret = <span class="number">0</span>;

<span class="preprocessor">#<span class="keyword">if</span> defined(__arm64__)</span>
    assert (is64);
    <span class="keyword">vm_map_offset_t</span> min_max_offset = SHARED_REGION_BASE_ARM64 + SHARED_REGION_SIZE_ARM64 + <span class="number">0x20000000</span>; <span class="comment">// end of shared region + 512MB for various purposes</span>
    <span class="keyword">if</span> (option == ARM_PMAP_MAX_OFFSET_DEFAULT) {
        max_offset_ret = arm64_pmap_max_offset_default;
    } <span class="keyword">else</span> <span class="keyword">if</span> (option == ARM_PMAP_MAX_OFFSET_MIN) {
        max_offset_ret = min_max_offset;
    } <span class="keyword">else</span> <span class="keyword">if</span> (option == ARM_PMAP_MAX_OFFSET_MAX) {
        max_offset_ret = MACH_VM_MAX_ADDRESS;
    } <span class="keyword">else</span> <span class="keyword">if</span> (option == ARM_PMAP_MAX_OFFSET_DEVICE) {
        <span class="keyword">if</span> (arm64_pmap_max_offset_default) {
            max_offset_ret = arm64_pmap_max_offset_default;
        } <span class="keyword">else</span> <span class="keyword">if</span> (max_mem &gt; <span class="number">0xC0000000</span>) {
            max_offset_ret = <span class="number">0x0000000318000000</span>ULL;     <span class="comment">// Max offset is 12.375GB for devices with &gt; 3GB of memory</span>
        } <span class="keyword">else</span> <span class="keyword">if</span> (max_mem &gt; <span class="number">0x40000000</span>) {
            max_offset_ret = <span class="number">0x0000000218000000</span>ULL;     <span class="comment">// Max offset is 8.375GB for devices with &gt; 1GB and &lt;= 3GB of memory</span>
        } <span class="keyword">else</span> {
            max_offset_ret = min_max_offset;
        }
    } <span class="keyword">else</span> <span class="keyword">if</span> (option == ARM_PMAP_MAX_OFFSET_JUMBO) {
        max_offset_ret = <span class="number">0x0000000518000000</span>ULL;     <span class="comment">// Max offset is 20.375GB for pmaps with special "jumbo" blessing</span>
    } <span class="keyword">else</span> {
        panic(<span class="string">"pmap_max_offset illegal option 0x%x\n"</span>, option);
    }

    assert(max_offset_ret &gt;= min_max_offset);
    <span class="keyword">return</span> max_offset_ret;
</code></pre><p>其实关键点就是这里的代码：</p>
<pre><code><span class="keyword">if</span> (max_mem &gt; <span class="number">0xC0000000</span>) {
    max_offset_ret = <span class="number">0x0000000318000000</span>ULL;     <span class="regexp">//</span> <span class="constant">Max</span> offset is <span class="number">12.375</span>GB <span class="keyword">for</span> devices <span class="keyword">with</span> &gt; <span class="number">3</span>GB <span class="keyword">of</span> memory
} <span class="keyword">else</span> <span class="keyword">if</span> (max_mem &gt; <span class="number">0x40000000</span>) {
    max_offset_ret = <span class="number">0x0000000218000000</span>ULL;     <span class="regexp">//</span> <span class="constant">Max</span> offset is <span class="number">8.375</span>GB <span class="keyword">for</span> devices <span class="keyword">with</span> &gt; <span class="number">1</span>GB and &lt;= <span class="number">3</span>GB <span class="keyword">of</span> memory
} <span class="keyword">else</span> {
    max_offset_ret = min_max_offset;
}
</code></pre><p><code>max_offset_ret</code>这个值就代表了我们任务对应的<code>vm_map_t</code>的最大地址范围，比如说这里是8.375GB。</p>
<h3 id="虚拟内存分配的限制">虚拟内存分配的限制</h3><p>好，在说了那么多前置知识后，我们言归正传，来谈谈为什么虚拟内存有限制。</p>
<p>之前我们提到了<code>large_malloc</code>会走入到最后的<code>vm_map_enter</code>，那么我们来看看<code>vm_map_enter</code>的实现：</p>
<pre><code>vm_map_enter(
    <span class="keyword">vm_map_t</span>        <span class="built_in">map</span>,
    <span class="keyword">vm_map_offset_t</span>        *address,    <span class="comment">/* IN/OUT */</span>
    <span class="keyword">vm_map_size_t</span>        size,
    <span class="keyword">vm_map_offset_t</span>        mask,
    <span class="keyword">int</span>            flags,
    <span class="keyword">vm_map_kernel_flags_t</span>    vmk_flags,
    <span class="keyword">vm_tag_t</span>        alias,
    <span class="keyword">vm_object_t</span>        object,
    <span class="keyword">vm_object_offset_t</span>    offset,
    <span class="keyword">boolean_t</span>        needs_copy,
    <span class="keyword">vm_prot_t</span>        cur_protection,
    <span class="keyword">vm_prot_t</span>        max_protection,
    <span class="keyword">vm_inherit_t</span>        inheritance)
{

<span class="preprocessor">#<span class="keyword">if</span> CONFIG_EMBEDDED</span>
    <span class="comment">// 注意点1:检查页的权限</span>
    <span class="keyword">if</span> (cur_protection &amp; VM_PROT_WRITE){
        <span class="keyword">if</span> ((cur_protection &amp; VM_PROT_EXECUTE) &amp;&amp; !entry_for_jit){
            <span class="built_in">printf</span>(<span class="string">"EMBEDDED: %s: curprot cannot be write+execute. "</span>
                   <span class="string">"turning off execute\n"</span>,
                   __FUNCTION__);
            cur_protection &amp;= ~VM_PROT_EXECUTE;
        }
    }
<span class="preprocessor">#<span class="keyword">endif</span> <span class="comment">/* CONFIG_EMBEDDED */</span></span>

    <span class="keyword">if</span> (resilient_codesign || resilient_media) {
        <span class="keyword">if</span> ((cur_protection &amp; (VM_PROT_WRITE | VM_PROT_EXECUTE)) ||
            (max_protection &amp; (VM_PROT_WRITE | VM_PROT_EXECUTE))) {
            <span class="keyword">return</span> KERN_PROTECTION_FAILURE;
        }
    }

    <span class="comment">// 1. 获取任务的可用的地址最小值和最大值</span>
    effective_min_offset = <span class="built_in">map</span>-&gt;min_offset;
    effective_max_offset = <span class="built_in">map</span>-&gt;max_offset;

    <span class="keyword">if</span> (<span class="built_in">map</span>-&gt;pmap == kernel_pmap) {
        user_alias = VM_KERN_MEMORY_NONE;
    } <span class="keyword">else</span> {
        user_alias = alias;
    }

<span class="preprocessor">#<span class="keyword">define</span>    RETURN(value)    { result = value; goto BailOut; }</span>

    assert(page_aligned(*address));
    assert(page_aligned(size));

    <span class="keyword">if</span> (!VM_MAP_PAGE_ALIGNED(size, VM_MAP_PAGE_MASK(<span class="built_in">map</span>))) {
        clear_map_aligned = TRUE;
    }

StartAgain: ;

    start = *address;

    <span class="keyword">if</span> (anywhere) {
        vm_map_lock(<span class="built_in">map</span>);
        map_locked = TRUE;

        <span class="keyword">if</span> (start &lt; effective_min_offset)
            start = effective_min_offset;
        <span class="keyword">if</span> (start &gt; effective_max_offset)
            RETURN(KERN_NO_SPACE);


        <span class="keyword">if</span>( FALSE ) {

        } <span class="keyword">else</span> {

            <span class="keyword">if</span> (<span class="built_in">map</span>-&gt;holelistenabled) {
                hole_entry = (<span class="keyword">vm_map_entry_t</span>)<span class="built_in">map</span>-&gt;holes_list;

                <span class="keyword">if</span> (hole_entry == <span class="literal">NULL</span>) {
                    <span class="comment">/*
                     * No more space in the map?
                     */</span>
                    result = KERN_NO_SPACE;
                    <span class="keyword">goto</span> BailOut;
                } <span class="keyword">else</span> {

                    <span class="keyword">boolean_t</span> found_hole = FALSE;

                    <span class="keyword">do</span> {
                        <span class="keyword">if</span> (hole_entry-&gt;vme_start &gt;= start) {
                            start = hole_entry-&gt;vme_start;
                            found_hole = TRUE;
                            <span class="keyword">break</span>;
                        }

                        <span class="keyword">if</span> (hole_entry-&gt;vme_end &gt; start) {
                            found_hole = TRUE;
                            <span class="keyword">break</span>;
                        }
                        hole_entry = hole_entry-&gt;vme_next;

                    } <span class="keyword">while</span> (hole_entry != (<span class="keyword">vm_map_entry_t</span>) <span class="built_in">map</span>-&gt;holes_list);

                    <span class="keyword">if</span> (found_hole == FALSE) {
                        result = KERN_NO_SPACE;
                        <span class="keyword">goto</span> BailOut;
                    }

                    entry = hole_entry;

                    <span class="keyword">if</span> (start == <span class="number">0</span>)
                        start += PAGE_SIZE_64;
                }
            }
        }

        <span class="keyword">while</span> (TRUE) {
            <span class="keyword">vm_map_entry_t</span>    next;

            end = ((start + mask) &amp; ~mask);
            end = vm_map_round_page(end,
                        VM_MAP_PAGE_MASK(<span class="built_in">map</span>));

            <span class="keyword">if</span> (end &lt; start)
                RETURN(KERN_NO_SPACE);

            start = end;
            end += size;

            <span class="keyword">if</span> ((end &gt; effective_max_offset) || (end &lt; start)) {
                RETURN(KERN_NO_SPACE);
            }

            next = entry-&gt;vme_next;

            <span class="keyword">if</span> (<span class="built_in">map</span>-&gt;holelistenabled) {
                <span class="keyword">if</span> (entry-&gt;vme_end &gt;= end)
                    <span class="keyword">break</span>;
            } <span class="keyword">else</span> {

                <span class="keyword">if</span> (next == vm_map_to_entry(<span class="built_in">map</span>))
                    <span class="keyword">break</span>;

                <span class="keyword">if</span> (next-&gt;vme_start &gt;= end)
                    <span class="keyword">break</span>;
            }

            entry = next;

            <span class="keyword">if</span> (<span class="built_in">map</span>-&gt;holelistenabled) {
                <span class="keyword">if</span> (entry == (<span class="keyword">vm_map_entry_t</span>) <span class="built_in">map</span>-&gt;holes_list) {
                    result = KERN_NO_SPACE;
                    <span class="keyword">goto</span> BailOut;
                }
                start = entry-&gt;vme_start;
            } <span class="keyword">else</span> {
                start = entry-&gt;vme_end;
            }

            start = vm_map_round_page(start,
                          VM_MAP_PAGE_MASK(<span class="built_in">map</span>));
        }

        <span class="keyword">if</span> (<span class="built_in">map</span>-&gt;holelistenabled) {
            <span class="keyword">if</span> (vm_map_lookup_entry(<span class="built_in">map</span>, entry-&gt;vme_start, &amp;entry)) {
                panic(<span class="string">"Found an existing entry (%p) instead of potential hole at address: 0x%llx.\n"</span>, entry, (<span class="keyword">unsigned</span> <span class="keyword">long</span> <span class="keyword">long</span>)entry-&gt;vme_start);
            }
        }

        *address = start;
    } 
</code></pre><ul>
<li>注意点1：基本上就是检查页的权限啥的，iOS上不允许可写和可执行并存。</li>
<li>剩下的就是作各种前置检查</li>
</ul>
<p>老实说，我一开始看苹果这最新的XNU代码，我压根没读懂。这一堆<code>hole</code>啥的在干啥，后来我就往之前XNU版本翻了翻，果然好懂了很多：</p>
<pre><code>entry = <span class="built_in">map</span><span class="subst">-&gt;</span>first_free;

<span class="keyword">if</span> (entry == vm_map_to_entry(<span class="built_in">map</span>)) {
    entry = <span class="built_in">NULL</span>;
} <span class="keyword">else</span> {
       <span class="keyword">if</span> (entry<span class="subst">-&gt;</span>vme_next == vm_map_to_entry(<span class="built_in">map</span>)){
            entry = <span class="built_in">NULL</span>;
       } <span class="keyword">else</span> {
            <span class="keyword">if</span> (start &lt; (entry<span class="subst">-&gt;</span>vme_next)<span class="subst">-&gt;</span>vme_start ) {
                start = entry<span class="subst">-&gt;</span>vme_end;
                start = vm_map_round_page(start,
                              VM_MAP_PAGE_MASK(<span class="built_in">map</span>));
            } <span class="keyword">else</span> {
                entry = <span class="built_in">NULL</span>;
            }
       }
}

<span class="keyword">if</span> (entry == <span class="built_in">NULL</span>) {
    vm_map_entry_t    tmp_entry;
    <span class="keyword">if</span> (vm_map_lookup_entry(<span class="built_in">map</span>, start, <span class="subst">&amp;</span>tmp_entry)) {
        assert(<span class="subst">!</span>entry_for_jit);
        start = tmp_entry<span class="subst">-&gt;</span>vme_end;
        start = vm_map_round_page(start,
                      VM_MAP_PAGE_MASK(<span class="built_in">map</span>));
    }
    entry = tmp_entry;
}
</code></pre><ul>
<li><p>整个这段代码的意思是，就是要我们要找个一个比我们这个<code>start</code>地址大的<code>vm_entry_t</code>。(这句话比较绕口)，<b style="color:red">我们最终的目的是为了在两个已经存在<code>vm_entry_t</code>之间尝试插入一个能包含从<code>start</code>到<code>start + size</code>的新的<code>vm_entry_t</code></b></p>
</li>
<li><p>如果没找到的话，就尝试利用<code>vm_map_lookup_entry</code>找一个<code>preceding</code>我们地址的的<code>vm_entry_t</code>。</p>
</li>
</ul>
<p>好，现在我们找到了一个满足<code>start</code>其实地址条件的<code>vm_entry_t</code>了，剩下就是要满足分配大小<code>size</code>的需求了。</p>
<pre><code><span class="label">while</span> (TRUE) {
    register vm_map_entry_t    next<span class="comment">;</span>

    <span class="preprocessor">end</span> = ((start + mask) &amp; ~mask)<span class="comment">;</span>
    <span class="preprocessor">end</span> = vm_map_round_page(<span class="preprocessor">end</span>,
                VM_MAP_PAGE_MASK(<span class="preprocessor">map</span>))<span class="comment">;</span>
    <span class="preprocessor">if</span> (<span class="preprocessor">end</span> &lt; start)
        RETURN(KERN_NO_SPACE)<span class="comment">;</span>

    start = <span class="preprocessor">end</span><span class="comment">;</span>
    <span class="preprocessor">end</span> += size<span class="comment">;</span>

    <span class="preprocessor">if</span> ((<span class="preprocessor">end</span> &gt; effective_max_offset) <span class="title">||</span> (<span class="preprocessor">end</span> &lt; start)) {
        RETURN(KERN_NO_SPACE)<span class="comment">;</span>
    }

    next = <span class="preprocessor">entry</span>-&gt;vme_next<span class="comment">;</span>

    // 如果是空的头
    <span class="preprocessor">if</span> (next == vm_map_to_entry(<span class="preprocessor">map</span>))
        <span class="keyword">break;
</span>
    // 如果下一个的start 
    <span class="preprocessor">if</span> (next-&gt;vme_start &gt;= <span class="preprocessor">end</span>)
        <span class="keyword">break;
</span>
    <span class="preprocessor">entry</span> = next<span class="comment">;</span>
    start = <span class="preprocessor">entry</span>-&gt;vme_end<span class="comment">;</span>
    start = vm_map_round_page(start,
                  VM_MAP_PAGE_MASK(<span class="preprocessor">map</span>))<span class="comment">;</span>
}
*<span class="keyword">address </span>= start<span class="comment">;</span>
<span class="label">assert</span>(VM_MAP_PAGE_ALIGNED(*<span class="keyword">address,
</span>               VM_MAP_PAGE_MASK(<span class="preprocessor">map</span>)))<span class="comment">;</span>
</code></pre><p>这段代码相对来说就很简单了，我们判断<code>start + size</code>是不是可以正好插入在<code>vm_entry_t</code>代表的地址范围的空隙内，如果一直遍历到最后的任务地址上限都找不到，那就说明不存在我们需求的连续的虚拟内存空间用于作分配了。</p>
<h3 id="其他">其他</h3><p>除了本文说明的虚拟内存分配的连续性限制以外，虚拟内存作为堆内存分配的一种，在布局范围上也有限制。此文不表，且听下回分解。</p>
]]></content>
    <summary type="html">
    <![CDATA[<p>XNU之二和之三两篇由于涉及的量过大，就不发了，当然本文我也删除了一定的内容，哈哈哈。</p>
<p><b style="color:red">欢迎加入我们<strong>手淘／天猫的架构组</strong>来内网阅读</b></p>
<p>提起iOS的内存管理，大多数人第]]>
    </summary>
    
      <category term="XNU" scheme="http://satanwoo.github.io/tags/XNU/"/>
    
      <category term="iOS" scheme="http://satanwoo.github.io/tags/iOS/"/>
    
  </entry>
  
</feed>